qwen3.8-27b-ninfer-5070tilaptop-kvmem-local-agent
Health Warn
- License — License: Apache-2.0
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 5 GitHub stars
Code Pass
- Code scan — Scanned 12 files during light audit, no dangerous patterns found
Permissions Pass
- Permissions — No dangerous permissions requested
No AI report is available for this listing yet.
RTX 5070 Ti Laptop 12GB 跑 Qwen3.8-27B:NInfer + KVMem、256K 逻辑上下文、RAM KV、MTP、快速缓存续接与 dsh 本地 Agent / 搜索 / 浏览器。含源码、Windows 部署及实测。
NInfer 5070 Ti Laptop 12GB|Qwen3.8-27B · 256K KVMem · 本地 AI Agent



在 RTX 5070 Ti Laptop 12GB 上运行 Qwen3.8-27B:KVMem 长上下文、RAM 历史 KV、MTP 投机解码,以及可选的 dsh 本地 Agent、免费联网搜索和浏览器工具。
这是基于 NInfer-all、NInfer 与沈三殊 KVMem 方案的 Windows 优化发行版,由 CSUNX233 维护。基础引擎、模型与量化技术属于各自上游;本仓库公开整合源码、本机修复、部署脚本和验证证据。完整来源与许可证 →
特别感谢:Bilibili UP 主 0xFFFF7
本项目所用的基础架构,下载自 Bilibili 的 0xFFFF7 提供的版本;此前遇到的死循环问题也是由他解决的。 感谢他的基础工作、修复与分享。这里继续公开本机后续适配和部署成果,也保留 NInfer、KVMem、Qwen、ISTA-DASLab 及其他上下游贡献者的归属。
256K 是配置的逻辑上下文容量。 已完成128K / 200K合成召回、生成历史与工具续接验证;6144档128K为5/5,200K为4/5,尚未跑满256K整模型压力测试。KVMem在长历史中选择部分页面参与注意力,不等同于全长稠密注意力。
维护者反馈200K日常使用稳定,重复任务更快。 工程测试进一步记录了6144档200K首次预填充424.62秒、完全重复112毫秒;冷预填充仍随长度增加而变慢,不能将日常观察理解为任何阶段都不降速。建议使用 xhigh 思考,启动预设与 dsh 默认均已配置。
强烈建议:针对 NInfer 禁用 CUDA 系统内存自动回退。 在 NVIDIA 控制面板的“管理 3D 设置 → 程序设置”中,添加本项目的
runtime/engine/ninfer-serve.exe,将 CUDA - Sysmem Fallback Policy 设为 Prefer No Sysmem Fallback。只设置该程序,保留全局设置。显存不足时驱动回退到 RAM 可能造成明显降速;本项目的 7 GiB Host KV 是引擎主动管理的 RAM 缓存,仍需保留。禁用驱动回退不会增加显存,不足时仍可能报错,启动前需预留显存。详细设置与排障 →
v0.1.2:补全生成历史索引,保护缓存问句续接
下载v0.1.2。发布当前已验证引擎:普通decode / MTP只索引主模型实际提交的历史;缓存问句在有新增历史的合法恢复时重评分,恰好到问句末尾的完全重复请求保留原排名。非评分分块融合QK norm + RoPE与旋转前K采集。
部署先从较小完整组合 36864页池 / 3840检索 起步,清理显存,通过短任务、缓存和工具续接后再逐档加大。 维护者的39168 / 6144是进阶档,CUDA启动余量约84MiB;128K首次/重复5/5,200K均4/5。64K三任务六工具调用续接约396–679ms,加权decode84.11tok/s。没有宣称全长全召回或整体提速。实测与边界 · 部署顺序 · Agent部署提示词
v0.1.1:修复检索上下文和工具续接(前一版)
下载 v0.1.1。修复长/短会话切换及缓存恢复时可能沿用其他上下文的检索索引;索引与排名随缓存检查点恢复,修正非对齐页追加、重复累加和缺失页计数。同步公开截图后的进度续接与取消透传补丁。
实测 62K 输入 → 累计 43,775 tokens 生成 → 工具调用 → 三轮续接,工具结果只新算 52 tokens,TTFT 915 ms,随后三轮 382–411 ms。没有新增 GPU buffer,xhigh、采样、MTP 和检索预算保持原样;新增索引快照使用 RAM。单次 49K 冷输入约慢 3%,不宣称整体提速;满 256K 压力及原 177K 截图任务行为尚未重放。优化、对照与边界 · 已有安装升级
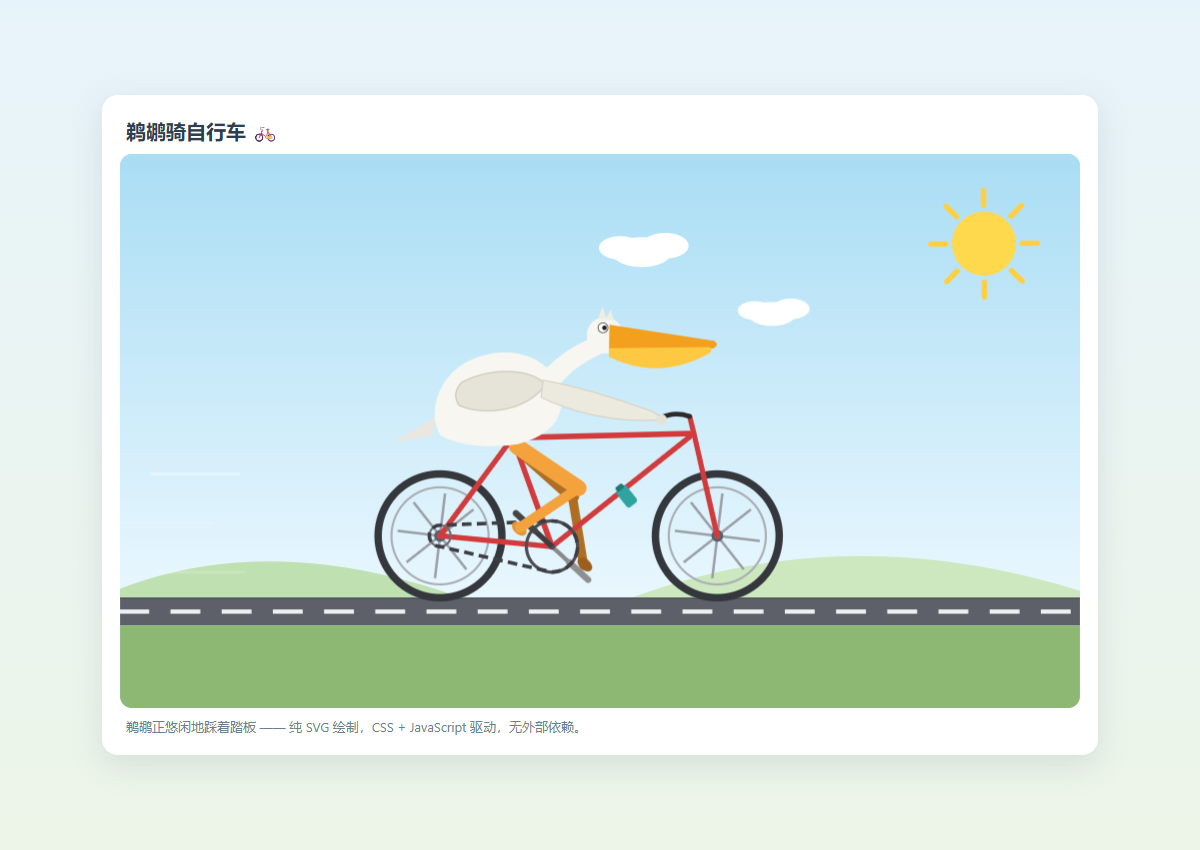
实际作品:鹈鹕骑自行车,约 7 分钟
维护者使用本机模型生成的单文件动画,报告耗时约 7 分钟,HTML 原文件保持原样。纯 SVG + CSS + JavaScript,无外部依赖;这是一个实际生成样例,不是能力榜单分数或解码测速。
为什么值得试
- 12GB 笔记本运行 27B 模型。 使用 GSQ-RCO IQ3_XXS 权重、rk4v4 KV、36K GPU 页池和 7 GiB Host KV;历史 KV 保存在 RAM,按需调入。
- 长上下文保留快速续接。 修复大缓存接管的页预算、尾页写时复制与异步生命周期;一次 84,925-token 工具续接命中 84,873 tokens,仅新算 52 tokens,预填充约 814 ms。
- 显存留给模型。 检索索引从 GPU 移到 RAM,使用双缓冲预取;256K 索引约 256.25 MiB,GPU scratch 共 32 MiB,相对原 GPU 索引净省约 224.25 MiB。
- 为这张卡实测调度。 46 SM / cc1200 的指定 IQ2_S、IQ3_XXS、Q2_K 小矩阵路线;固定短任务两轮 A/B 总解码吞吐约 +2.44%,已有算子与输出一致性检查。
- 可选的完整本地 Agent。 dsh 网页、严格缓存守卫、工具结果裁剪优化、待办收尾提醒;新增工具验证与分步执行规则,引导模型在下一步明确时读取、实现、测试,保留 xhigh 和必要的深入思考。本地执行网页搜索/读取,Edge 浏览器按需启动,不要求付费搜索 API。接入、开关与验证 →
- 可选 CPU 视觉。 视觉编码可全部放 CPU,文字推理继续使用 GPU;图片首次编码明显增加延迟。视觉实测 →
实测速览
硬件:RTX 5070 Ti Laptop 12GB / i7-14650HX / 32GB RAM / Windows / NVIDIA 617.14。CUDA 13.0.48,MSVC 14.44.35207。模型为 Qwen3.8-27B-GSQ-RCO-IQ3_XXS-mtp 转换的 .ninfer。不同任务的投机接受率、功耗和缓存状态会改变结果。
| 工作负载 | 结果 | 测量边界 |
|---|---|---|
| 短写作 / 代码 / 缓存重复 | 新调度约 65–85 token/s | 各类两轮均值;temperature=0,seed=1234,关闭思考 |
| 62,002 tokens 冷输入 | 预填充 557 token/s,解码 76.87 token/s | 新版单次;旧版预填充 571.86、解码 71.97 |
| 110,019 tokens 冷输入 | 预填充约 620 token/s,解码 69.28 token/s | 较早优化阶段的单次记录 |
| 约 85K 历史工具续接 | 仅重算 52 tokens,预填充 813.5 ms,TTFT 1,234 ms | 前一轮正常生成 22,528 tokens |
| 随后三轮短续接 | TTFT 313–445 ms | 验证码全部正确;小样本 |
| v0.1.1:106K 历史工具结果续接 | 仅新算 52 tokens,TTFT 915 ms | 累计生成 43,775 tokens 后;后续三轮 382–411 ms |
| 本轮 GPU 峰值 | 约 11,120–11,124 MiB | 分项轮询测量,不能排除瞬时峰值 |
这不是所有场景的保底速度。 最新调度优化没有证明预填充或 TTFT 普遍变快;原版与新版的完整对照、质量验证和局限见 实测报告。重复文本触发近乎全接受的 221 token/s 不作为普通 Agent 速度宣传。
后续可能的优化
动态 / 自适应 MTP 也许能继续提升 decode 速度,目前未在本机做对照验证,默认未启用。 它需要根据接受率调整草稿宽度,并核对额外验证计算、页预算和 CUDA Graph 成本;不能预先承诺收益或质量等价。当前优化范围
下载与运行
交给自己或 Agent 部署前,先读 部署与维护交接手册:包含可复制的 Agent 提示词、关键组件版本、显存准备、启动设置、分层验收、实际踩坑及处理办法。
- 下载仓库源码 ZIP,解压到 D 盘等空间充足的位置;或使用下面的 Git 命令。
- 准备 Windows x64、可用的 RTX 5070 Ti Laptop 12GB、32GB RAM、Node.js 24+、x64 VC++ 运行库,以及兼容 CUDA 13 的 NVIDIA 驱动。
- 准备带 MTP 的 v3
.ninfer模型。模型来源、精确文件与转换步骤 → 权重不包含在本仓库或 Release 中。 - 在项目目录执行:
git clone https://github.com/CSUNX233/qwen3.8-27b-ninfer-5070tilaptop-kvmem-local-agent.git
cd qwen3.8-27b-ninfer-5070tilaptop-kvmem-local-agent
powershell -NoProfile -ExecutionPolicy Bypass -File .\setup.ps1 -ModelPath "D:\Models\qwen3.8-27b-gsq-rco-iq3-xxs.ninfer"
.\start.cmd
setup.ps1 从 Release 下载引擎,从 NVIDIA/BtbN 下载固定版本依赖,逐项核验 SHA-256,再安装固定版本 dsh。下载、缓存、会话与日志留在本项目目录。启动后自动打开带本机登录凭据的网页;关闭时运行 stop.cmd。
只用 API:安装时加 -SkipDsh,启动时执行 powershell -ExecutionPolicy Bypass -File .\start.ps1 -EngineOnly。
| 接口 | 默认地址 |
|---|---|
| OpenAI 兼容 API | http://127.0.0.1:1234/v1 |
| dsh 使用的缓存守卫 | http://127.0.0.1:1236/v1 |
| dsh 网页 | http://127.0.0.1:3080;实际登录 URL 在本地日志 |
| 健康检查 | http://127.0.0.1:1234/health |
同时支持 /v1/chat/completions、/v1/responses 和 /v1/messages 等接口;具体兼容范围见 引擎服务文档。安装与排障 · 从源码编译
使用条件与边界
- 明确实测可用:RTX 5070 Ti Laptop 12GB。 本机已经稳定完成长任务与日常 Agent 使用;这是本仓库直接验证的设备。
- 推荐独显 + 核显混合模式。 桌面、网页和浏览器渲染尽量交给核显,独显显存留给推理引擎。当前启动预设按这种使用方式整理,脚本不会自动切换系统显卡模式。没有核显或混合模式也可以尝试,但启动前应关闭不需要的 GPU 程序和后台进程,预留足够显存。
- 其他 RTX 50 系、12GB 及以上显存的显卡欢迎尝试。 当前参数和预编译包以本机为准,尚未逐卡验证;非 50 系显卡需针对自己的 CUDA 架构重新编译,并调整显存预算。欢迎通过 Issue / PR 补齐其他显卡的编译方法、参数和实测结果。
- 代码以 Apache-2.0 开源;可以下载、修改、再分发和商用,须保留适用许可证、归属及修改说明。第三方目录、dsh 和外部运行库分别遵守各自许可;模型权重另遵守模型仓库条款。
- 预编译引擎为 Windows x64 / sm120a;主要验证设备就是 RTX 5070 Ti Laptop。其他显卡需要自行编译、调参和验证,不能直接套用速度或显存承诺。
- 该预设接近 12GB 显存预算;其他 GPU 程序和独显直连桌面可能影响启动。脚本不修改全局代理、驱动策略或其他程序的 GPU 设置。
- 长历史中段通过检索选择页面,保存了历史 KV 不代表每次生成都读取全部历史;检索预算、量化、原模型能力都会影响召回和回答质量。本轮调度优化保持既有权重、量化和检索预算;已通过的检查不等同于完整能力评测。
- 只有相同 token 前缀才能复用缓存;改写历史、删思考、换模板或压缩会使变化部分重新计算。
- 搜索和浏览器后端在本机执行,访问互联网仍需网络。无付费 API 不等于离线搜索;网站验证码、限流和页面变化可能导致工具失败。
- 默认单并发、回环地址,本项目按个人本地部署提供。女娲及人物技能不会自动安装或启用。
项目导航
| 内容 | 位置 |
|---|---|
| 引擎完整源码与原上游说明 | engine/ |
| 本机修复与优化说明 | MODIFICATIONS.md |
| 固定版本安装、启动与关闭 | setup.ps1 / start.cmd / stop.cmd |
| 给部署者与 Agent 的交接手册 | DEPLOYMENT_AGENT_GUIDE.md |
| dsh、搜索、浏览器与缓存守卫 | integrations/ |
| 实测数据与复现方法 | benchmarks/ · 报告 |
| 上下游、许可证、署名 | UPSTREAM_DOWNSTREAM.md · NOTICE |
English: A Windows NInfer + KVMem distribution tuned on an RTX 5070 Ti Laptop 12GB: local Qwen3.8-27B IQ3_XXS inference, 256K configured logical context, RAM-backed KV, MTP speculative decoding, fast cached tool continuations, and optional DeepSeek Harness Agent/search/browser integration. Tested at 110K input and 62K+44K multi-turn continuation; full 256K end-to-end stress is pending. See English overview.
Keywords: RTX 5070 Ti Laptop · 12GB VRAM · Qwen 27B · Qwen3.8 · NInfer · KVMem · long context · speculative decoding · local LLM · local AI agent · DeepSeek Harness · Windows CUDA · 本地大模型 · 长上下文 · 笔记本推理。
Reviews (0)
Sign in to leave a review.
Leave a reviewNo results found