yaya-skills
Health Warn
- License — License: MIT
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 6 GitHub stars
Code Pass
- Code scan — Scanned 12 files during light audit, no dangerous patterns found
Permissions Pass
- Permissions — No dangerous permissions requested
No AI report is available for this listing yet.
Agent Skills 把 X Space 变成中文干货笔记:下载 → 带说话人转写 → LLM 蒸馏 → 分享图 / Turn X Spaces into distilled Chinese notes with speaker labels & share cards.
yaya-skills
English | 简体中文
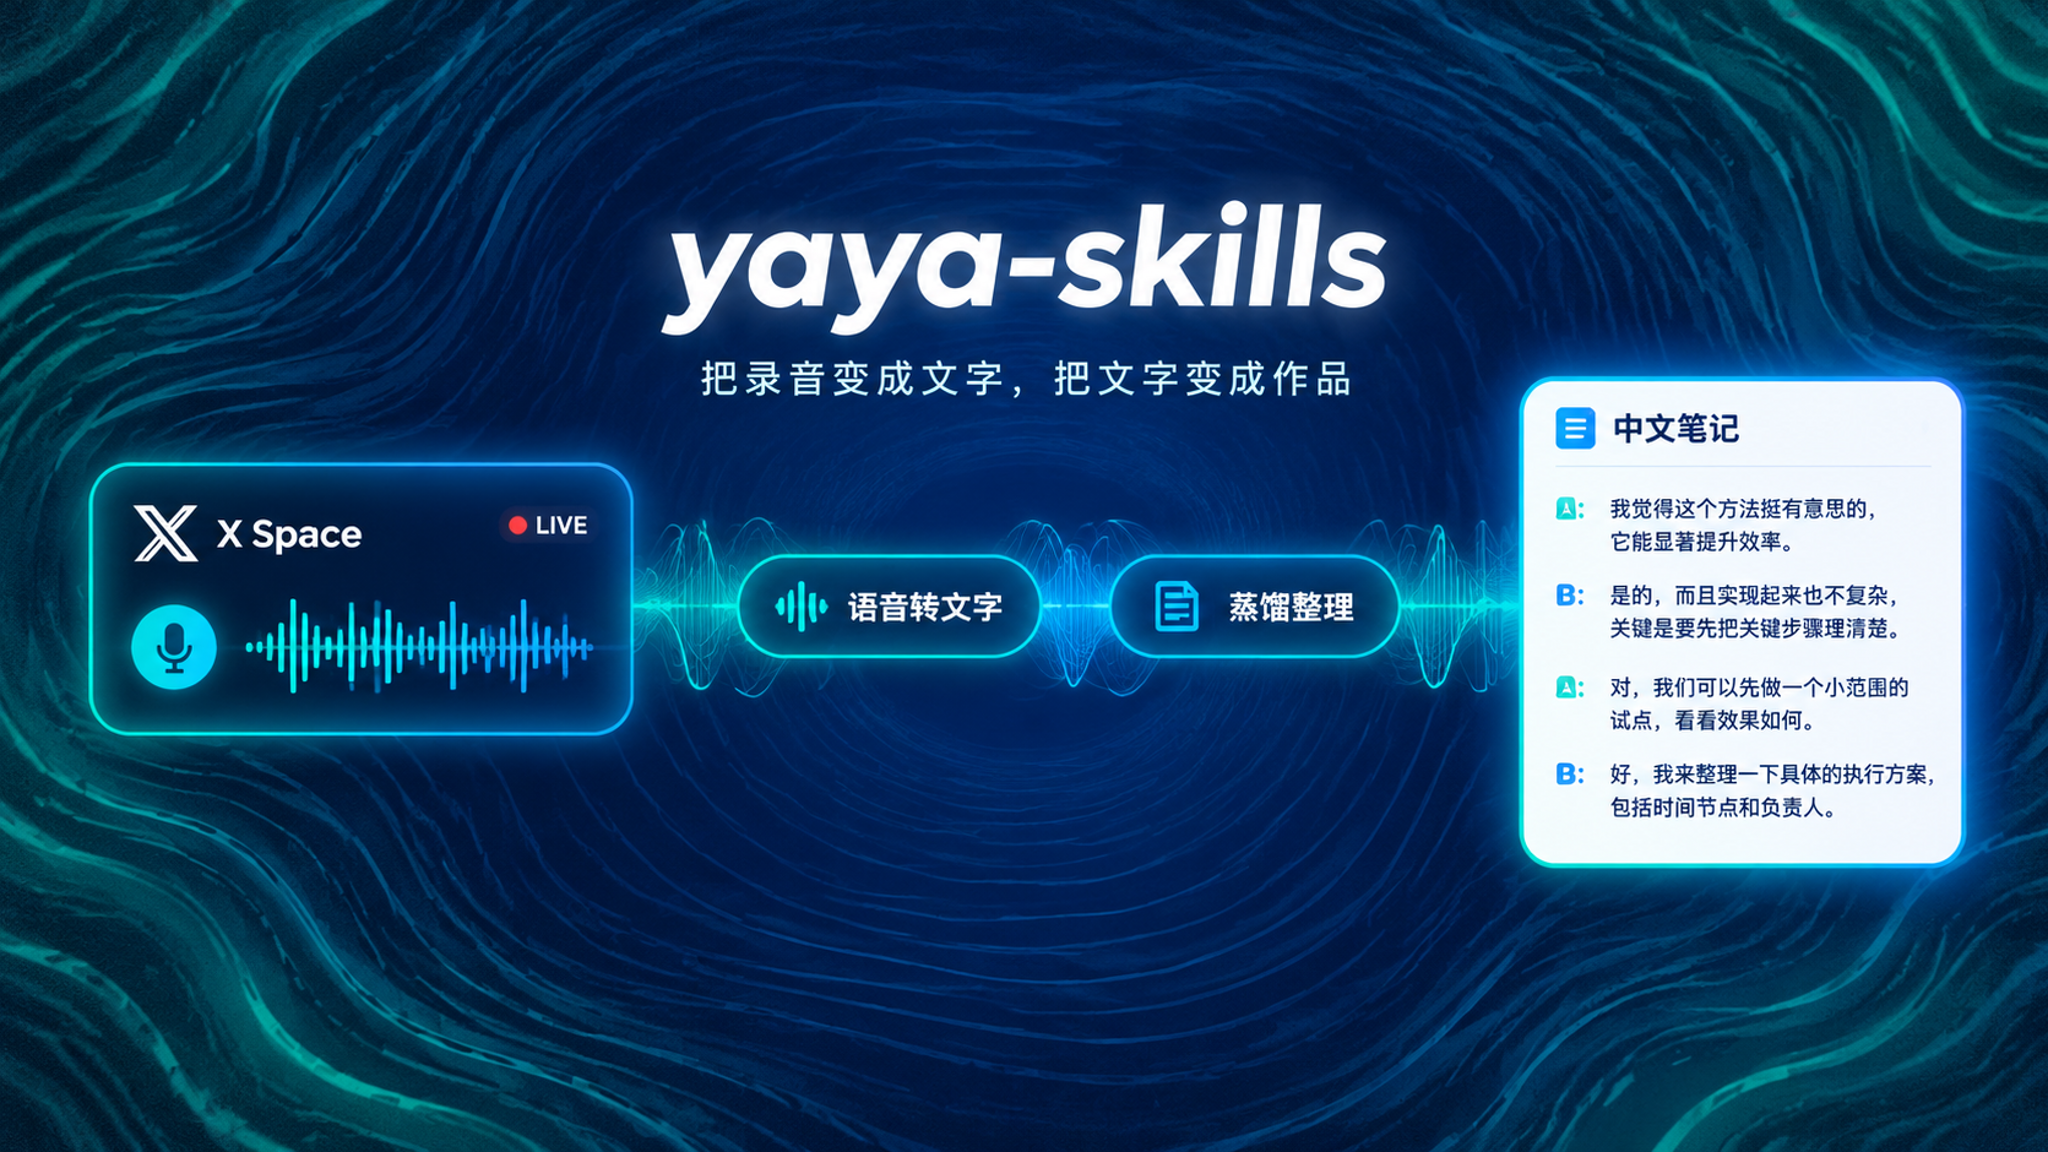




首期主打:X Space 录音转文字。 给没时间听、或忘了听的人——一条链接,一场两小时的 Space 变成按说话人分组、金句原话全保留的中文干货笔记,外加一张可直接发出去的分享图。
yaya-skills 是一套帮助写作者提高效率的工具集合。第一期是 X Space 蒸馏提纯器(yaya-xspace):把没时间听、或忘了听的 Space 提纯成能直接用的干货笔记,背后由下载 / 转写 / 分离三个原子 skill 支撑;后续会增加更多为写作者提效的工具。音频全程不出本机。
快速开始(主打场景)
bash skills/yaya-xspace/run.sh "https://x.com/i/spaces/<13位ID>"
# → skills/yaya-xspace/out/<id>/distilled.md
首次运行自动下载模型;两小时的场约 30 分钟出稿(GPU 转写与说话人分离并行跑)。
看个真实效果(Demo)
《噪音之后:为什么做IP一定要有自己的"理论"》——一场真实 Space 的完整产出(119 分钟 / 10 位说话人,聊 IP、人设与流量变现):
| 产出 | 看什么 |
|---|---|
| distilled.png | ★ 一张图版:笔记自动渲染成的分享图,可直接发推 |
| distilled.md | ★ 最终干货笔记:一句话总结 / 核心结论 / 各说话人核心发言 / 关键名词总表 / 争议与分歧 / 可行动项 |
| 带说话人对话稿(节选) | 中间产物:从音频到"谁说了什么"(完整稿 29,930 字 / 10 位说话人) |
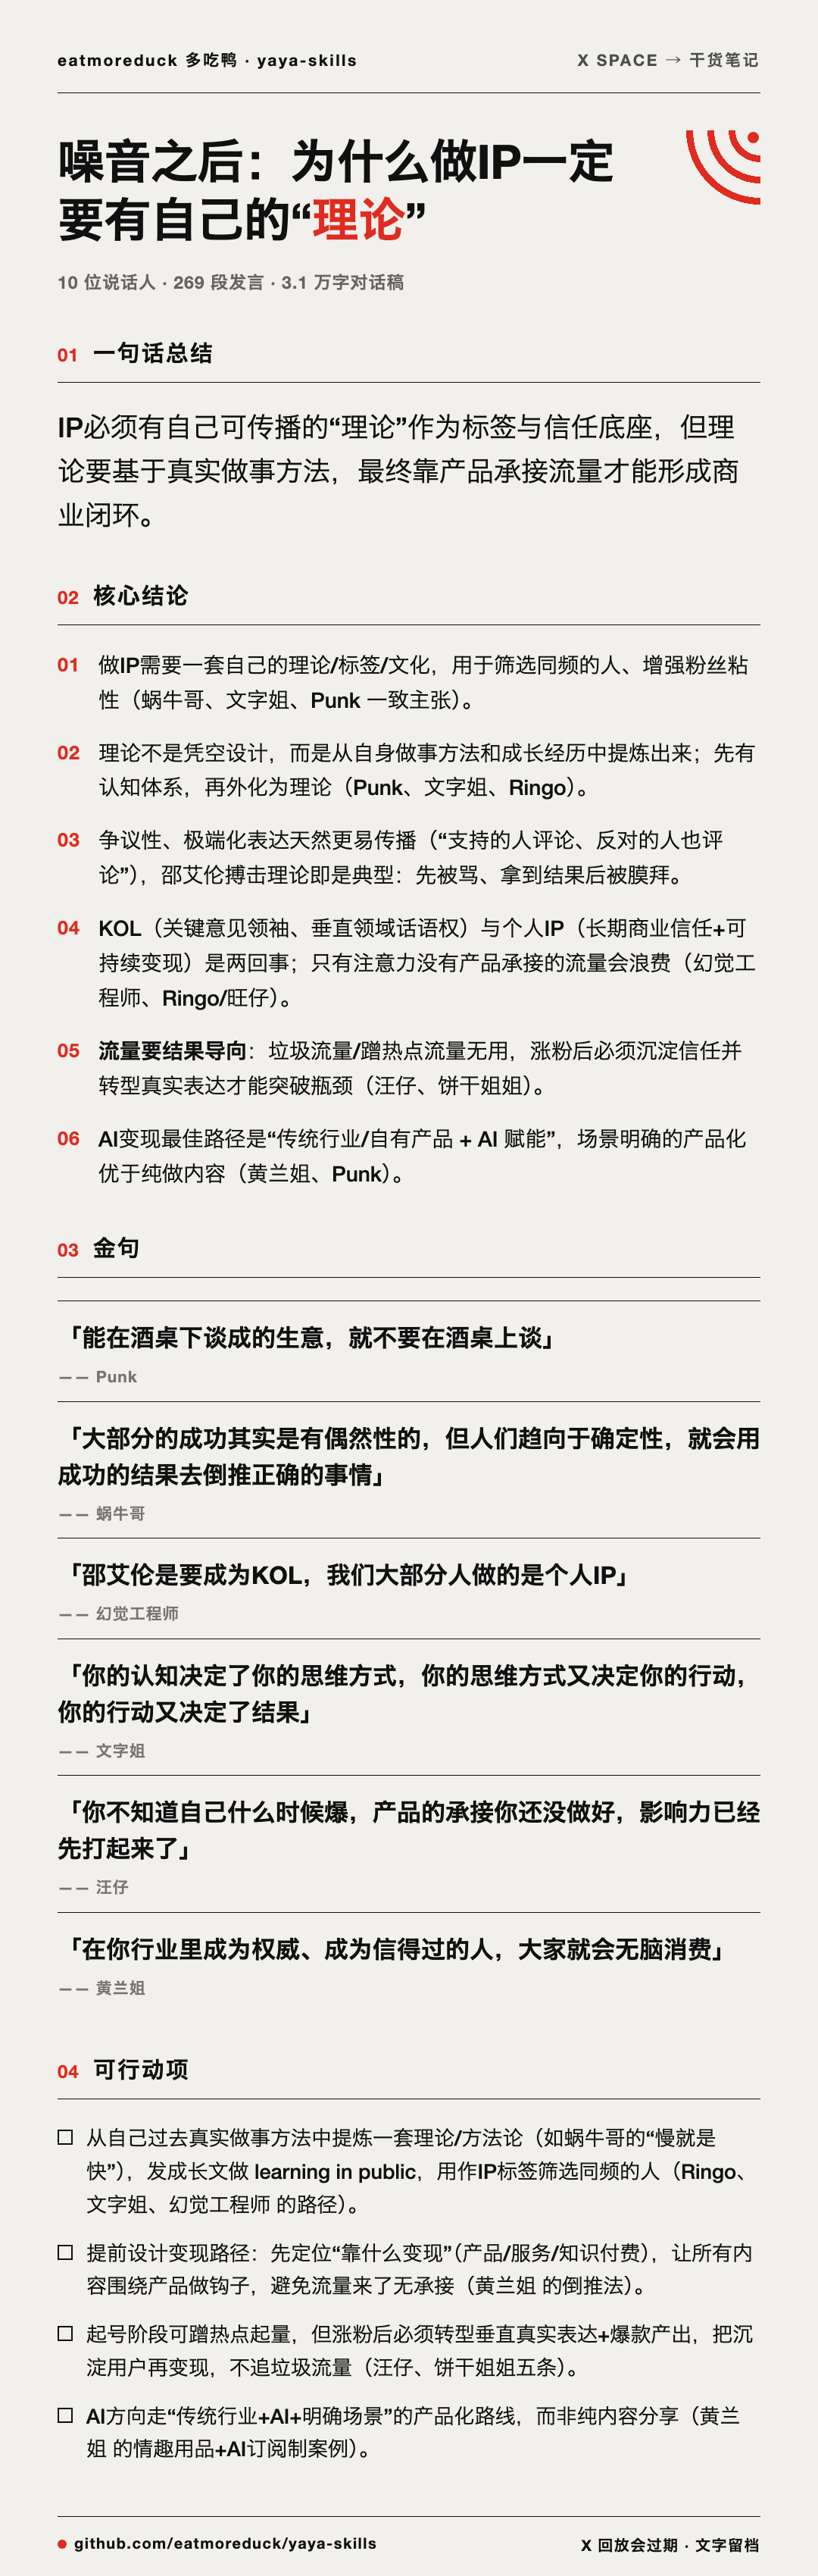
分享图内置四种卡面,生成时 --style 切换(下列名称可直接点开看整图):
- Swiss 国际风(默认)——白底、重磅黑体、红色声波弧、细线网格
- Editorial 杂志风——米色宋体、朱红方块、新闻纸质感
- Riso 丝印潮风——蓝橙套印错位、网点、抓眼球
- Midnight 夜读——暗底鎏金细线、宋体,高级感
119 分钟音频 → 29.5 分钟出笔记 + 一张分享图(GPU 转写与 CPU 分离全程并行)。源 Space ID:
1AKEmvYqbrOKL。X 回放 30 天后失效——文字产出留档在本仓库,音频留在本地out/。另有一款手绘实验款hand(--style hand)。
定位
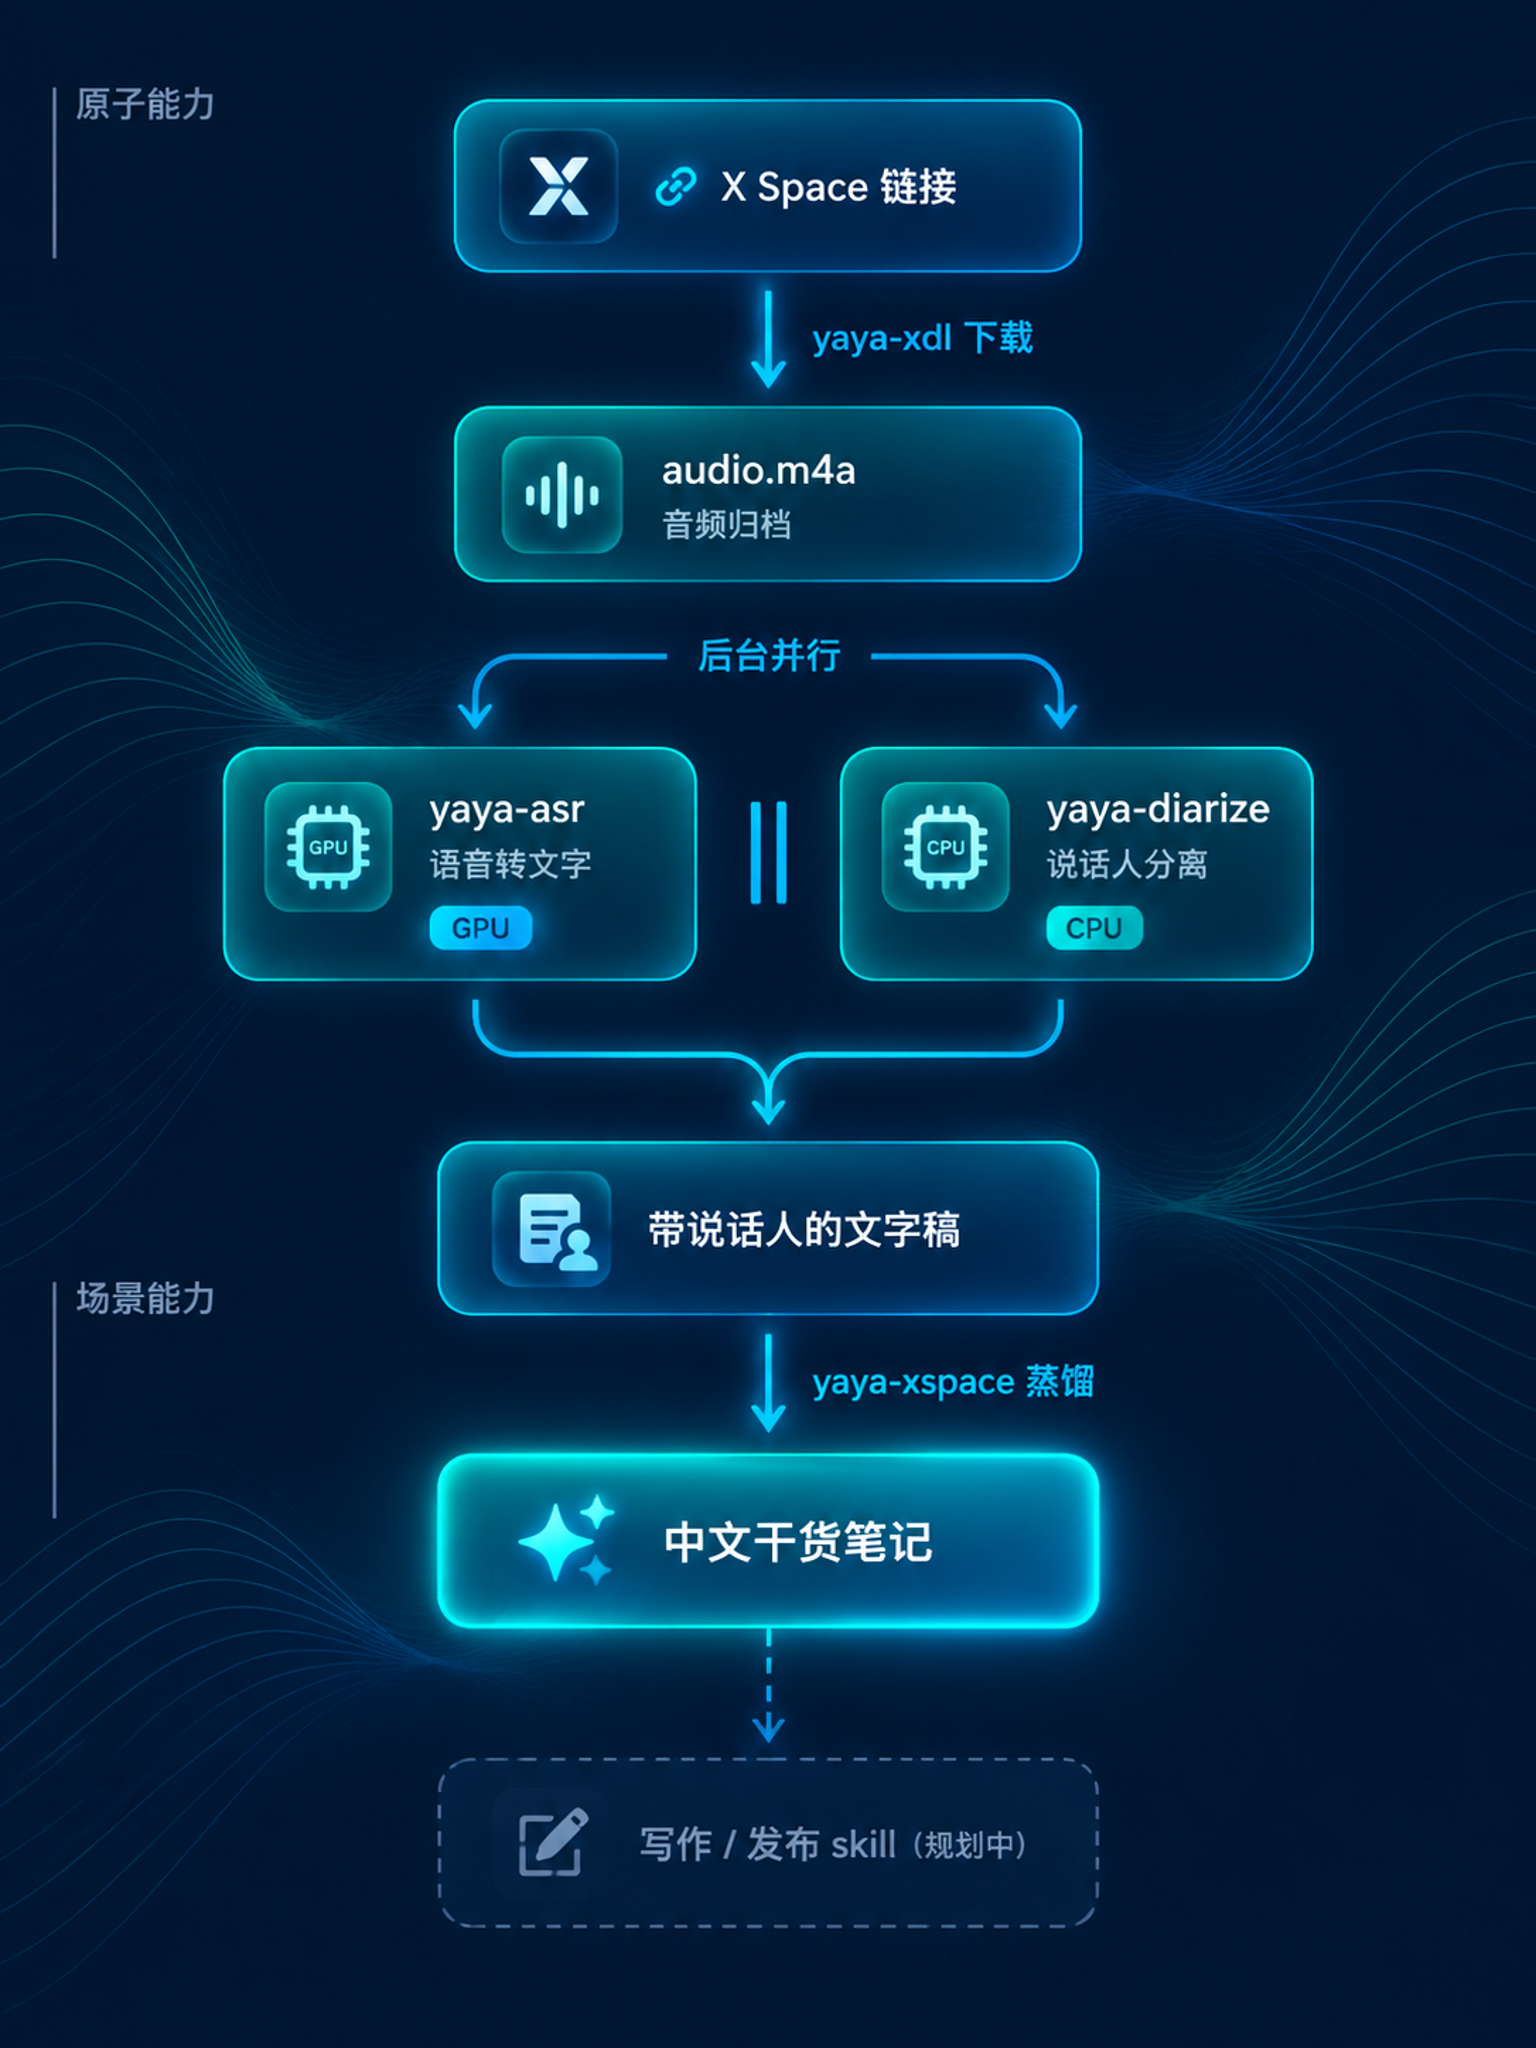
分层原则:上层依赖下层,依赖单向。
- 原子能力互不依赖:
yaya-xdl只管下载——Space 链接进,audio.m4a 出(下载即归档);yaya-asr只管转写——音频进,带说话人的文字出;yaya-diarize只管分离——音频进,"谁在何时说话"的时间线出。都不带业务概念。 yaya-asr内部是流水线:转写(MLX/GPU)一开始就后台拉起分离(yaya-diarize,CPU),两者并行执行,互不争抢。yaya-xspace是场景编排:把 xdl 和 asr 串起来,再加自己的蒸馏,产出干货笔记。每个环节只通过兄弟 skill 的run.sh调用,不重复实现。
这样拆的好处很直接:只想存音频的用 yaya-xdl;只想分说话人的用 yaya-diarize;要文字稿的用 yaya-asr;只有 X Space 一条龙才需要 yaya-xspace。
📐 内部实现与性能实测见 TECHNICAL.md:模型清单、缓存机制、并行设计、每阶段耗时(119 分钟音频 → 29.3 分钟出稿)。
为什么做这个
好内容先得存住,才谈得上加工。 X 不提供 Space 归档或搜索,回放 30 天即删——下载即归档,否则那段语音永久消失。
本地跑还有个好处:免费、零登录、不需要任何云端账号。
已收录
主打(场景 skill)
| Skill | 说明 |
|---|---|
| yaya-xspace | X Space 链接 → 中文干货笔记(金句原话 / 关键名词 / 枚举清单全保留) |
支撑(原子 skill,组成上面的流水线,也可单独用)
| Skill | 说明 |
|---|---|
| yaya-xdl | X Space 链接 → audio.m4a(下载即归档) |
| yaya-asr | 任意音频/视频 → 带说话人的文字(转写∥分离自动并行) |
| yaya-diarize | 音频 → 说话人时间线 turns.json(谁在何时说话) |
Roadmap
- ✅ 第一波:X Space → 干货笔记(上面这条流水线)
- 🔜 后续:更多帮写作者提效的工具
模型(首次运行自动下载,无需手动准备)
| 模型 | 用途 | 体积 | 存放位置 | 下载源 |
|---|---|---|---|---|
| whisper-large-v3-turbo(MLX 版) | 语音转写 | ~1.5GB | ~/.cache/huggingface/(全局共享) |
HuggingFace |
| pyannote 分割 + CAM++ 中文声纹 | 说话人分离 | ~33MB | skills/yaya-asr/models/(已 gitignore) |
GitHub Releases |
- 两个模型都免 HF token,首次跑对应 skill 时自动下载,之后重跑不重复下载。
- 下载 Whisper 需要能访问 HuggingFace;网络不稳可提前设镜像:
export HF_ENDPOINT=https://hf-mirror.com。 - 磁盘敏感的话注意:大头是那 1.5GB 的转写模型,分离模型只有 33MB。
数据放哪(产物与归档)
数据跟着 skill 走:产物、音频归档、缓存全部落在 skill 自己的 out/ 里,删 skill 目录 = 删数据,git pull 更新也不影响(out/ 已 gitignore)。
skills/yaya-xspace/out/<space-id>/   ← 一场 Space 一个目录,一切都在里面
├── audio.m4a                        音频归档(默认保留——下载即归档)
├── distilled.md                     ★ 干货笔记
├── audio.labeled.json / audio.dialog.txt / …   转写产物
└── .audio.asr/                      中间缓存(删掉只损失重算时间)
- 删一场 = 删一个目录;不想要音频加
--no-keep-audio。 - ⚠️
out/是你的私人数据(笔记+音频),已在.gitignore里——永远不会被 git 提交上去。(demo/是手工挑选、随仓库公开的样例,与 out/ 无关。)
安装
skill 是通用的 Markdown+脚本格式(Agent Skills 规范),不绑定任何一家 Agent——Claude Code、Codex、Cursor、Windsurf、ZCode 等所有支持该规范的 Agent 都能装能用。
# 方式一:插件市场(可增量更新)
/plugin marketplace add eatmoreduck/yaya-skills
/plugin install yaya-skills@yaya-skills

# 方式二:skills CLI
npx skills add eatmoreduck/yaya-skills

# 方式三:手动(项目级)
# 把需要的 skills/<name>/ 目录复制或软链到 <项目>/.agents/skills/
# ⚠️ yaya-xspace 依赖 yaya-xdl 和 yaya-asr;yaya-asr 依赖 yaya-diarize——单独复制会失效
设计原则
- 本地优先:能本地跑的绝不上云。音频不出机器(转写全在本地,只有提取后的文本发给 LLM)。
- 砍废话,不砍信息:提炼是“去冗余”,不是“缩写”。金句、关键名词、枚举清单必须完整保留。
- 原子能力与业务解耦:
yaya-asr不知道 Space 是什么;场景 skill 只管补齐自己独有的那一段。 - 诚实标注边界:每个 skill 明确写出它做不到什么,不假装能处理所有情况。
目录约定
yaya-skills/
├── .claude-plugin/
│   └── marketplace.json     ★ 声明本仓库包含哪些 skill
├── demo/                    ★ 真实场次的示例产出(手工挑选,随仓库公开)
├── skills/
│   ├── yaya-asr/            原子能力(无依赖)
│   │   ├── SKILL.md
│   │   ├── README.md
│   │   ├── run.sh
│   │   ├── scripts/asr.py
│   │   └── models/          分离模型(gitignore,首次运行自动下)
│   ├── yaya-xdl/            原子能力(无依赖)
│   │   └── SKILL.md / README.md / run.sh / xdl.py
│   ├── yaya-diarize/        原子能力(无依赖)
│   │   └── SKILL.md / README.md / run.sh / diarize.py
│   └── yaya-xspace/         场景编排(依赖 yaya-xdl + yaya-asr)
│       ├── SKILL.md
│       ├── README.md
│       ├── run.sh
│       ├── distill.py
│       ├── card.py          出图:distilled.md → 手绘风分享图 PNG
│       ├── fonts/           手写体(OFL,出图用)
│       └── out/             产物与音频归档(gitignore,数据跟着 skill 走)
├── README.md
└── TECHNICAL.md             技术说明:架构概要 + 性能实测(README 只留链接)
如何新增一个 skill
本仓库是单仓多 skill 结构,新增只需三步:
- 建目录:创建
skills/yaya-<名字>/,写SKILL.md(frontmatter 必须包含name/description——description 决定 Agent 什么时候想到用它)。 - 登记:在
.claude-plugin/marketplace.json的plugins[0].skills[]里加一行"./skills/yaya-<名字>"。这步不能省:当source: "./"且显式列出 skills 时,插件只加载列出的目录,不会自动扫描skills/。 - 声明依赖:若依赖仓库内其他 skill(如 yaya-asr),在 SKILL.md 里写明依赖方向、寻址路径(目前统一约定为相邻目录
../yaya-asr),并说明缺了它会发生什么。
命名统一保持 yaya- 前缀。本地技能清单(如 ~/.zcode/skills/)与仓库是两回事:仓库是源,装机靠 marketplace 安装或手动软链。
命名约定
所有 skill 统一使用 yaya- 前缀。
关注 & 联系
 公众号「多吃鸭」· 追更新、提需求、唠嗑 |
 个人微信 · 交流、提需求(看到就回) |
License
MIT
Reviews (0)
Sign in to leave a review.
Leave a reviewNo results found