bilibili-douyin-notes
Health Pass
- License — License: MIT
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Community trust — 31 GitHub stars
Code Pass
- Code scan — Scanned 12 files during light audit, no dangerous patterns found
Permissions Pass
- Permissions — No dangerous permissions requested
No AI report is available for this listing yet.
把B站/抖音视频一键整理成Markdown课堂笔记的AI Agent Skill:字幕抓取 · faster-whisper本地ASR · 重点截图 ·,全流程免费
bilibili-douyin-notes
把 B站 / 抖音视频一键整理成 Markdown 课堂笔记的 AI Agent Skill
字幕抓取 · 本地语音识别 · 重点截图 · 笔记模板 —— 免登录可用,扫码登录解锁 AI 字幕与更高画质


简体中文 | English
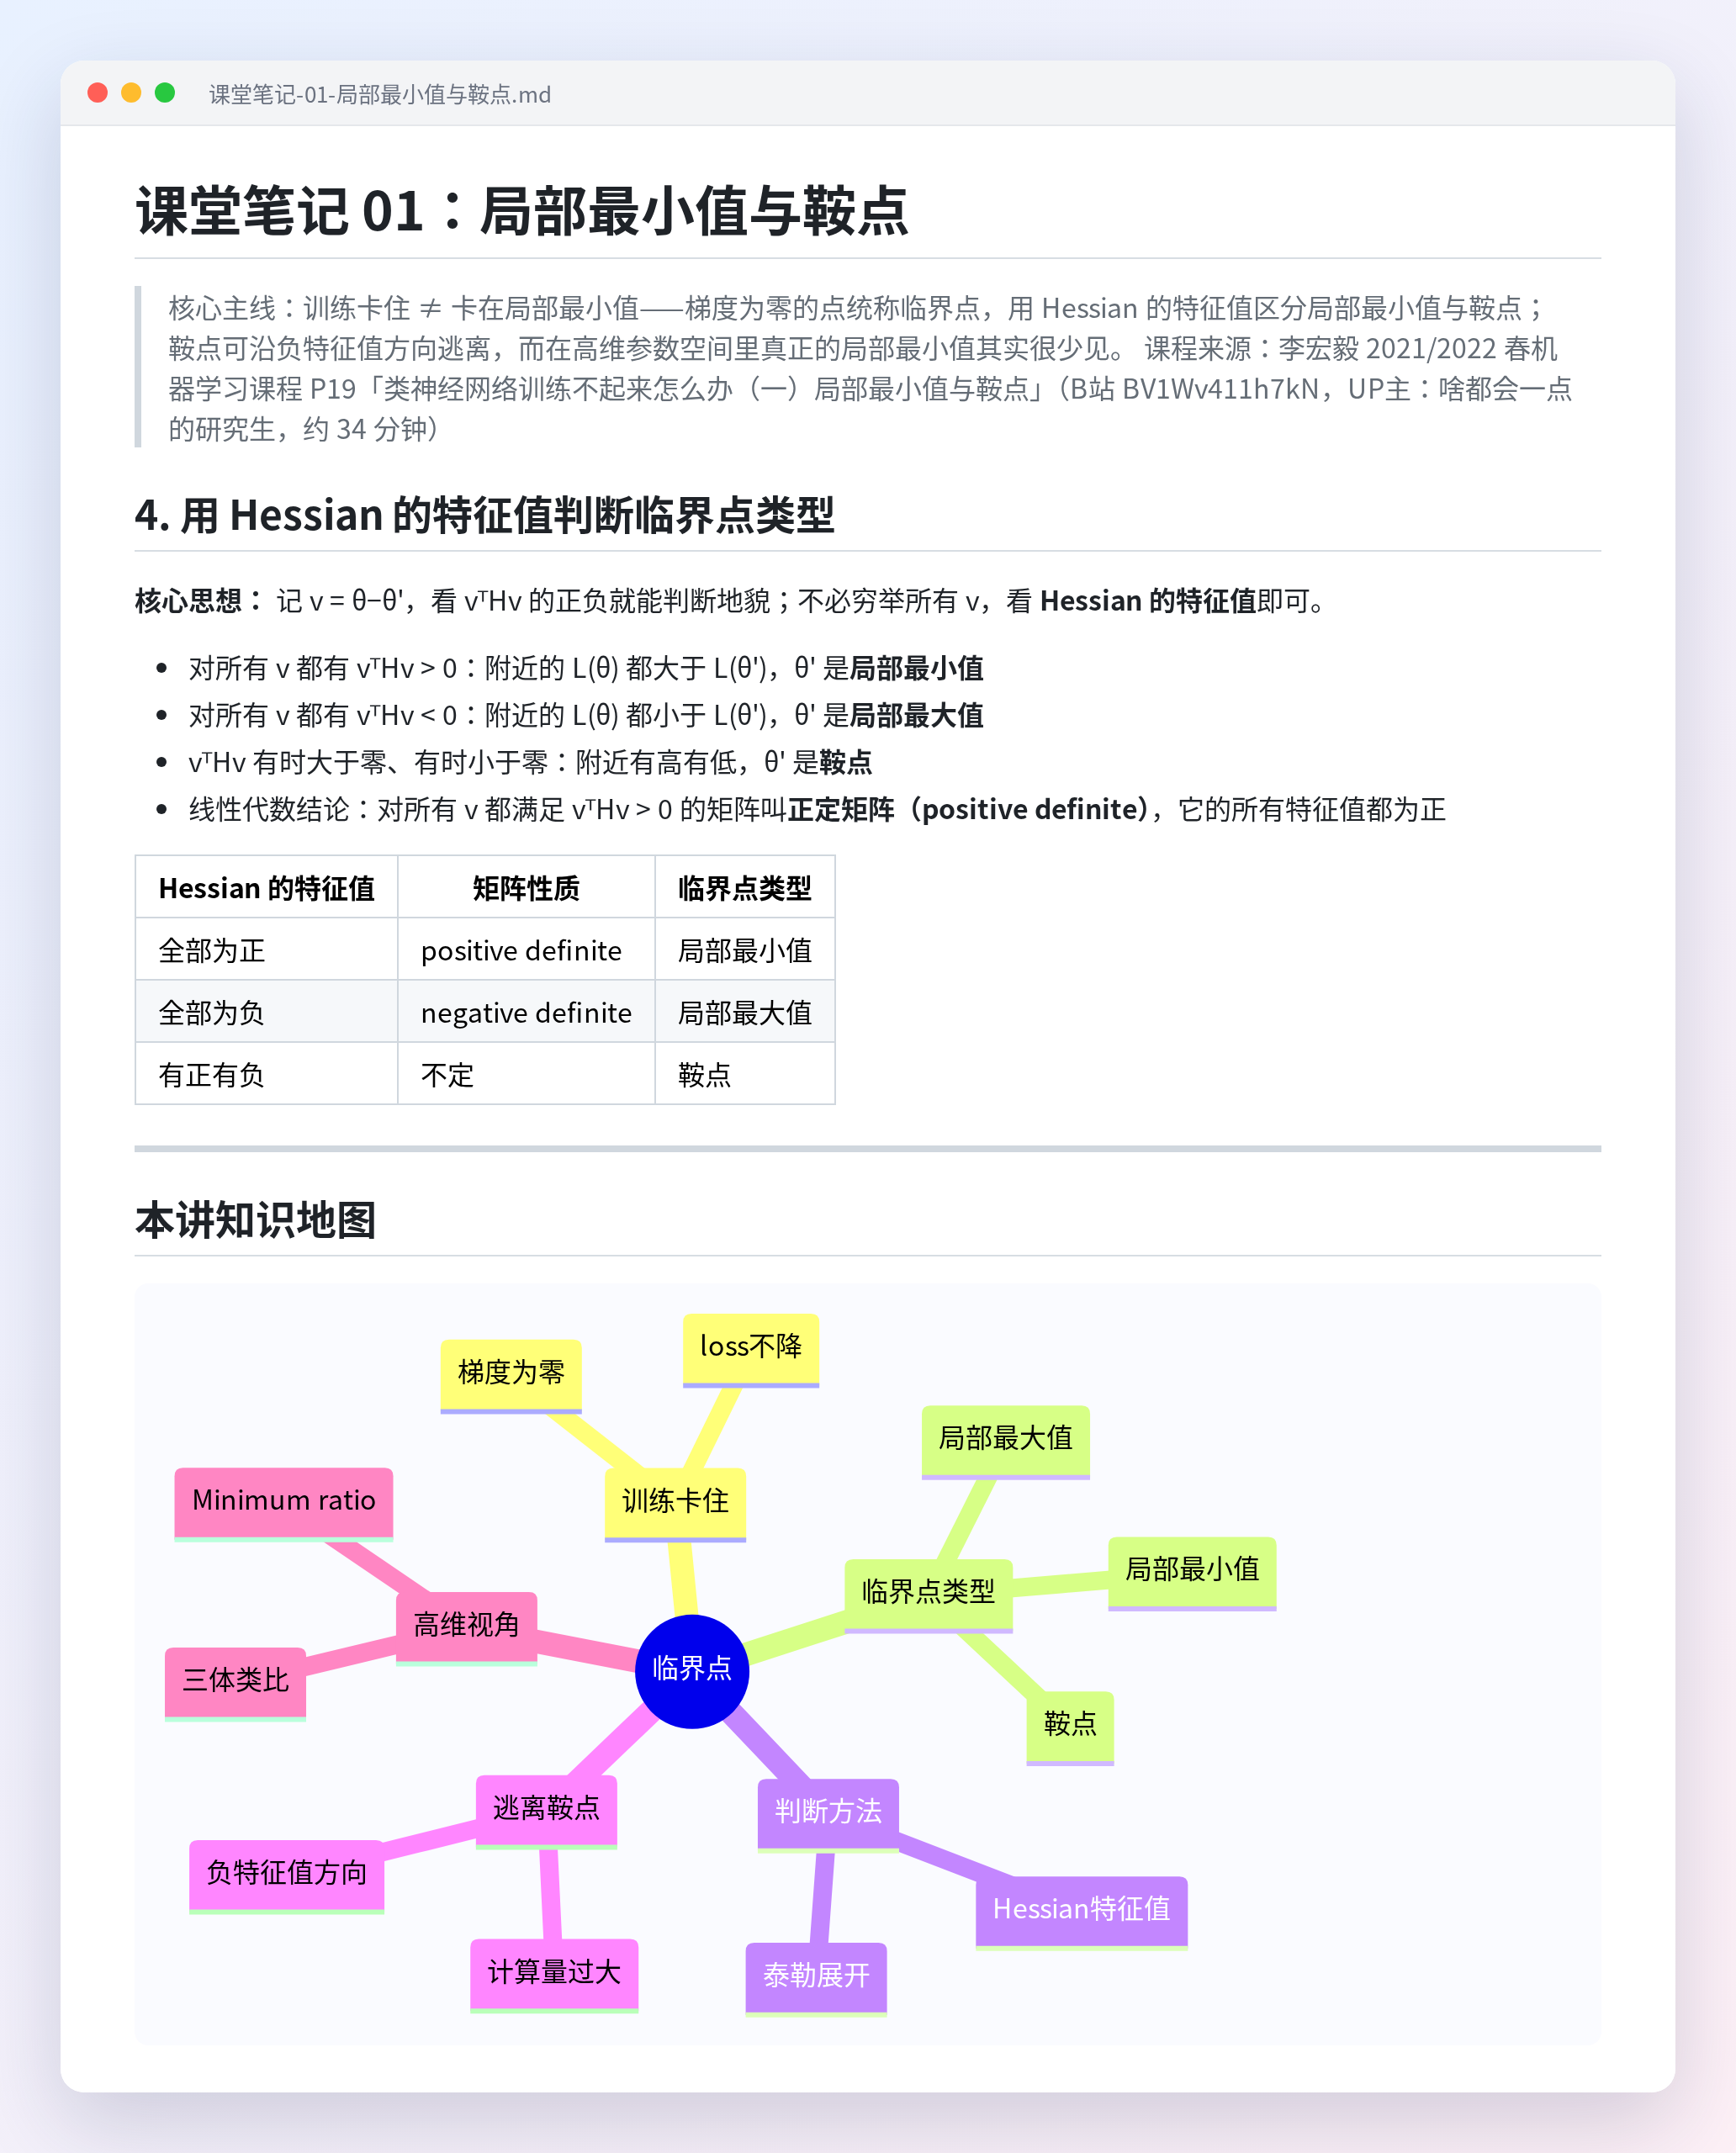
💬 对 AI 说一句「帮我把这个视频做成课堂笔记:<B站/抖音链接>」,就能得到下面这样的笔记 👇
(完整示例:李宏毅机器学习 · 局部最小值与鞍点)
✨ 功能特性
- 多平台支持:B站(
bilibili.com/b23.tv短链 / BV号)、抖音(douyin.com/v.douyin.com/iesdouyin.com链接 / 分享口令文本)与 YouTube(youtube.com/youtu.be/ Shorts 链接,优先取官方/自动字幕) - 字幕优先:自动抓取B站官方/AI字幕(可选登录),零成本秒出文稿
- ASR 兜底:无字幕时用 faster-whisper 本地语音识别(CPU int8,国内走 hf-mirror 镜像),不调任何付费 API
- 重点截图:按转写稿时间戳锚点 + PyAV 抽帧,本地画质初筛自动校验并标记黑屏/空屏/模糊帧(像素占比法,白底 PPT 不误判),最终由 Agent 视觉复核决定取舍;无硬编码锚点时自动从文稿提取关键词
- 抖音免登录:游客身份(ttwid + a_bogus 签名)直接下载无水印视频,无需账号 Cookie
- 课堂笔记模板:小节结构 + 关键术语加粗 + 真实代码引用 + 知识地图 + 概念卡片 + 自测题,文末附可回看跳转的视频时间索引
🧩 工作流程
视频链接(B站/抖音)
        │
        ▼
┌─────────────────────┐
│ 第一步:抓取          │  B站:元数据 + 官方字幕(SESSDATA 可选)
│ (按平台分流)        │  抖音:元数据 + 无水印视频下载(免登录)
└─────────────────────┘
        │ 有字幕?──────否───┐
        ▼ 是                ▼
┌──────────────┐   ┌──────────────────────┐
│ 直接用字幕文本 │   │ 第二步:faster-whisper │
└──────────────┘   │ 本地 ASR 转写          │
        │          └──────────────────────┘
        ▼                  │
┌─────────────────────┐   │
│ 第二步半(可选)      │◄──┘
│ 重点截图(PyAV 抽帧) │
└─────────────────────┘
        │
        ▼
┌─────────────────────┐
│ 第三步:AI 按模板     │  课堂笔记 .md
│ 生成课堂笔记         │  (小节+要点加粗+代码+知识地图+概念卡片+自测题)
└─────────────────────┘
⚡ 快速开始
# 一行安装(Claude Code;其他 Agent 把路径换成对应的 skills 目录)
git clone https://github.com/lucky-Luor/bilibili-douyin-notes.git ~/.claude/skills/bilibili-douyin-notes && pip install -r ~/.claude/skills/bilibili-douyin-notes/requirements.txt
装好后直接对 AI 说:「帮我把这个视频做成课堂笔记:https://www.bilibili.com/video/BVxxxx」。详细安装与可选配置见下文。
📦 安装
本 skill 遵循 Agent Skills 规范(SKILL.md),任何支持该规范的 AI Agent 均可安装。
支持的安装路径:
~/.claude/skills/—— Claude Code~/.zcode/skills/—— ZCode~/.agents/skills/—— DSH、Codex 等多种 Agent 共用的通用 skills 路径
其他兼容 Agent 放入其各自的 skills 目录即可。
# 1. 克隆到你的 agent 的 skills 目录(以 ZCode 为例)
git clone https://github.com/lucky-Luor/bilibili-douyin-notes.git ~/.zcode/skills/bilibili-douyin-notes

# 2. 安装 Python 依赖(按需:B站流程 / 抖音流程见 requirements.txt 内注释)
pip install -r requirements.txt

# (可选)只装测试依赖:tests/ 离线可跑,无需 faster-whisper / av / gmssl(numpy / pillow 仍需安装)
pip install -r requirements-dev.txt

# 3. (可选)扫码登录B站,自动获取 AI 字幕
python scripts/bili_fetch.py --login   # 生成二维码 PNG 图片并打印路径,B站 App 扫码即登录,SESSDATA 自动写入 config.json
                                       # 无 B站App:cp config.example.json config.json 后按文件内注释手动填写
最小依赖说明路径说明:
SKILL.md中示例命令的<skill安装目录>为占位符,使用时请替换为
本 skill 的实际安装路径(脚本内部均基于__file__相对定位,改路径不影响运行)。
| 组件 | 用途 | 是否必需 |
|---|---|---|
faster-whisper |
语音识别兜底 | 做无字幕视频笔记时必需 |
av(PyAV) |
音频解码 / 视频抽帧 | 同上(faster-whisper 依赖链会带上) |
gmssl |
抖音 a_bogus 签名(SM3) | 仅抖音链接需要 |
yt-dlp / youtube-transcript-api |
YouTube 元数据、字幕与音频(建议另装 deno) | 仅 YouTube 链接需要 |
numpy / pillow |
截图画质初筛(像素占比法 QC) | 仅截图流程需要 |
⚙️ 配置
复制 config.example.json 为同目录 config.json:
{
  "SESSDATA": ""  // B站登录 cookie;留空也能用(官方CC字幕+ASR兜底均可)
}
获取方式(推荐):python scripts/bili_fetch.py --login,生成二维码 PNG 图片并打印路径,B站 App 扫码即登录,
SESSDATA 自动写入 config.json;二维码过期自动换新。手动路径:浏览器登录 bilibili.com →
F12 → Application → Cookies → 复制 SESSDATA。该文件已被 .gitignore 排除,不会被提交
(含登录凭据,请勿分享)。抖音流程无需任何配置。
转写性能(可选配置)
CPU 转写慢时可在 config.json 调整:asr_model(tiny~large-v3,高阶加载失败自动降一档)、asr_device(auto/cpu/cuda,cuda 失败自动回退 cpu)、asr_cpu_threads(0=自动)。
每次降级都会打印原因,不静默。整理完成后可让 AI 询问你是否清理缓存的媒体文件
(scripts/clean_media.py,默认只列清单、--apply 实删)。
🚀 使用
安装后直接对 AI 说:
帮我把这个视频做成课堂笔记:https://www.bilibili.com/video/BVxxxx
总结一下这个抖音视频:https://v.douyin.com/xxxx/
也可以直接手动调用脚本(详见 SKILL.md 的工作流程章节):
# 先探元数据:不抓字幕、不写文件(确认视频可访问/时长/分P数)
python scripts/bili_fetch.py --probe "<视频链接>"

# B站:抓取元数据与字幕
python scripts/bili_fetch.py "<视频链接>" "<输出目录>"

# 抖音:抓取元数据并下载无水印视频(免登录)
python scripts/douyin_fetch.py "<链接或分享口令>" "<输出目录>"

# YouTube:抓取元数据与字幕(无字幕时加 --download 下载音频)
python scripts/yt_fetch.py "<视频链接>" "<输出目录>"

# 无字幕时:本地语音识别
python scripts/bili_transcribe.py "<输出目录>/metadata.json"

# ASR 术语校正:先 dry-run 看报告,确认后 --apply(自动留 .bak)
python scripts/apply_glossary.py "<输出目录>/01_分P名.txt"

# (可选)抽取重点截图(需 ASCII 文件名时加 --ascii-names)
python scripts/bili_screenshot.py "<输出目录>/metadata.json" "<输出目录>" "<输出目录>/images"

# 时间索引深链填充(v3 笔记默认执行,short 跳过)
python scripts/note_nav.py "<笔记.md>" --meta "<输出目录>/metadata.json" --txt-dir "<输出目录>"

# 生成笔记后的质量门禁(errors 为 0 才交付)
python scripts/validate_note.py "<笔记.md>" --meta "<输出目录>/metadata.json" --txt-dir "<输出目录>"
📁 目录结构
├── SKILL.md               # Agent Skills 规范定义:触发条件、三步工作流程、笔记模板
├── scripts/
│   ├── bili_fetch.py      # B站:元数据 + 字幕抓取(--probe 只探元数据)
│   ├── douyin_fetch.py    # 抖音:元数据 + 无水印视频下载(游客身份)
│   ├── yt_fetch.py        # YouTube:元数据 + 字幕三级回退(无字幕按需下载音频)
│   ├── bili_transcribe.py # faster-whisper 本地 ASR 兜底(双平台兼容)
│   ├── bili_screenshot.py # 重点截图(锚点/自动关键词 + PyAV 抽帧 + 像素占比法 QC)
│   ├── transcript_chunk.py# 长转写稿分块(map-reduce 前置)
│   ├── apply_glossary.py  # ASR 术语校正(dry-run 报告 / --apply 落盘)
│   ├── note_nav.py        # 时间索引深链填充 / v2 参考时间戳生成
│   ├── clean_media.py     # 询问式媒体清理(默认只列清单、--apply 实删)
│   ├── validate_note.py   # 笔记质量门禁(errors 为 0 才交付)
│   ├── ensure_abogus.py   # abogus.py 缺失时从上游固定 commit 下载(SHA-256 校验)
│   └── abogus.py          # 抖音 a_bogus 签名算法(GPLv3,按需下载,不入仓库)
├── tests/                 # 离线 pytest 测试(不联网、无需重依赖)
├── examples/              # 示例笔记(真实视频生成,已通过质量门禁)
├── docs/images/           # README 配图
├── references/
│   ├── anchors.json       # 截图关键词锚点表(时刻由脚本按转写稿运行时推导)
│   ├── asr-glossary.json  # ASR 技术术语校正表
│   ├── glossary-user.example.json  # 用户层词表示例
│   └── note-template.md   # 课堂笔记模板
├── config.example.json    # 配置模板(SESSDATA)
└── LICENSE                # MIT
❓ 常见问题
需要什么环境?Python 3.10+,以及任意一个支持 Agent Skills(SKILL.md)规范的 AI Agent,如 Claude Code、Codex、ZCode。不需要 GPU,也不需要任何付费 API。
不用。不登录也能抓官方 CC 字幕,没有字幕时自动走本地语音识别。扫码登录(python scripts/bili_fetch.py --login)后可以拿到 B站 AI 字幕,多数视频能跳过语音识别,速度快很多。抖音完全不需要登录。
在 config.json 里把 asr_model 调小(如 small / base),或在有 NVIDIA 显卡时设置 asr_device: "cuda"。也可以先只转写一个分P(--page 1)估算耗时。
用 scripts/apply_glossary.py 做术语校正:先 dry-run 看报告,确认后 --apply。发现新的错法可以用 --add "错法=正确词" 补进词表,越用越准。
通常是平台更新了签名算法,参见下方「已知限制」里关于 abogus.py 的说明,或提一个 Issue 告诉我。
看 examples/ 目录里的完整示例,包含小节要点、对比表格、知识地图、概念卡片、自测题和可跳转的视频时间索引。
⚠️ 已知限制
- 长视频(>1小时)本地转写耗时:CPU int8 约为视频时长的 1~3 倍(批量推理可缓解),有 NVIDIA GPU 时快于实时
- ASR 转写的技术术语可能出错(如 IoC、Starter),生成笔记时建议结合上下文或代码仓库校正
- 抖音依赖平台签名算法,平台升级时可能临时失效(表现为 detail 接口 403),需跟进上游项目更新签名实现
- 抖音签名的
abogus.py依赖上游仓库(BiliNote)托管:下载 URL 已固定到上游具体 commit 并做 SHA-256 校验;上游更新签名算法时,可用环境变量BILINOTE_ABOGUS_SHA=<新commit>临时指向新 revision,或按scripts/ensure_abogus.py文件头的手动安装步骤放置文件 - 仅支持公开可访问的视频
📄 许可证
本仓库主体采用 MIT 协议开源。
例外:scripts/abogus.py 不在本仓库中。 本仓库不包含、也不分发该 GPLv3 组件;
由使用者在自己的机器上按需获取,按其自身条款使用。该文件是抖音 a_bogus 签名算法
代码,源自 TikTokDownloader
(经 Evil0ctal/Douyin_TikTok_Download_API
与 BiliNote 移植)。scripts/ensure_abogus.py
在首次使用抖音功能时从上游仓库的固定 commit 下载到本地,下载内容必须通过
SHA-256 校验与关键字校验(ghproxy 镜像仅作为传输通道,同样必须过校验);
也可设置环境变量 BILINOTE_ABOGUS_SHA 指向其他 revision(详见 scripts/ensure_abogus.py
文件头说明)。下载后的该文件遵循其自身的 GPLv3 条款(上游文件头的 GPLv3/Apache-2.0
声明自相矛盾,本项目按更严格的 GPLv3 处理)。
手动安装(网络受限时):从 BiliNote 仓库的
backend/app/downloaders/douyin_helper/abogus.py
下载文件,放到本 skill 的scripts/abogus.py即可。
🙏 致谢
- JoeanAmier/TikTokDownloader ——
abogus.py原始作者 - Evil0ctal/Douyin_TikTok_Download_API —— 抖音 Web API 签名与 x-secsdk-web-signature 方案参考
- JefferyHcool/BiliNote —— 多平台下载器架构参考
- faster-whisper —— 本地语音识别引擎
如果这个 skill 帮你省下了记笔记的时间,欢迎点个 ⭐ Star 支持一下!
用它生成了满意的笔记?欢迎在 Issues 晒出来,遇到问题或有新想法也欢迎反馈 🙌
Reviews (0)
Sign in to leave a review.
Leave a reviewNo results found