ascend-sleuth
Health Warn
- License — License: MIT
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 5 GitHub stars
Code Fail
- exec() — Shell command execution in dsh-plugins/ascend-panel/panel-host.js
- exec() — Shell command execution in dsh-plugins/loader/panel-from-file.js
Permissions Pass
- Permissions — No dangerous permissions requested
No AI report is available for this listing yet.
知识驱动的昇腾训练/推理诊断 skill 套件 — Ascend training/inference diagnosis skill suite (5 skills + 3-tier knowledge base, Agent Skills standard)

昇腾 NPU 训练与推理的诊断工具套件。把每次问题定位沉淀为可复用知识,让同类问题下次直接命中。
遵循 Agent Skills 标准,可在 pi、Claude Code、Codex 等任意支持该标准的 agent 中使用。
agent 执行差异:不同 agent 对 SKILL.md 的执行质量有差异(prompt 纪律本质是概率性的),诊断结果与 trace 质量可能因 agent 而异。团队内建议统一 agent;跨 agent 对比时,先归因执行差异,再判断是否知识错误。
快速跳转:为什么需要 · 快速开始 · skill 名单 · 诊断面板 · 工作原理 · 文档
为什么需要它
昇腾支持工程师日常处理三类问题:训练或推理中断(hang、crash、OOM)、精度异常(loss 发散、FP8 衰减)、性能退化(吞吐下降、通信占比过高)。这些问题的根因高度重复,相关知识却散在个人笔记、IM 聊天与各处 wiki。新 case 每周都在出现,A2-910B / A3-910C / A5-950 三代平台的差异还在扩大,靠个人手工维护的方案撑不过几周。
ascend-sleuth 把这些经验沉淀为结构化知识库:诊断时按症状路由到已验证的 case;问题定位结束后,新知识进入待审队列,由例行维护完成去重、升格与退休(人工沉淀按周批处理,自动化导入源可直接升格)。知识随使用不断校准,不依赖某个人的持续投入。
快速开始
安装(使能 skills)
主路径:仓库即 workspace,skills 随仓使能。clone 本仓后,把 agent 的项目级 skills 目录指向 <clone>/skills/。skills/ 是单一事实源,git 管理版本,更新走 git pull,热刷新即时生效,无需重装。装齐主 skill:diagnose / to-postmortem / to-reference / issue-ingest / knowledge-groom / resume-diagnosis / self-evolve(另有 evolve-check 伴随协议随内容 skill 收尾自动执行,preload-panel 供 DSH 面板加载,均无需单独安装)。
零配置(DSH,团队主力)。仓库已跟踪 .dsh/skills → ../skills 相对 symlink,clone 后自动还原,DSH 项目 root 自动发现并热刷新:git pull 更新 SKILL.md 即时生效,无需任何配置。(Windows 上 git 默认不还原 symlink,见下方 Windows 段。)
其他 agent 按需建(仓库不携带额外 symlink,根目录干净):
python3 scripts/enable_agent_skills.py # 检测已安装 agent,建项目级 skills 链接(幂等,可重跑)
各 agent 的项目级 skills 目录(脚本自动建链接,也可手动):
| Agent | 项目级 skills 目录 |
|---|---|
| Claude Code | .claude/skills |
| Cursor | .cursor/skills(官方确认自动发现) |
| Trae | .trae/skills |
| CodeBuddy / WorkBuddy | .codebuddy/skills |
| Codex(OpenAI) | .codex/skills |
| DSH | .dsh/skills(仓库已跟踪,无需脚本) |
.agents/skills未使用:仅 DSH 支持(已被.dsh/skills覆盖),无其他 agent 以其为项目级 skills 目录。
Windows:Git for Windows 默认 core.symlinks=false,clone / worktree 不会还原 symlink——.dsh/skills 会变成内容为 ../skills 的普通文本文件(不是目录),agent 发现不了 skills。此时 git status 可能是干净的,别靠它判断;先自检:
(Get-Item .dsh\skills -Force).PSIsContainer # True = 正常;False = 需要修
两条修法(优先开真 symlink)、三种状态的判别(含破损 reparse 点)、junction 与 skip-worktree 的取舍,见 docs/guide/windows-setup.md。
加载后在 agent 里以 /skill:<name> 调用。
分发路径——把方法论装进别的项目试用(不沉淀回本仓):
npx skills@latest add pillumina/ascend-sleuth -s diagnose -s to-postmortem -s to-reference -s issue-ingest -s knowledge-groom -s resume-diagnosis
npx skills 装的是 skills/ 副本(更新需重装),适合"别的项目里临时试用诊断方法论";本仓团队使用走主路径(仓库即 workspace)。
诊断面板(DSH 可选)
DSH 会话可加载可视化面板——会话列表/轨迹展开/证据文件打开/指标视图。在对话中粘贴:
请加载 ascend-sleuth 诊断面板:先确保 panel_from_file 工具可用
(没有就加载 dsh-plugins/loader/panel-from-file.js,host-only 免审批),
再用 panel_from_file 按路径加载 dsh-plugins/ascend-panel/panel-host.js 与 panel-client.js。
面板两个文件合计 ~70KB,直接贴进 cordis_define 要几千 output token、几分钟;panel_from_file 只发两个路径(几十 token),读盘后源码仍进不可变 Package(可审计)。
DSH 支持 cordis_define 的 codeFile 时也可跳过 loader 直接用它。
面板是可选增强,不改变任何 skill 行为。加载说明见 dsh-plugins/ascend-panel/README.md、dsh-plugins/loader/README.md。
一个诊断
把客户提供的症状、框架、日志片段告诉 agent——agent 不访问客户环境,所有信息由你提供:
/skill:diagnose

客户 A5-950 训练在 step ~3000 hang,all_to_all timeout,world_size=128。
框架 mindspeed-llm 2.5.0。报错栈尾:[粘贴相关 rank 的日志片段]
agent 路由到 training/mindspeed-llm/ 并匹配 case。命中时给出结构化结果(CASE-ID、confidence、fix、rollback),未命中时转入深度排查。信息不足时,agent 会明确告诉你需要向客户补充什么。整个过程记录 trace——即使被打断,也能用 /skill:resume-diagnosis 从断点继续。
沉淀一次定位
任何来源的调查——本地 agent 会话、Kimi 对话、手工笔记、wiki 导出——都能汇入知识库:
/skill:to-postmortem "[粘贴对话或笔记]"                       # 内联
/skill:to-postmortem ~/cases/custA/notes.md                    # 单个文件
/skill:to-postmortem ~/cases/custA/ ~/cases/custB/hang.md      # 多文件
/skill:to-postmortem ~/cases/wiki-export/                      # 目录(批量导入)
agent 提取症状与根因,给出命名空间建议供你确认,生成 YAML 草稿与 postmortem 并完成脱敏,产出到待审队列。也可以在一次 /skill:diagnose 结束后直接说"沉淀一下这次",agent 会自动触发。
自演进(知识随使用变准)
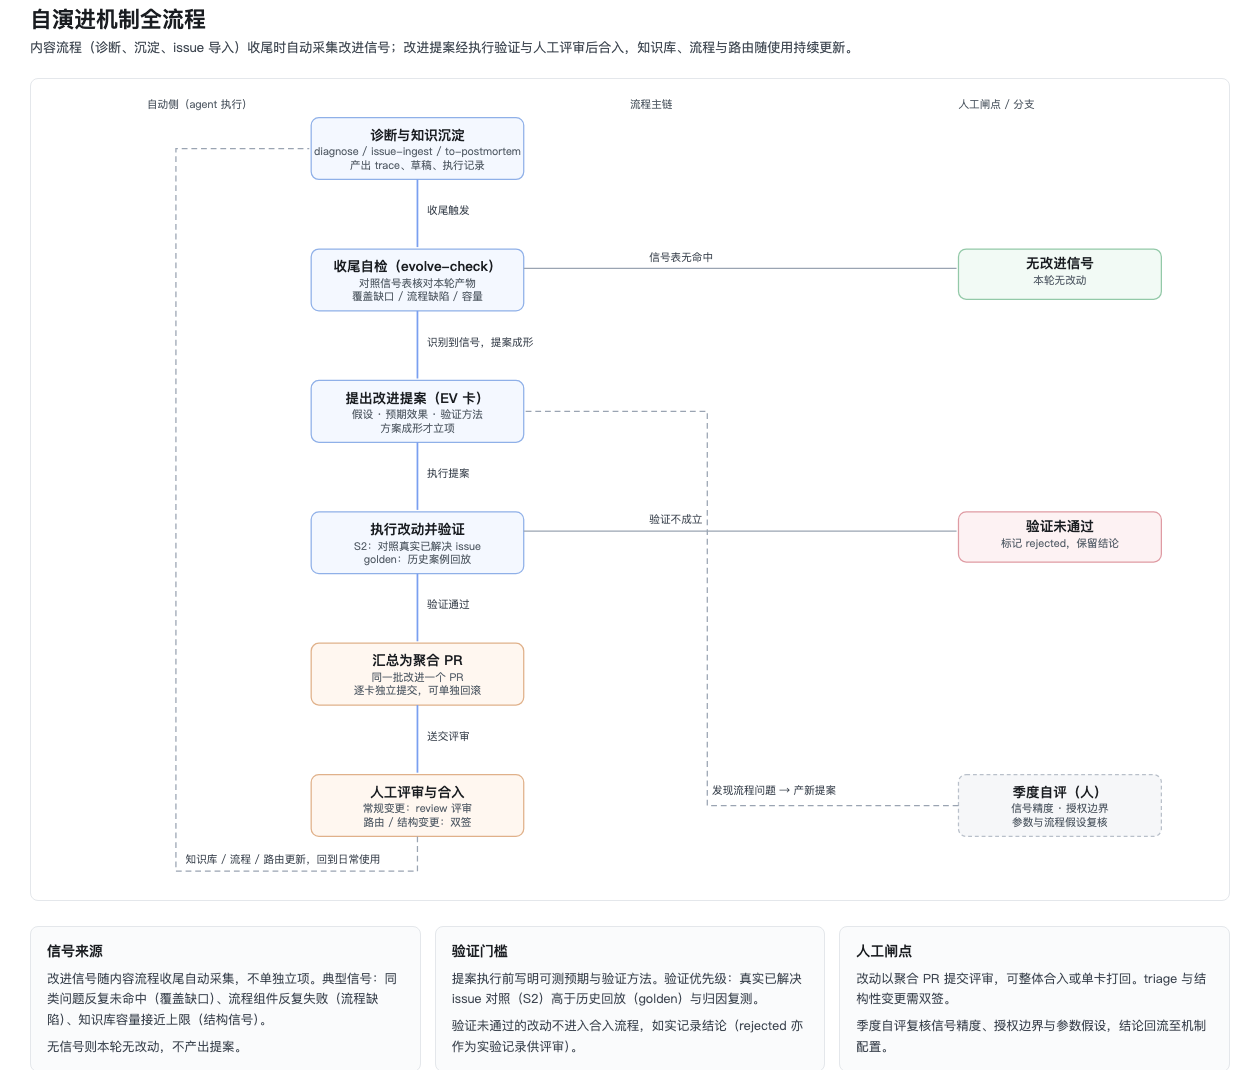
演进不是单独的"跑改进"环节,而是内容流程的默认收尾:你下内容目标(沉淀 / 拉取 issue / 诊断),流程完成后系统自动检查本轮产物里有没有值得改进的信号——有则记改进卡、自行验证、攒批后以 PR 交你审,没有则一行带过。这个伴随检查不需要你额外说明。
显式触发深度轮(全库体检,不只本轮产物):
"跑一轮自演进"                        # 全库观测:容量 / 归因聚合 / 指标 / S2 校准集 → 候选卡 → 校验 → 聚合 PR
"看看有什么可改进的"                   # 同上(未指定方向时按数据信号选)
发生什么:agent 按 skills/self-evolve/SKILL.md 跑一轮——读信号 → 产候选 idea 卡(proposals/ideas/EV-*.yaml)→ verify_proposals.py 校验 → 攒批成聚合 PR 给你审(每卡独立 commit,可单独回滚)。改动的合入始终以 PR 人审为闸点,不自动合入;路由与结构类改动额外双签。
可随时干预:"停一下"(本轮停止,出中间报告)/ "这条改动有问题,回滚"(该卡回滚)。机制细节与使用说明见 自演进用户指南。
知识获取
仓库即 workspace。诊断(读 knowledge/references/triage-tree)与沉淀(写 postmortems/inbox/、references/、ingest-state.json)都在同一个仓库 clone 里进行,SKILL 的知识路径相对仓根。三种起步形态如下:
| 形态 | 起步方式 | 结果 | 适合谁 |
|---|---|---|---|
| 自积累(空仓起步) | git clone 本仓(或 fork)后清空 knowledge/ |
结构完整(skills/ + knowledge/ 空 + 队列/状态就位),从零沉淀 | 新团队、问题域不同、知识要私有 |
| 消费现成(带知识库) | git clone 整个仓库(含 knowledge/ 与 references/) |
直接用上游验证过的 case/reference,也可继续沉淀 | 已有沉淀、问题域重叠、想复用 |
| 定制知识面(稀疏拉取) | git clone 后用 git sparse-checkout 收窄白名单 |
只收窄 case 数据(knowledge/ 子集);方法论/工具/索引全量(见下) |
知识库长大后、带宽/存储受限、只要自己框架的知识 |
-s只装 skill 不构成可用形态——SKILL 的知识路径(postmortems/inbox/、references/、ingest-state.json)相对仓根,没有知识仓结构(knowledge/references/postmortems/ + 队列/状态文件)的"裸 skill"无法沉淀。-s只适合在已有仓库里临时试用诊断方法论(不沉淀回本仓),或把skills/合并进自己已有结构的仓库。
三种形态共用同一套 skill 与机制,且可递进:自积累的团队脱敏后可选回馈上游,让公开库渐厚(见 部署模式 的框架式)。-g 与 -s 的确切行为以 npx skills add --help 为准——不同版本的安装器对"仓库整体 vs 指定 skill"的粒度有差异。
稀疏拉取注意:sparse-checkout 只收窄 case 数据,白名单必含方法论/工具全量(skills/ scripts/ references/ triage-tree.d/ postmortems/ ingest-state.json .dsh/ 等,否则 agent 无 skill 可用),knowledge/ 按需收窄(如 vllm-ascend/ + common/)。两张生成物表都能重建:收窄后跑 scripts/build_index.py 重建索引总表;路由改过就跑 scripts/build_triage_tree.py 重建 triage-tree.yaml(它要求 triage-tree.d/ 全在,所以白名单里那个目录不能省);common/ 必留占位(ADR-0005)。当前规模用全量 clone,稀疏拉取是知识库长大后的带宽优化。
skill 名单
本仓共 11 个 skill,按你用不用得上分三组:
- 你要用的(2):
diagnose·resume-diagnosis - 沉淀知识(4):
to-postmortem·to-reference·issue-ingest·reference-ingest - 维护与演进(5):
knowledge-groom·self-evolve·evolve-check(内部协议,由内容流程收尾自动转接,不单独调用) ·skill-review(内部协议,由用户显式触发做 skill 质量审视) ·preload-panel(仅 DSH——在会话中热加载可视化面板)
下表给出你要用的与沉淀知识两组的操作细节;维护与演进 组见各自 SKILL.md。
| Skill | 作用 | 何时使用 | 触发方式 |
|---|---|---|---|
diagnose |
核心诊断循环:按症状路由,匹配并验证 case,给出修复建议或转深度排查,全程记录 trace | 训练或推理出现中断、精度、性能问题 | 显式 /skill:diagnose |
to-postmortem |
把一次定位沉淀为案例知识,任意来源均可汇入,经校验和脱敏进入待审队列 | 问题定位结束之后,无论在哪里定位的 | 可自动触发 |
to-reference |
把先验知识(事实/方法论)沉淀为 reference 词条:内联/文件/官方文档爬取/从案例归纳,经 grill 确认后进入待审队列 | 工程师想沉淀通用经验、或从案例集合提炼共性时 | 显式 /skill:to-reference |
issue-ingest |
从上游 issue(GitHub 等)批量导入案例:拉取精简元数据 → 硬过滤+启发式排序 → 评估 → 经 to-postmortem 沉淀草稿 → 标记已导入(幂等) | 想吸收某框架 issue 里的排障知识 | 显式 /skill:issue-ingest |
knowledge-groom |
周期维护:批处理待审队列、升格、去重、置信度重算、软退休、索引重建 | owner 例行维护(人工沉淀按周批处理,自动化导入源可即时升格) | 显式 /skill:knowledge-groom |
resume-diagnosis |
续接被打断的诊断:读取状态文件与 trace,复述现场后继续 | 诊断被会议或上下文压缩打断 | 显式 /skill:resume-diagnosis |
preload-panel |
在 DSH 会话中热加载诊断面板插件(cordis_define + cordis_run 激活「诊断」「指标」tab) |
新 DSH 会话需要面板时 | 显式 /skill:preload-panel(仅 DSH) |
self-evolve |
自演进深度轮:全库观测(容量 / 归因聚合 / 指标 / S2 校准集)→ 候选 idea 卡 → 校验 → 攒批 → 聚合 PR 给人审 | 想对全库做一次体检、或持续改进某方向时 | 显式 /skill:self-evolve |
完整的操作细节(severity 闸门、trace 规则、语义校验等)在各自 skills/<name>/SKILL.md。本表覆盖"你要用的"与"沉淀知识"两组;维护与演进 组(knowledge-groom / self-evolve / evolve-check / skill-review / preload-panel)的操作细节见各自 SKILL.md——其中 evolve-check 与 skill-review 是内部协议,由流程收尾或用户显式触发转接,日常不单独调用。三个诊断类 skill 为 user-only,诊断决策由人触发;to-postmortem / to-reference / issue-ingest 允许自动触发,降低沉淀门槛。issue-ingest 的升格分场景:默认进 inbox 由 owner 批量审后转正;owner 预授权源(该 skill 本身即配置的持续管道)产出的草稿 verification 链完整,可直接调 groom 升格,不等周批。
工作原理
知识按三层组织,按需加载以控制上下文消耗:
| 层 | 内容 | 加载时机 |
|---|---|---|
| Tier 1 | triage-tree.yaml:症状到命名空间的映射,不超过 30 个分支 |
始终加载 |
| Tier 2 | knowledge/ 下结构化的 case 规则 |
症状匹配后两阶段加载:先读生成索引 knowledge/_index.yaml 过滤候选,再加载全量验证 |
| Tier 3 | postmortems/ 下的原始定位记录 |
前两层未命中时关键词检索兜底 |
问题沿两个维度拆解。在哪查:按问题发生的环节(训练或推理)与所用框架,对应加载哪个命名空间(如 training/mindspeed-llm/),这是知识库的目录结构。什么性质:按问题类型(中断、精度、性能)走各自的匹配形态与默认排查思路——中断用错误签名 grep,精度用数值阈值断言,性能用 profiler 指标比对,三者不混用。
诊断过程全程记录 trace:加载了哪些命名空间、按什么顺序执行了哪些检查。trace 用于事后归因。一次误诊,究竟是知识库里的 case 写错了,还是 agent 执行流程走偏了,两者的修复路径完全不同——混在一起会把本来正确的东西改坏。
三个闭环驱动整个系统,分清它们各自消费什么、产出什么,是理解这套机制的前提(全图与权威归属见 自演进元机制):
| 闭环 | 什么时候发生 | 入口 | 产出 |
|---|---|---|---|
| 诊断闭环 | 每次问题(分钟级) | /skill:diagnose |
修复建议 + trace(证据与决策依据) |
| 沉淀闭环 | 定位结束后 / 定期批量 | /skill:to-postmortem、/skill:to-reference、/skill:issue-ingest |
待审队列 → 升格为 case / reference 词条 |
| 演进闭环 | 内容流程收尾 / 全库体检轮 | /skill:evolve-check、/skill:self-evolve |
改进卡 → 验证 → 攒批 PR(人审)→ 回到前两个闭环 |
完整全景见下方架构图(交互版,支持主题切换与 PNG 导出);每个机制配什么护栏防止越学越错、以及每周实际要做什么,见 docs/mechanism/rsi-mechanism.md。
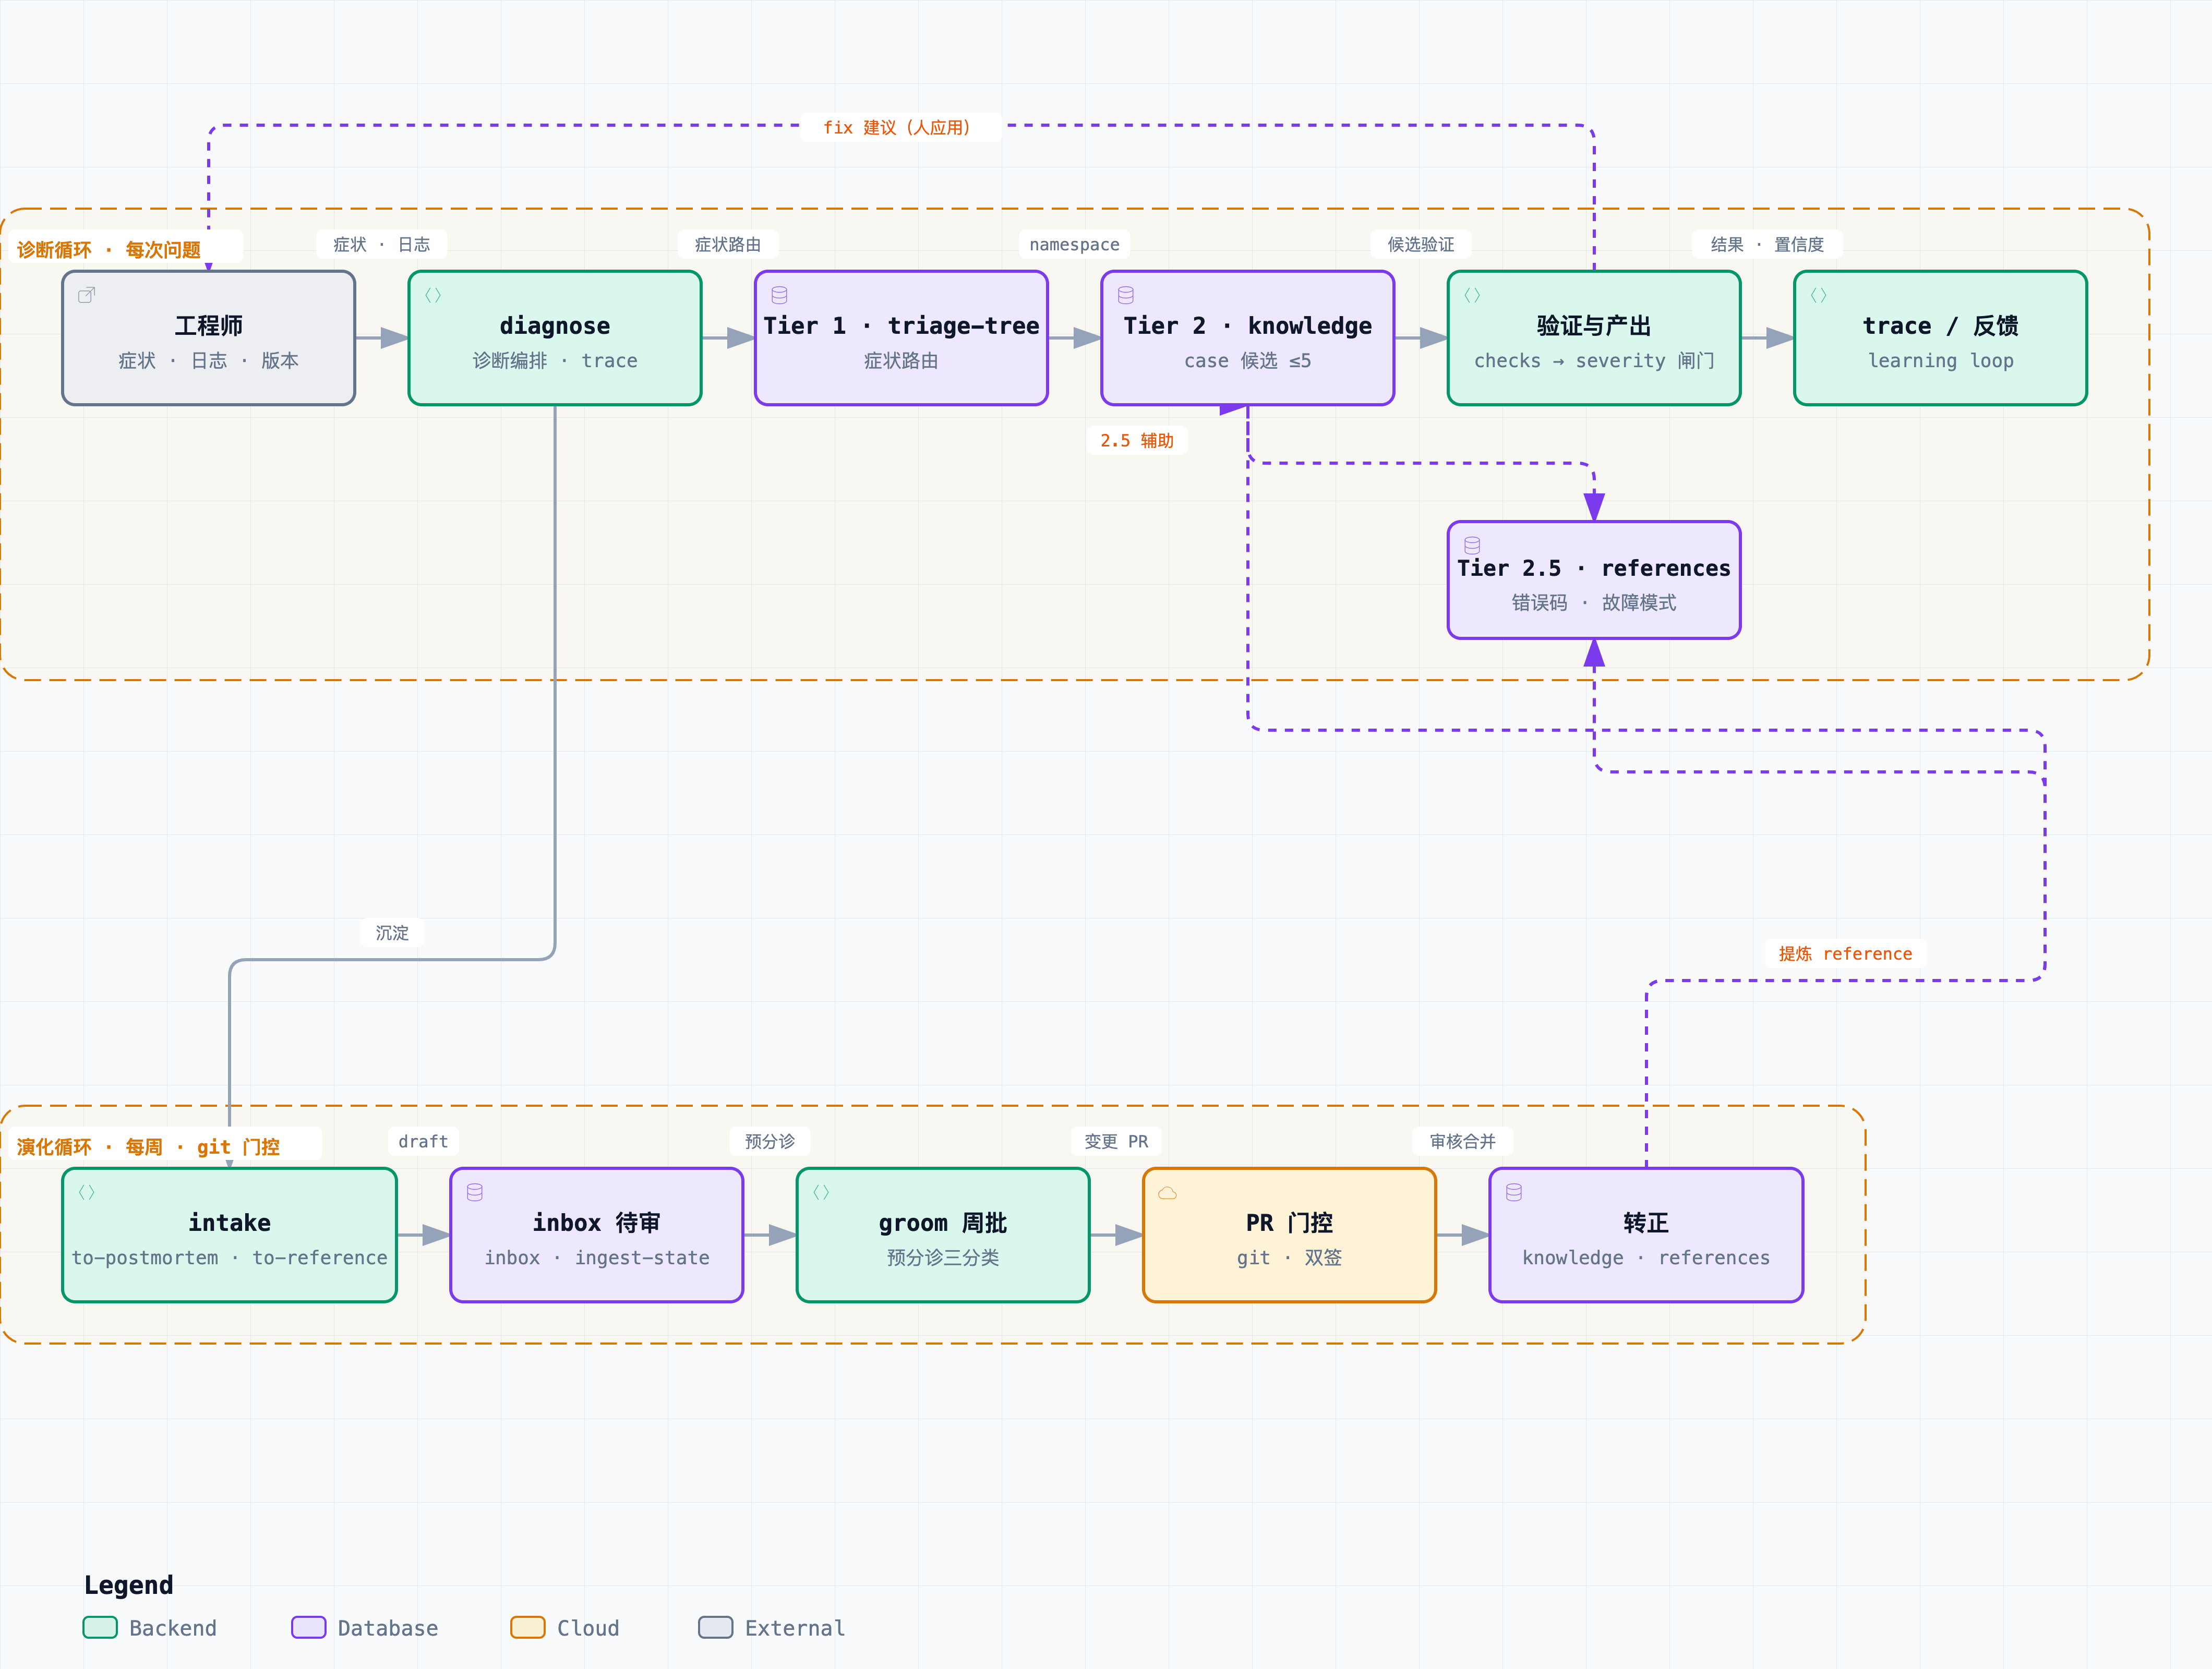
自演进机制全流程(交互图 HTML;机制细节见 docs/mechanism/pipeline.md):
核心设计原则
面向使用者的节选;完整的规范性原文(十一条,各含推导与禁止项)见 docs/spec/design-principles.md。
用结构承载规则,不依赖执行自觉。 凡是能写进文件结构的约定,就不放在 prompt 里靠模型遵守:阶段一加载固定为读生成的索引文件,反馈追踪落在状态文件的标记位上,索引新鲜度由脚本硬校验。写进结构的规则不会随执行质量波动。
检索只负责提名,验证决定放行。 症状匹配只产生候选,诊断检查项对照客户环境的真实信息验证通过后,才输出修复建议;标记为 data-loss-risk 的根因只输出停机保现场的指令。多问一轮的代价,远低于一次误诊。
语义判断交给 agent,知识底座保持词法。 工程师的模糊描述由 agent 归一为可检索的错误签名;知识库本身始终是 YAML 和 git,可 diff、可审计、可回滚。这是不引入向量检索的直接原因,完整论证与重评条件见 ADR-0002。
规模上限是一项架构承诺。 每个 (框架 × 类别) 格子 30 条 case 的软上限并非洁癖:正是这个上限保证了命中分片能在单次加载里暴力过滤。上限先于任何检索基础设施存在;超软上限触发拆分评估,超 60 条强制拆分(口径与拆分轴见 ADR-0004,各格子当前实测值与拆分裁决见 roadmap.md 的容量治理条目)。
自动化产出建议,人做决定。 预分诊、候选 case 起草、置信度重算都只给出建议和依据,采纳、调整或驳回由维护者判定。人的工作从结构化整理上移为快速审批,单条成本从二十分钟降到半分钟以内。
人工审核按批处理组织。 持续汇入的场景下,逐条即时审核违背工程师的工作节律。待审内容进入 inbox 队列,owner 按批集中处理(人工沉淀通常每周一批),停留过久的条目自动标红催办。
先保证可观测,再谈改进。 误诊归因(该改知识还是改流程)、路由准确率、反馈捕获率,全部来自 trace 记录。没有 trace,这些机制既无法评估,也无从改进。
方法论与知识资产分离。 skills/、scripts/、docs/ 是可公开、可复用的框架;knowledge/ 与 postmortems/ 是团队自有资产,入库前脱敏。团队既可以集中维护一个仓库,也可以 fork 后自行积累知识,两种方式共用同一套机制。
文档
别从头读。先问"我现在要干什么",再按下表找那一篇——日常只需要 自演进元机制 一篇,
其余是改机制本身时才读的论证层。名单由docs/_manifest.yaml生成(scripts/build_docs_index.py --check防漏登记)。
入门(第一次接触先读这篇)
你还不清楚这套系统在做什么、数据怎么流动
- README.md — docs 怎么读:分层表(每一层给谁、什么时候读)+ 入口指路
- demo-walkthrough.md — 从一次诊断到知识演化的可读演示:两分钟架构总览 + 术语与 skill 速览 + 全流程示例(不需要动手)
规范(约束一切设计与演进;改机制前必读)
你要判断某个设计/改动是否合规,或要挑战一条既有规则时
- case-schema.md —
- design-principles.md — 十一条规范性条文——一切设计、实现、修复与演进的依据
- design-theory.md — 四公理 → 公式 → 原则的完整推导链(原则的生成处)
- writing-norms.md — 人读/审阅文本的行文规范(唯一权威):共用条目、必须保留的原值、各面的共用与定制判定、哪些能硬化
演进机制(改机制本身才读;日常不必读)
你要改演进/评测/编排机制本身时——日常只读 docs/mechanism/rsi-mechanism.md 一篇,论证层在 docs/mechanism/
- evolution.md — 旧链接入口(保留以免旧链接失效):内容已并入 mechanism/rsi-mechanism.md,本文只是一页指路,不要在此续写
- rsi-mechanism.md — 机制技术说明(这一层的入口):三环主线、什么时候触发、验证怎么闭环、哪一步需要人、每周做什么
- pipeline.md — 三层闭环(知识 / 流程 / 编排)与 proposal 状态机、卡 schema
- execution.md — proposal 信息契约、评审判据、follow-up 验证、指标分层
- orchestration.md — 自演进会话协议、目标函数与停止条件、token 预算
- run.md — 长期运行、issue 三重角色、统一执行记录、可视化
- eval-arena.md — 元层 eval 台(train/val 门控)与影响账本
- ixn-replay.md — 交互面评测(追问 / 信息充分性 / 过早结论)
操作指南(用到那个环节时才读)
你要装环境(Windows skills 使能)、跑评测、看指标、走 git 门控、或做 issue 导入时
- evolution-user-guide.md — 使用者侧:能说什么、一句话后发生什么、怎么读进度
- eval.md — 改 skill 前后跑什么(门禁分级)、对照集封存与已冻结的判据
- metrics.md — 指标口径与周批流程(数字以 metrics/timeline.yaml 为准)
- git-workflow.md — 审核、门控、合入与多人协作的落地(含评审把手)
- issue-ingest-pipeline.md — issue → case 的半自动导入管道
- reference-ingest-pipeline.md — 文档仓 → reference 的导入管道(状态文件、成本结构、已知坑)
- windows-setup.md — Windows 下让 agent 发现 skills:三种状态的判别与两条修法
- handoff.md — 把一单诊断交到另一台机器继续(交接包的布局、交接单字段、两条命令的契约与强度边界)
计划与就绪度(想知道"下一步做什么"时读)
你要排下一步工作,或评估能不能推广给一个团队时
- roadmap.md — 闸门驱动的演进计划(每个事项的入口条件与验收标准)
- rollout-assessment.md — 对照原则的四层就绪度评估与推广动作清单
决策留痕(查"当初为什么这样选"时读)
你想推翻某个既有选择,需要先看它当时的论证与重评条件
另:术语表 给出 case / postmortem / groom / trace / reference 等术语的规范定义(用词有争议时以它为准)。
知识库结构
知识库本体(knowledge/)按框架与类别分格组织:
knowledge/
├── _index.yaml              Tier 2 总索引(scripts/build_index.py 生成;阶段一按命中 namespace/category 读 `_index/<ns>[-<cat>].yaml` 分片——F1/F2/F4 索引治理)
├── training/{mindspeed-llm,mindspeed-mm,verl}/
├── inference/{vllm-ascend,sglang}/
│   └── vllm-ascend/         (framework × category 格子分层,ADR-0004)
│       ├── interrupt/  ├── precision/  └── performance/
├── common/                  多框架共用的权威记录(由 groom 提升)
└── _archive/                软退休的过期 case
knowledge/ 之外的其他文件与目录:
triage-tree.yaml             Tier 1 路由(症状 → namespace)
postmortems/                 Tier 3 原始记录;inbox/ 是待审队列(groom 周批处理)
references/                 先验知识层(ADR-0008):独立事实 + 方法论,从官方文档/案例沉淀(表形态与独立词条,导航见 references/README.md)
examples/sample-case.yaml    canonical 样例(全 schema 演示)
CONTEXT.md                   领域术语表(中英对照)
scripts/                     build_index.py、trace_metrics.py、replay_prep.py、replay_trace.py、replay_golden.py、issue_filter.py、fetch_issues.py、settle_trace_feedback.py、settle_s2_feedback.py、verify_references.py、verify_metrics.py、verify_proposals.py、component_tally.py(归因按需聚合)、s2_calibration.py、s2_replay.py、ev_proposal.py、ev_measure.py(EV 卡预测的复现把手,reviewer 用)
dsh-plugins/ascend-panel/    DSH 诊断面板插件(可选,动态 Cordis 插件;加载见其 README)
eval/golden/                 回归测试夹具
proposals/                   自演进领域状态:ideas/(idea 卡,资产入 git)+ sessions/tasks/ 等运行时(gitignore);机制见 docs/mechanism/pipeline.md
docs/                        文档体系(见上方「文档」索引)
CODEOWNERS.example           owner 落实后启用
.github/                     kb-checks CI + 分场景 PR 模板
修改 skill 本身之前,先按 docs/guide/eval.md 跑一遍 golden 回归套件,确认原本能正确命中的场景没有被改坏。
部署模式
两种部署方式都支持,inbox、groom、索引与 CI 机制在两种模式下工作方式相同:
- 集中式:训练与推理团队共用一个仓库,
CODEOWNERS按命名空间划分审批权,common/与triage-tree.yaml的变更需要双 owner 签署。 - 框架式:团队 fork 本仓库后自行积累或导入知识。方法论、机制账本与评测夹具随上游同步(
skills/ scripts/ docs/ examples/ tests/ dsh-plugins/ eval/ .github/ proposals/ideas/;真实 golden 夹具留在本仓),知识面留在本仓;少数共享文件(triage-tree.d/、references/、metrics/gates.yaml、trace-status.yaml)两边都写,按正常合并处理。分档与冲突处理见 docs/guide/git-workflow.md 的「目录归属」一节。
审核、分发与合入的 git 落地细节见 docs/guide/git-workflow.md。
日常工作流
接到问题 → /skill:diagnose(本地 agent 诊断 + 知识匹配)
  紧急时告诉 agent"这是紧急情况"→ 它先给 stabilize 建议、不钻深度排查
定位完 → /skill:to-postmortem 沉淀 → postmortems/inbox/(待审队列)
  (无论这次是 /diagnose 诊断的、还是之前用 Kimi/手工查的,都从这里汇入)
批量吸收 issue → /skill:issue-ingest(自动拉取 → 过滤 → 评估 → 沉淀草稿)
被打断 → /skill:resume-diagnosis
owner 维护 → /skill:knowledge-groom 处理 inbox(人工沉淀按周批;issue-ingest 等
  自动化源的草稿 verification 链完整,可直接升格,不等周批)
  → 变更 PR(三分类标签 + 高风险双签 + kb-checks CI)→ merge(索引随批重建)
fix 应用后 → 回报结果(diagnose/resume 启动时会主动追问)→ confidence 回写
诊断给出的 fix 是 agent 的建议,由人手动应用到客户环境,agent 不自动改生产。
路线图
路线图采用闸门驱动:每个事项定义入口条件(数据或事件触发)与验收标准,不按日期排期。
- v1(已实现):三层检索与生成索引、intake 队列与 groom 批处理、trace 与反馈闭环、git 门控与 CI。
- v1.5(按闸门解锁):router 从 trace 错例演进、fixture replay 半自动化、agent 自起草候选 case、指标分账与容量预测。
- v2:trace 结构挖掘、可信自动晋升。
- 明确不做:向量检索/RAG、ANN、跨组织联邦(论证见 ADR-0002)。
各事项的需求、验收标准、入口闸门与常设检查点见 docs/plan/roadmap.md。
Reviews (0)
Sign in to leave a review.
Leave a reviewNo results found