PrivioSentry
Health Warn
- License — License: AGPL-3.0
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 8 GitHub stars
Code Pass
- Code scan — Scanned 12 files during light audit, no dangerous patterns found
Permissions Pass
- Permissions — No dangerous permissions requested
No AI report is available for this listing yet.
PRIVIO SENTRY - tarja de CPFs, endereços e outros dados pessoais em PDFs com IA local (Tesseract + YOLO + servidor de IA pela API), revisão humana num editor web, API e servidor MCP para agentes, verificação pós-tarja que falha fechado. Apoia práticas alinhadas à LGPD; não garante anonimização. Projeto pessoal e open source (AGPL-3.0).
PRIVIO SENTRY
Infraestrutura local de privacidade com IA · produto atual: SENTRY Redact
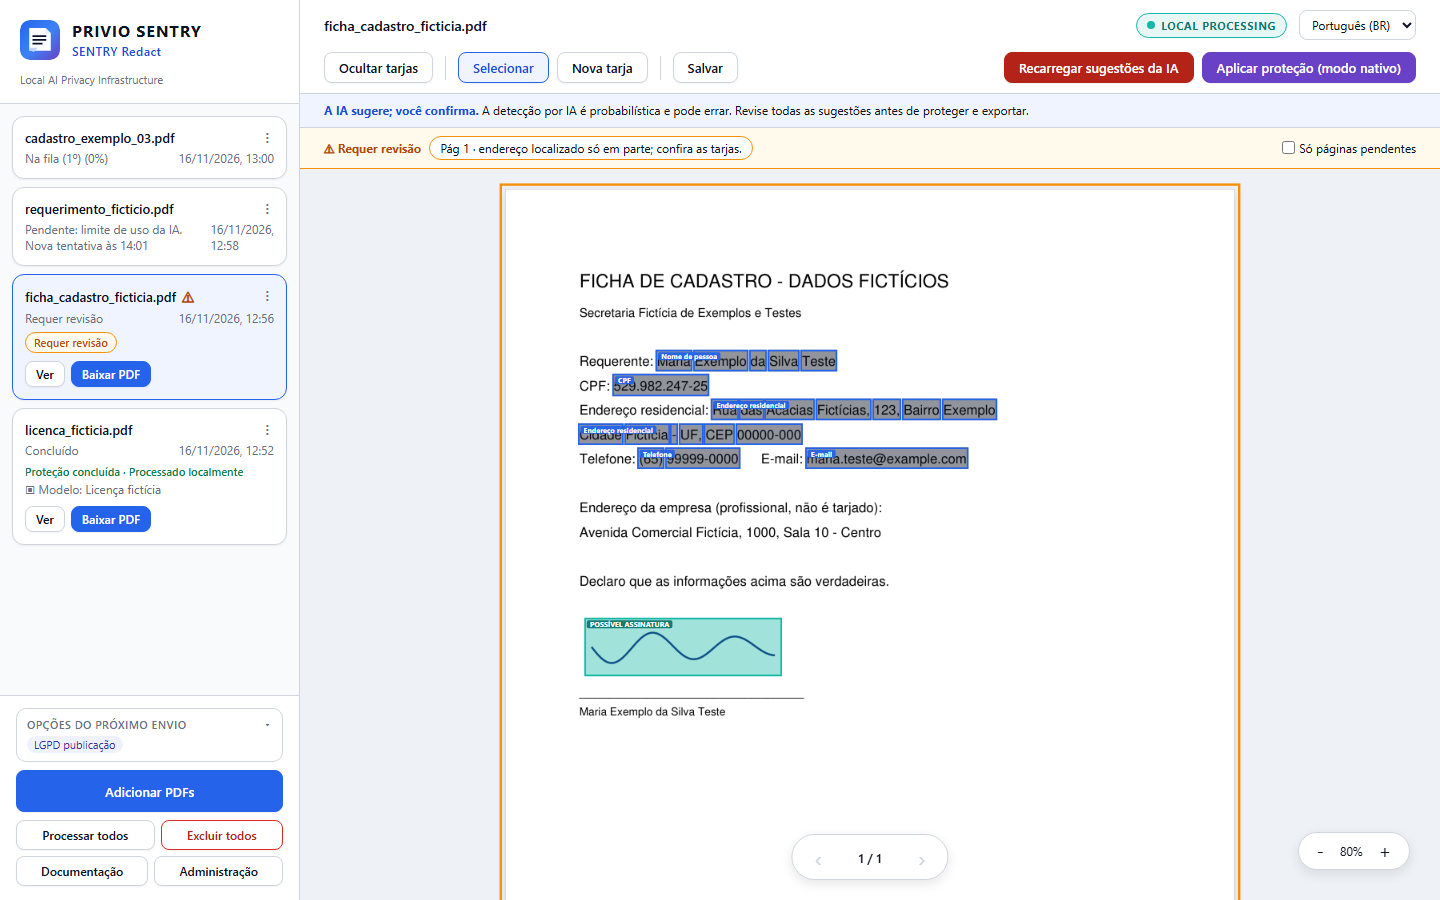
Encontra CPFs e endereços pessoais em PDFs, sugere as tarjas e leva tudo para revisão humana num editor web



⚡ Instalar • 🚀 Usar • 📘 Manual • 📖 Documentação • ⚠️ Limitações • 📋 Novidades • 🐞 Relatar problema • 🌐 English • ☕ Doe um café
Proteja os dados antes que sejam expostos. · Detectar. Revisar. Proteger.
📌 O que faz
O PRIVIO SENTRY é um projeto local-first para detectar e proteger informações pessoais em documentos.
Sua primeira (e, por enquanto, única) capacidade, o SENTRY Redact, lê arquivos PDF, encontra CPFs e
endereços pessoais (residenciais) e prepara as tarjas para uma pessoa revisar num editor web. OCR,
detecção e os modelos de linguagem/visão rodam na sua máquina por padrão: o conteúdo dos documentos só vai a
um provedor de IA na nuvem se um administrador liberar isso de propósito (AI_ALLOW_EXTERNAL, desligado).
Projeto pessoal e independente de Joberth Firmino Gambati: não é um produto oficial de nenhuma instituição nem fala em nome dela.
Status: estágio inicial. Utilizável, mas jovem: escopo restrito (CPF e endereços pessoais), medido
apenas em dados sintéticos e ainda sem trilha de auditoria. Espere mudanças incompatíveis.
Marca: o código é AGPL-3.0-or-later, mas os nomes e logotipos não são cobertos por essa licença. Veja
TRADEMARKS.md.
🧭 Princípio
A IA sugere. A política restringe. O humano confirma. O sistema registra.
| Como funciona hoje | |
|---|---|
| 🤖 A IA sugere | Os modelos só apontam detecções potenciais; cada uma vira uma caixa editável que a pessoa aceita, move, redimensiona ou remove |
| 🙋 O humano confirma | O processamento automático gera só um PDF preliminar, com as sugestões da IA; a versão para uso sai quando o revisor confere as caixas e clica em Aplicar proteção |
| 🔒 Falha fechado | Na dúvida (IA falhou, CPF do original sem tarja, página não verificada), o documento fica como "Requer revisão" em vez de "Concluído", com alertas por página |
| 📜 Política e registro | Hoje a política é fixa (CPF + endereços pessoais) e o único registro é o log da tarefa. Motor de políticas configurável e trilha de auditoria estão planejados, não implementados (Visão) |
⚠️ Leia primeiro: é uma ferramenta de apoio, não uma garantia
Esta ferramenta NÃO garante anonimização total. A detecção por IA é probabilística. Erros de OCR,
manuscritos, digitalizações ruins, layouts incomuns e falhas dos modelos podem deixar dados pessoais
visíveis; também pode tarjar mais do que o necessário.
- Toda saída deve ser revisada por uma pessoa antes de ser publicada ou compartilhada.
- "Concluído" significa nenhum alerta pendente nas verificações automáticas, e não que o documento
esteja garantidamente limpo. - O que é tarjado depende do perfil de política (
POLICY_PROFILE). O padrão cobre só CPF e
endereço residencial; os perfis LGPD, GDPR e saúde acrescentam RG, CNH, título de eleitor, PIS/NIS, Cartão SUS, passaporte, CTPS, telefone, e-mail, dados bancários, chave Pix, data de nascimento, placa e IP
(catálogo). Nomes e filiação são detectados com o GLiNER local opcional
(NER_ENGINE=gliner). Ainda não são detectados: rostos, dados sensíveis
(saúde, religião...), QR codes e metadados (limitações,
modelo de ameaças). - Nunca use documentos reais para relatar bugs ou em testes (SECURITY.md).
⚖️ Posicionamento frente à LGPD
O PRIVIO SENTRY é um controle técnico que pode apoiar práticas de privacidade e segurança, inclusive as
relacionadas à LGPD (Lei 13.709/2018). Ele não é um motor de "conformidade com a LGPD", não é
aconselhamento jurídico e seu uso não torna, por si só, nenhum documento ou processo conforme: isso depende de
finalidade, base legal, necessidade, governança, ciclo de vida dos dados e papéis.
Processamento local é uma escolha de arquitetura, não uma conclusão jurídica; as garantias reais dependem da
sua implantação (rede, logs, arquivos temporários, comportamento dos modelos). O rótulo LOCAL PROCESSING
da interface indica onde o processamento ocorre; não afirma que a máquina esteja offline.
A LGPD distingue dado pessoal de dado pessoal sensível (saúde, biométrico, genético...). Hoje só CPF e
endereços residenciais (dados pessoais) são alvo. Veja
docs/brand/LGPD_PRODUCT_POSITIONING.md e as fontes oficiais:
LGPD ·
ANPD.
🔍 O que o SENTRY Redact faz hoje
| Etapa | O que acontece |
|---|---|
| 🖼️ Renderização + OCR | Cada página vira imagem e passa pelo Tesseract (com coordenadas de cada palavra) |
| 🔢 CPFs | Duas passagens de OCR; validação pelos dígitos verificadores; CNPJs poupados; datas e horas excluídas |
| ✍️ Assinaturas | Detector YOLO recorta as assinaturas; OCR + LLM de visão (Ollama) procuram CPFs manuscritos ou difíceis de ler |
| 🏠 Endereços | O LLM de visão descobre os endereços e os classifica (pessoal / profissional / secundário); só os pessoais são tarjados, por casamento determinístico com as palavras do OCR |
| 📄 Exportação | PDF final por tarja nativa sobre o original (remove o texto e queima os pixels) ou por páginas rasterizadas, mais um JSON com as caixas |
| ✅ Verificação pós-tarja | Relê a saída e confronta o original (OCR em DPI maior) para garantir que todo CPF encontrado esteja coberto |
| 🖊️ Editor web | Adicionar, mover, apagar e aprovar tarjas antes de gerar o PDF final |
Como funciona
flowchart LR
    A[📄 PDF] --> B[🖼️ Renderização<br>+ OCR Tesseract]
    B --> C[🔢 CPFs<br>dígitos verificadores]
    B --> D[✍️ Assinaturas<br>YOLO + LLM de visão]
    B --> E[🏠 Endereços<br>LLM de visão]
    C --> F{{🖊️ Revisão humana<br>no editor}}
    D --> F
    E --> F
    F --> G[🔒 Tarja nativa<br>ou raster]
    G --> H{✅ Verificação<br>pós-tarja}
    H -- sem alertas --> I[Concluído]
    H -- dúvida --> J[⚠️ Requer revisão]
    J --> F
Destaques
- Decisor local que aprende (experimental): um modelo de decisão local
(Laya, Apache-2.0, roda na CPU) dá uma segunda opinião
calibrada sobre os endereços e aprende com as correções do revisor. Um novo perfil só entra se passar
num portão de qualidade, e o decisor nunca tira uma tarja. Desligado por padrão: veja
docs/decisions.md. - Local-first: OCR, YOLO e LLM rodam na máquina; a interface não carrega fontes, scripts nem imagens
externas (os testes de interface verificam isso). - IA na nuvem só se você liberar: com uma chave de API, a fase de IA pode usar um provedor externo
(OpenAI, Anthropic, Gemini, OpenRouter, Mistral...). Fica bloqueada por padrão. Liberada na
Administração, as páginas vão para o provedor, a tarefa registra para onde e o selo vira EXTERNAL AI
(docs/configuration.md). - Modelos de documento: licenças e formulários de layout conhecido são reconhecidos por frases fixas e
tarjados pelos rótulos sem IA (zero token); depois, uma inspeção (regras e um agente lendo o texto já
tarjado) procura o que ficou de fora. Os modelos são criados no gerenciador a partir de um documento revisado,
com ajuda opcional da IA sobre texto mascarado (docs/modelos-documento.md). - Modular, Docker e Kubernetes: app, servidores de IA e dados em máquinas ou pods separados; manifestos com
rede fechada por padrão emdeploy/k8s(docs/deploy.md). - Administração na interface: IA principal e reserva (com teste de conexão), detecção, OCR, fila e retenção
em/admin, sem editar o.env. - Portal, API e agentes: o mesmo serviço atende o editor, scripts (docs/api.md) e agentes de
IA por um servidor MCP local (docs/mcp.md). Agentes enviam e acompanham; quem aprova é o
revisor humano. - Falha fechado: qualquer incerteza vira alerta e o estado "Requer revisão"; a CLI devolve o código
3nesses casos. - Seguro por padrão: escuta só em
127.0.0.1, valida uploads e IDs (UUID), token opcional (API_TOKEN)
e segredo interno entre os workers e o serviço. - Interface acessível: pt-BR por padrão com seletor en-US, contraste WCAG AA, foco visível e atalhos
N/P/Esc.
🧾 Critérios de dados pessoais
O catálogo de PII lista cada tipo de dado pessoal com o enquadramento em LGPD
(art. 5º, I e II), GDPR (art. 4, 9 e 10), ISO/IEC 29100, NIST SP 800-122 e HIPAA Safe Harbor, o
nível (identificador direto, dado pessoal, dado sensível, identificador indireto) e como é detectado. Os
perfis de política dizem o que tarjar ou só alertar:
Perfil (POLICY_PROFILE) |
Para quê |
|---|---|
cpf_endereco (padrão) |
Comportamento original: CPF e endereço residencial |
lgpd_publicacao |
Publicar documentos (LAI art. 31): documentos, contato, financeiro e nascimento tarjados; indiretos e sensíveis alertados |
lgpd_interno |
Circular internamente: documentos e financeiro tarjados; contato e sensíveis alertados |
gdpr |
Identificadores diretos e online (inclui IP) tarjados; categorias especiais alertadas |
saude_hipaa |
Identificadores da lista Safe Harbor que o projeto detecta, tarjados |
Detectar e tarjar esses tipos apoia práticas alinhadas a essas referências; não torna um documento
"conforme". A API só de leitura GET /policy/catalog e GET /policy/profiles expõe catálogo e perfis.
💻 Requisitos
| Item | Versão |
|---|---|
| Python | 3.10 – 3.12 |
| Tesseract OCR | 5.x com o idioma português (por) |
| Servidor de IA | Ollama, LM Studio, vLLM, llama.cpp ou um servidor da organização (API no padrão da OpenAI), com um modelo de visão (ex.: Qwen3.5 9B, Gemma 4) |
| Hardware | RAM/VRAM compatível com o modelo escolhido. O DPI de renderização padrão é alto: reduza BASE_DPI em máquinas modestas |
| Detector de assinaturas | models/signature_stamp_detector.pt (incluído; veja o model card) |
⚡ Instalação
Windows
- Instale o Tesseract (por exemplo, o instalador UB-Mannheim) marcando o idioma Português. Anote o
caminho dotesseract.exe. - Instale o Python 3.10–3.12 e o Ollama.
- No PowerShell:
git clone https://github.com/Yiuky/PrivioSentry.git; cd PrivioSentry
python -m venv venv; .\venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env   # defina TESSERACT_PATH=C:\Program Files\Tesseract-OCR\tesseract.exe
Linux (Debian/Ubuntu)
sudo apt-get install -y tesseract-ocr tesseract-ocr-por tesseract-ocr-eng libgl1
git clone https://github.com/Yiuky/PrivioSentry.git && cd PrivioSentry
python3 -m venv venv && . venv/bin/activate
pip install --extra-index-url https://download.pytorch.org/whl/cpu torch torchvision   # PyTorch só CPU (opcional, menor)
pip install -r requirements.txt
cp .env.example .env     # depois edite
Modelos do Ollama
ollama serve                         # se ainda não estiver rodando
ollama pull <seu-modelo-de-visao>    # ex.: qwen2.5vl:7b
Defina OLLAMA_MODEL e OLLAMA_VISION_MODEL no .env. Para um GGUF próprio, veja
scripts/ollama/Modelfile.example.
Outro servidor de IA (LM Studio, vLLM, llama.cpp, servidor da organização): AI_PROVIDER=openai,AI_BASE_URL=http://localhost:1234/v1 e AI_VISION_MODEL=<modelo>. Uma IA reserva (AI_SECONDARY_*) assume
quando a principal cai, e um disjuntor desliga a IA que falha seguidamente (configuração).
Opcionais medidos (benchmarks): nomes com GLiNER (pip install -e ".[nomes]",NER_ENGINE=gliner), uma terceira leitura de OCR somada às duas do Tesseract (pip install -e ".[ocr-extra]",OCR_EXTRA_ENGINE=rapidocr) e o segundo olhar (SECOND_LOOK=1): um agente local revê as páginas em dúvida e só
acrescenta proteção.
Na interface, o painel Opções do próximo envio escolhe, por documento, o perfil de proteção, se procura nomes e
se é um documento de baixa qualidade (manual).
Docker (opcional)
docker compose up --build # app em http://127.0.0.1:8001 ; o Ollama roda no host
Antes de distribuir imagens Docker, leia a ressalva de licenciamento em docs/licensing.md.
⚙️ Configuração
A forma mais simples é a tela Administração (botão na barra lateral do editor, ou /admin): servidores de IA,
detecção, OCR, fila e retenção, com teste de conexão. Para o resto, copie .env.example para .env. Todas as
variáveis estão em docs/configuration.md. As principais:
| Variável | Para quê |
|---|---|
TESSERACT_PATH |
Caminho do executável do Tesseract (Windows) |
AI_PROVIDER, AI_BASE_URL, AI_VISION_MODEL (ou OLLAMA_*) |
Servidor de IA (Ollama ou API da OpenAI) e modelos; AI_SECONDARY_* para a reserva |
AI_API_KEY, AI_ALLOW_EXTERNAL |
Chave do provedor e liberação explícita de IA fora desta rede (desligada por padrão) |
PORTAL_ENABLED, ADMIN_ENABLED |
Rodar só como API e desligar a Administração |
POLICY_PROFILE, NER_ENGINE |
O que tarjar (perfil de política) e o detector de nomes |
YOLO_MODEL_PATH |
Pesos do detector de assinaturas |
BASE_DPI |
DPI de renderização das páginas (qualidade × memória × tempo) |
APP_HOST, API_TOKEN |
Endereço de escuta e token de acesso (obrigatório fora do 127.0.0.1) |
VERIFY_OCR |
Liga/desliga a verificação pós-tarja por OCR |
🚀 Uso rápido
Aplicação web (com editor)
python app_service.py          # http://127.0.0.1:8001   (ou scripts/run_app.sh | scripts/run_app.bat)
# painel liga/desliga opcional + proxy reverso na :8000:
python gatekeeper.py           # http://127.0.0.1:8000/gatekeeper
- Envie os PDFs e aguarde o processamento.
- Abra o editor: as páginas marcadas para revisão ficam destacadas.
- Ajuste as caixas e clique em Aplicar proteção (modo nativo).
Para expor o serviço na rede, defina APP_HOST=0.0.0.0 e API_TOKEN, e coloque-o atrás de HTTPS
(proxy reverso): não há TLS nem contas de usuário embutidos.
API e agentes de IA
curl -F "[email protected]" http://127.0.0.1:8001/upload       # -> task_id
curl http://127.0.0.1:8001/tasks/<task_id>                        # situação
curl -o protegido.pdf "http://127.0.0.1:8001/download/<task_id>?final=true"   # só após a aprovação no portal
python sentry_mcp.py                                              # servidor MCP local (stdio) para agentes
Rotas, autenticação e modo só-API em docs/api.md; configuração do cliente MCP em
docs/mcp.md (a Administração mostra o trecho pronto).
Linha de comando (lote)
python main.py --input caminho/arquivo_ou_pasta --output caminho/resultados
| Código de saída | Significado |
|---|---|
0 |
Todos os documentos concluídos |
3 |
Ao menos um documento requer revisão |
1 |
Erro |
Teste com o exemplo sintético (dados fictícios):
python examples/make_sample_pdf.py            # gera examples/sample_input.pdf
python main.py --input examples/sample_input.pdf --output saida
🏗️ Arquitetura
Navegador ─► gatekeeper.py (:8000, opcional) ─proxy─► app_service.py (:8001, FastAPI)
              liga/desliga + watchdog                   │ tasks.json (gravação atômica)
                                                        └─ um processo worker por tarefa ─► main.py (SentryApp)
                                                               ├─ utils/ocr_engine.py       Tesseract
                                                               ├─ utils/yolo_engine.py      assinaturas (YOLO)
                                                               ├─ utils/ai_client.py        LLM de visão (Ollama)
                                                               ├─ utils/address_redactor.py endereços
                                                               ├─ utils/session.py          pastas, logs, PDF final
                                                               └─ utils/verifier.py         verificação pós-tarja
Detalhes em docs/architecture.md; convenções e armadilhas para quem for alterar o
código em AGENTS.md.
🧪 Testes
pip install -r requirements-dev.txt
ruff check .                     # lint
pytest --ignore=tests/ui         # unidade e integração (sem Ollama nem GPU: LLM e YOLO são simulados)
playwright install chromium      # uma vez
pytest tests/ui                  # interface no navegador (identidade, acessibilidade, segurança)
python scripts/audit_public_tree.py   # auditoria de dados pessoais e segredos antes de publicar
O CI do GitHub roda o lint, a suíte em Python 3.10, 3.11 e 3.12 (com cobertura) e os testes de interface.
Os números de detecção, medidos só em dados sintéticos, estão em docs/benchmarks.md.
🔭 Visão (futuro, não implementado)
A direção de longo prazo é uma camada local de processamento de privacidade para documentos, APIs, sistemas
de IA e fluxos de trabalho. Hoje existe apenas o SENTRY Redact. Os módulos abaixo orientam o desenho, sem
datas e sem promessa de entrega:
| Módulo (visão) | Papel pretendido |
|---|---|
| SENTRY Detect | Detectar e classificar informação sensível candidata (dados pessoais, dados pessoais sensíveis, segredos, financeiro, personalizado). Próximo passo: o usuário escolhe o que tarjar (nomes, telefones, RG...), com regras validadas, nomes por GLiNER e exceções decididas pelo Laya (backlog B-71 a B-75) |
| SENTRY Mask / Transform | Mascaramento/substituição e pseudonimização como operações explícitas, controladas por política |
| SENTRY Gateway | Fronteira de privacidade para o tráfego a IAs/APIs externas |
| SENTRY Audit | Evidências (hashes, proveniência de modelo/política) sem guardar valores sensíveis brutos |
O trabalho pendente e as prioridades estão no BACKLOG.md. Diretrizes de marca, design e UX:
docs/brand/.
🚧 Limitações
- Rostos e dados sensíveis (saúde, religião...) ainda não são detectados; nomes só com o GLiNER ligado; os demais
tipos dependem do perfil de política (catálogo). - Revocação da detecção e da verificação medida só em dados sintéticos; digitalizações reais podem ser
piores. - Manuscritos e digitalizações de baixa qualidade são o ponto mais fraco; o detector de assinaturas tem
acurácia modesta. - A tarja de endereços depende da classificação por LLM e de casamento aproximado: pode tarjar a mais ou a
menos. - PDFs grandes são lentos (OCR em DPI alto + chamadas ao LLM + verificação).
Lista completa: docs/limitations.md.
🔐 Privacidade e segurança
O processamento é local por padrão. Um provedor de IA externo só recebe conteúdo com AI_ALLOW_EXTERNAL=1,
ligado na Administração; nesse caso, o que ele faz com os dados depende do contrato da sua organização. Os artefatos de cada tarefa (imagens das páginas, saída do OCR, recortes) ficam emoutput/ e contêm dados pessoais: apague-os quando não forem mais necessários (opções de retenção em
docs/configuration.md). Vulnerabilidades: relate de forma privada, conforme o
SECURITY.md.
❓ Perguntas frequentes
Preciso de internet ou de GPU?Internet só para instalar as dependências e baixar o modelo do Ollama. Depois, OCR, YOLO e LLM rodam na sua
máquina. GPU não é obrigatória, mas acelera muito o LLM de visão; sem ela, prefira modelos menores e umBASE_DPI mais baixo.
Não necessariamente. "Concluído" significa que as verificações automáticas não deixaram alerta pendente. A
detecção é probabilística e só cobre CPF e endereços pessoais: sempre revise antes de publicar.
No perfil padrão (cpf_endereco), é uma regra de negócio deliberada do caso de uso original. Nos perfis LGPD, GDPR e
saúde, com o GLiNER ligado (NER_ENGINE=gliner), nomes e filiação são procurados: confiança alta vira tarja sugerida,
média vira revisão. Veja as limitações.
O nativo aplica a tarja sobre o PDF original (remove o texto e queima os pixels), mantendo a qualidade. O
raster reconstrói o PDF a partir de imagens das páginas, com resolução menor e sem texto selecionável.
Detalhes no manual.
Dá para expor o serviço com APP_HOST=0.0.0.0 e API_TOKEN, atrás de um proxy HTTPS. Não há contas de
usuário, TLS nem trilha de auditoria embutidos: avalie isso antes de usar com dados sensíveis.
🤝 Contribuindo
- Como relatar problemas, sugerir melhorias e enviar código: CONTRIBUTING.md.
- Arquitetura, invariantes e armadilhas conhecidas: AGENTS.md.
- Trabalho pendente e prioridades: BACKLOG.md.
- Convivência: Código de Conduta.
- Nunca versione dados pessoais reais.
📝 Como citar
Se o PRIVIO SENTRY ajudou num trabalho acadêmico ou técnico, use o botão Cite this repository do GitHub
(gerado a partir do CITATION.cff).
🌐 English Abstract
PRIVIO SENTRY is a local-first, AGPL-licensed project for detecting and protecting personal data in
documents. Its first capability, SENTRY Redact, finds Brazilian CPF numbers and personal
(residential) addresses in PDF files and prepares redactions for a person to review in a web editor:
- Local pipeline: Tesseract OCR, a YOLO signature detector and a vision LLM served by Ollama, all running
on your machine by default (a cloud AI provider only with explicit permission); the UI loads no external
assets. - Human in the loop: the AI only suggests; automatic processing yields a preliminary PDF, and the protected
version comes from the reviewer applying the reviewed boxes in the editor. - Fails closed: a post-redaction verifier re-reads the output and cross-checks the original; any doubt
marks the document as needs review (CLI exit code3). - Honest scope: early stage, measured only on synthetic data, no audit trail yet, and it does not
guarantee anonymization. It can support LGPD-aligned practices but is not a compliance engine.
Full English documentation: README.en.md.
☕ Doe um café para o dev
O PRIVIO SENTRY é gratuito e de código aberto, desenvolvido nas horas vagas. Se ele economizou o seu tempo,
considere pagar um café para o desenvolvedor: ajuda a manter o projeto vivo e a trazer novos tipos de dado e
melhorias na detecção.
 |
Pix (qualquer valor) Chave aleatória: fcf8071f-416d-49f1-b4b9-3188d3d03c4bPix copia e cola: 00020101021126580014br.gov.bcb.pix0136fcf8071f-416d-49f1-b4b9-3188d3d03c4b5204000053039865802BR5917JOBERTH F GAMBATI6006CUIABA62070503***63048088Favorecido: Joberth Firmino Gambati |
👤 Autor e licença
- Desenvolvedor: Joberth Firmino Gambati (@Yiuky).
- Código-fonte: GNU AGPL-3.0 ou posterior. Se você distribuir uma versão modificada, ou
oferecê-la a usuários pela rede, deve fornecer o código-fonte sob a mesma licença. - Dependências e pesos do YOLO: NOTICE e docs/licensing.md.
- Nomes e logotipos: não cobertos pela AGPL; veja TRADEMARKS.md.
Reviews (0)
Sign in to leave a review.
Leave a reviewNo results found