mcd-points-actuary
Health Gecti
- License — License: MIT
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Community trust — 15 GitHub stars
Code Gecti
- Code scan — Scanned 12 files during light audit, no dangerous patterns found
Permissions Gecti
- Permissions — No dangerous permissions requested
Bu listing icin henuz AI raporu yok.
麦麦积分精算师 — 基于麦当劳中国 MCP,把「渠道费 / 券叠加 / 积分机会成本」统一折算到一个目标函数「到手成本 = 现金 + 积分 × 影子价格」,回答同一份订单在到店自取、麦乐送、美团、饿了么哪边到手最便宜、该叠哪几张券、要不要动积分;并给出积分价值矩阵(同积分价值差 13 倍)、抽奖期望值边界与到期止损方案(麦当劳程序员创意开发大赛参赛作品)
麦麦积分精算师 · MCD Points Actuary
点外卖这件事,钱已经有很多工具在算,积分几乎没人算。
本项目把「渠道费 / 券叠加 / 积分机会成本」折算到同一个目标函数上,
回答一句以前没人算得清的话:这单到底在哪买、用哪张券、要不要动积分,到手最便宜?



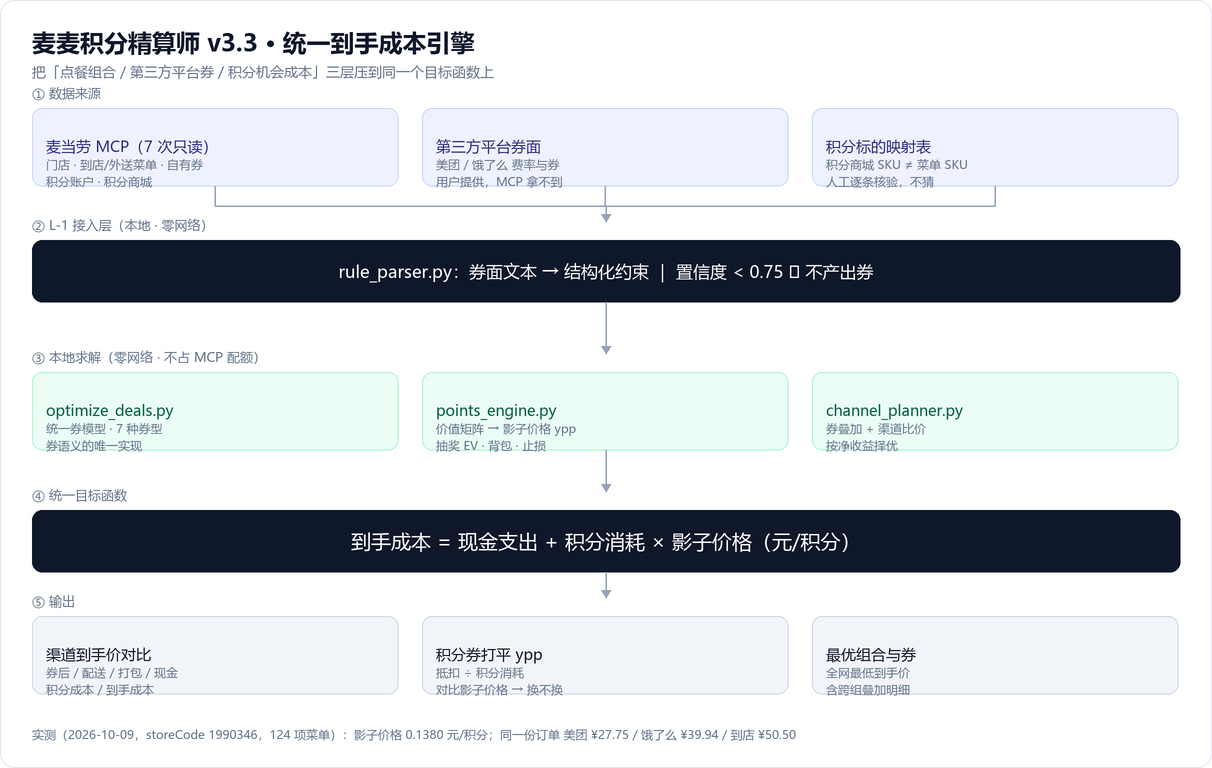
上图四个阶段的相邻两层之间没有网络调用:7 次只读 MCP 取数之后,
组合枚举、券叠加、积分折算全部在本地完成,不占用 MCP 计价配额。
一句话价值
同一份订单 —— 巨无霸 + 薯条 + 可乐,在麦当劳南京新百餐厅(storeCode=1990346)实查菜单下:
| 渠道 | 券后商品 | 配送 | 打包 | 实付现金 | 用到券 | 到手成本 |
|---|---|---|---|---|---|---|
| 美团外卖 | ¥22.75 | ¥3.50 | ¥1.50 | ¥27.75 | 半价周末·巨无霸 5折 + 买薯条送可乐 + 必点榜减5 | ¥27.75 |
| 饿了么 | ¥34.44 | ¥4.50 | ¥1.00 | ¥39.94 | 店铺满35减10 + 整单88折 | ¥39.94 |
| 麦当劳 · 到店自取 | ¥50.50 | ¥0.00 | ¥0.00 | ¥50.50 | 无 | ¥50.50 |
| 麦当劳 · 麦乐送 | ¥50.50 | ¥0.00 | ¥0.00 | ¥50.50 | 无 | ¥50.50 |
选对渠道 + 选对券,比最贵的组合省 ¥22.75(−45%)。 而这还没算积分那一层 —— 见下。
统一目标函数
三层变量(渠道 × 券 × 用现金还是用积分)被压到一个式子上:
到手成本 = 现金支出 + 积分消耗 × 积分影子价格(元/积分)
关键在于「积分影子价格」不是拍脑袋设的常数,而是由积分商城实测算出来的 ——
"这些积分拿去做最优兑换,能保证换回多少现金"。它让"花 500 积分省 24 元"
这类决策第一次可以被判定为亏损,而不是凭感觉。
真实积分商城的实测结果(2026-10-09):周期内最优兑换 0.1380 元/积分,最差 0.0274。
一个数不够:影子价格要并列三种口径
0.1380 是"积分商城里最划算的那一档",不是"你手上这些积分"的价值。把两者混为一谈,
会系统性高估积分、把本来划算的抵扣误判成亏损。所以本项目不再只给一个数,而是并列摆出三档,
每一档都写清楚它是怎么算的、什么时候该用:
| 口径 | 定义 | 怎么算 | 该在什么时候用 |
|---|---|---|---|
| 最优标的效率 | 周期内效率最高的那件标的 | max(面值 ÷ 积分) |
主口径,对外公布、跨期可比;刻意保守,杜绝"积分不值钱"的过度乐观 |
| 保守分位(P25) | 历史各期最优效率的 25% 分位 | shadow_price.py 时间序列 |
历史攒够多期后,给出"至少不会比这更差"的下界;样本不足时明确降级而不是假装有 |
| 余额处边际效率 | 在你的余额处,最后一份积分还能换回什么 | 有界背包在余额处的边际值 | 判断"这一单该不该花积分" —— 它才是这笔决策的机会成本 |
主口径仍然是 0.1380,本文与对外数字一律以它为准;保守分位与边际效率并列展示,
用于说明结论的适用边界,不改动任何已公布的结论。
为什么必须并列:0.1380 会在余额偏大时高估 100%
原因很朴素 —— 最优标的是限量的。「50 积分换 6.9 元派」每人每月通常只能换 1 次,
换完之后下一档是 0.1090、再下一档 0.0358……所以 0.1380 只对最前面那几十个积分成立。
expiry_policy.py 把这个"效率断崖"直接算出来(有界背包的精确解,不是估的):
余额 1500 积分 · 距到期 36 天

影子价格(这是本模块的核心产出):
  最优标的效率(v3 现用口径)  0.1380 元/积分   ← 只对最前面那几十个积分成立
  余额处平均效率               0.0594 元/积分   ← 全部积分摊平后的真实产出
  余额处**边际**效率 ← 建议用  0.0000 元/积分   ← 最后一份积分还能换回什么
  现用口径的高估幅度           0.1380 元/积分(100.0%)

有效兑换容量 1300 积分(再多积分也换不出更多价值)· 死积分 200 积分
同一套代码在余额 50 积分时,三档全部等于 0.1380(高估幅度 0.0%)—— 差异从哪来、
什么时候来,是可复算的,不是话术。
于是下面这张表可以被算出来:
| 积分餐品券 | 所需积分 | 菜单单点价 | 打包价 | 抵扣 | 打平 ypp | 判定 |
|---|---|---|---|---|---|---|
| 17.9元板烧可乐组合 | 500 | ¥33.00 | ¥17.90 | ¥15.10 | 0.0302 | ❌ 不划算 |
| 21.9元巨无霸可乐组合 | 800 | ¥36.00 | ¥21.90 | ¥14.10 | 0.0176 | ❌ 不划算 |
| 16.9元中薯麦乐鸡组合 | 200 | ¥28.50 | ¥16.90 | ¥11.60 | 0.0580 | ❌ 不划算 |
| 28.8元巨无霸四件套 | 800 | ¥32.00 | ¥28.80 | ¥3.20 | 0.0040 | ❌ 不划算 |
打平 ypp = 抵扣额 ÷ 积分消耗。 只有它低于影子价格(主口径 0.1380),用这张券才亏。
上表 6 张券全部远低于基准 —— 结论很反直觉:积分商城里"抵得最多"的券,恰恰是最不该换的。
终端里的真实样子(含 ①积分定价 与 ②积分券打平线 两段,原始输出见docs/captures/unified-live.txt):
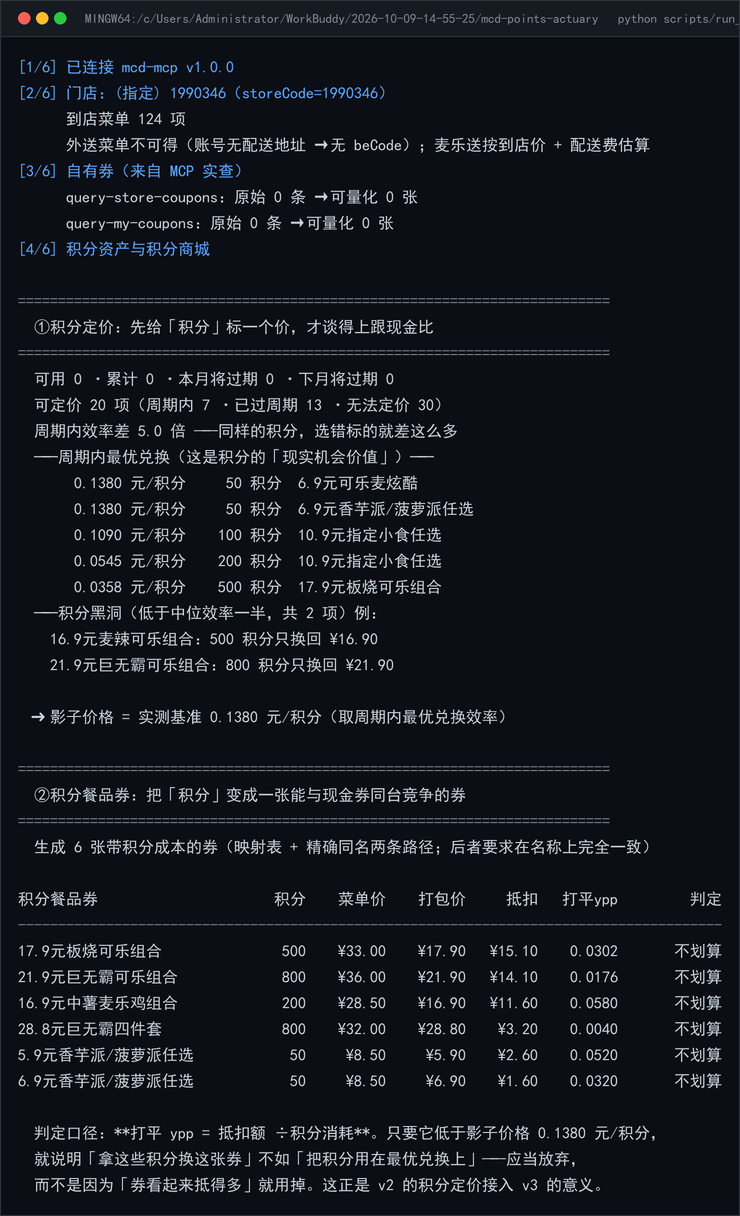
同样的券,如果你有积分即将过期(
--shadow-ypp 0,视为沉没成本),立刻全部变成划算。
两种口径的差异,就是"积分到期前该不该突击兑换"的量化答案。
三层能力叠在一起
| 层 | 回答 | 引擎 | 在统一目标函数里的角色 |
|---|---|---|---|
| L1 · 点餐组合 | 买哪几件? | optimize_deals.py |
枚举候选组合 + 券语义唯一实现 |
| L2 · 积分资产 | 积分值多少钱? | points_engine.py |
产出 影子价格 ypp,给"积分"标价 |
| L3 · 渠道 × 券 | 在哪买?用哪张券? | channel_planner.py |
把三层折到同一个 到手成本 上 |
L2 是 L3 的度量基础:没有影子价格,渠道比较只能比现金,"要不要用积分"永远算不清。
L1 是 L3 的候选来源:渠道价差几乎全部来自券,所以候选池按"券能生效的商品"构造。
工作流(全程 7 次 MCP 调用)
① query-nearby-stores   → 门店(默认选营业中、距离最近)
② query-meals ×2        → 到店菜单 + 外送菜单(外送需 beCode,取不到则降级并声明)
③ query-store-coupons   → 门店可用券(到店)
   query-my-coupons     → 我的券
   available-coupons    → 可领取券(接口只给名称,列为"未建模",不猜测面额)
④ query-my-account      → 积分账户(到期提醒)
   mall-points-products → 积分商城 → 价值矩阵 → 影子价格

   ── 以下全部在本地完成,不占 MCP 配额 ──
   券叠加求解 → 全渠道组合枚举 → 到手成本排序 → 报告
真实响应里 structuredContent 已含服务端预解析的 JSON,客户端优先走这条路径,
比从"说明文字 + JSON"里正则捞取稳健得多(旧版本自动回退到文本提取)。
七个数学内核
| 内核 | 回答 | 做法 |
|---|---|---|
| 价值矩阵 | 同样积分换什么最值? | ypp = 面值 ÷ 积分,中位数识别陷阱,周期冲突降级为"待复核" |
| 抽奖期望 | 该换券还是抽奖? | 零概率信息下的分层夹逼(见下) |
| 券叠加 | 这堆券怎么组合最优? | 同 stack_group 互斥、跨组叠加、按净收益择优、整单券限张数 |
| 到手成本 | 在哪买最便宜? | 全渠道枚举 × 预算按"到手成本"判定,而非券后商品价 |
| 约束求解 | 组合多到枚举不完怎么办? | 表成 C1–C4 约束,分支定界求精确解,规模过大退化为束搜索并标注方法 |
| 影子价格时间序列 | 这个价格稳不稳? | 每期快照入档,按窗口取保守分位;样本不足就降级并说出来 |
| 跨期序贯策略 | 拖着晚点换行不行? | 有界背包的精确解 + 逐点边际曲线,给出有效兑换容量与"最晚开始日" |
亮点:MCP 不返回中奖概率,怎么判断抽奖划不划算?
query-lottery-info 只给奖品名称,不给概率。常规做法只能"猜",本项目改用分层夹逼,
让每个结论都带上它的成立条件:
| 判定 | 成立条件 | 含义 |
|---|---|---|
dominated |
奖池最高单项 < 打平线 |
必亏,不需要任何概率假设 |
robust |
假设「永不上头奖、其余等概率」仍划算 | 结论不依赖头奖命中率 |
likely |
全奖池等概率期望达标 | 倾向抽,但依赖头奖命中率 |
depends |
仅当头奖命中率 ≥ p 才划算 | 反解出一元不等式给出精确门槛 |
打平线 = 单次消耗积分 × 影子价格 —— 即"这些积分拿去兑换能保证拿到的价值"。
分层夹逼给的是"边界",lottery_mc.py 再补上"分布":在四种概率假设下各跑 2 万次
定点模拟(固定种子,可原样复现),除均值外还给出亏损概率与分位数:
══ 跨概率假设压力测试(20,000 次 × 33 抽,种子 20261009)══
假设             均值/抽      实测 ypp   单次亏损概率   合计亏损概率
uniform            ¥8.20   0.3418 元/积分       37.9%         0.0%
pessimistic        ¥6.92   0.2882 元/积分       43.2%         0.0%
long_tail          ¥4.56   0.1900 元/积分       67.4%         7.0%
optimistic        ¥13.09   0.5454 元/积分        9.3%         0.0%
均值稳稳高于打平线 ¥3.31,但单次亏损概率最高到 67.4% ——
"期望值为正"和"这一抽不会亏"是两回事。均匀与悲观两种假设有闭式解,
蒙特卡洛均值必须与它对上(差 3 分左右,抽样误差内),这是唯一能证明"模拟没写错"的硬校验。
亮点:券叠加不再靠"逐张贪心",而是解一个约束问题
v3 的券叠加是"逐张试、留更优"的贪心。它在商品池这一层会算错。最小反例:
购物车:A ¥10 + B ¥10
可用券:「A 单品5折」(互斥组 g1) + 「A 免单」(互斥组 g2)

旧实现:抵扣 ¥15.00 → 应付 ¥5.00    ← 错:把 A 抵成负数,多出的 ¥5 记到 B 头上
新实现:抵扣 ¥10.00 → 应付 ¥10.00   ← 对:A 一共只值 ¥10
coupon_solver.py 把问题显式表成四条约束,而不是继续打补丁:
| 约束 | 含义 |
|---|---|
| C1 组内互斥 | 同一 stack_group 只能有一张生效(空组视为同一默认组) |
| C2 整单券限张 | max_stack 限制整单级券张数;单品级属平台定价,不占额度 |
| C3 商品池 | 每件商品被抵扣总额 ≤ 标价 —— 就是上面那个反例 |
| C4 适用条件 | 门槛、商品范围、张数上限 |
规模小时分支定界求精确解(结果里标 method=exact,附带剪枝前后节点数);
规模超限自动退化为束搜索,并把 method=beam 写进结果 —— 用了近似就说用了近似。
与旧实现对拍 2548 组购物车 × 4 档影子价格 = 0 处不一致(在旧实现本就正确的问题上),
而上面那个反例被单独钉成回归用例。引擎通过 apply_coupons(..., engine=...) 切换,
默认仍是旧引擎,所以已公布的任何数字都不会因为这次重构而移动。
核心特性
- 🎯 一个目标函数管三层:渠道费、券叠加、积分机会成本统一折算
- 🧭 积分定价让"该不该用券"可判定:算出每张券的打平影子价格,一句话给结论
- 📐 影子价格三档并列:最优标的效率(主口径 0.1380)/ 历史保守分位 / 你余额处的边际效率
—— 余额 1500 时前者高估 100%,差异是算出来的,不是话术 - 🧱 券叠加显式建模:单品级先落地 → 整单级按余额判定 → 同组互斥、跨组叠加、限张数
- 🧮 券组合是约束求解,不是贪心:C1–C4 四条约束 + 分支定界精确解,方法(exact/beam)写进结果
- 🛡️ 拒绝模糊推断:积分商城 SKU 与菜单 SKU 不一致时丢弃而非猜测
(实测「18.8元板烧鸡腿堡两件套」会被错配到菜单「板烧鸡腿堡三件套」) - 🕳️ 积分黑洞预警:给出每个低效标的的机会成本金额
- ⏳ 跨期序贯策略:有界背包精确解 → 有效兑换容量、死积分数量、最晚开始日、
建议日均消耗速率;"再拖 20 天会少挽回多少"是可算的 - 🎲 抽奖给出分布而不只是期望:四档概率假设 × 2 万次定点模拟,输出亏损概率与分位数
- 🗂️ 影子价格入档:每期快照存
data/shadow_price_history.json,历史不足时明确降级,不假装有 - 🧾 金额全程以「分」整数计算,无浮点误差
- 🔌 离线可测 + 离线可跑:243 项单元测试全绿;
--offline无需 Token 即可复现全流程 - 🚦 限流友好:全流程 MCP 调用次数为个位数
目标用户
| 人群 | 痛点 | 本 Skill 的价值 |
|---|---|---|
| 点外卖的麦麦会员 | 到店/麦乐送/美团/饿了么,不知道哪边便宜 | 直接给各渠道到手价对比与最优选择 |
| 手上一堆券的人 | 平台券 + 商家券 + 必点榜券,不知道能不能叠 | 按声明口径求解最优券组合 |
| 攒了积分的人 | 积分躺在账户里,不知道换什么 | 全量价值矩阵 + 黑洞清单 + 最优兑换组合 |
| 收到"积分将过期"提醒的人 | 知道要过期,不知道该换什么止损 | 最快的消耗路径 + 剩余损失金额 + 沉没成本口径的决策 |
| 爱抽奖的用户 | 不知道抽奖是不是在烧积分 | 给出抽与不抽的判定条件 |
安装方法
1. 申请麦当劳 MCP Token
访问 https://open.mcd.cn/mcp → 右上角「登录」(手机号验证)→「控制台」→「激活」→ 复制 Token。
2. 配置 MCP 连接器
将 mcp-config.example.json 中的 ${MCD_MCP_TOKEN} 替换为实际 Token,填入你的 MCP Client(WorkBuddy / Cursor / Cherry Studio / Trae 等):
{
  "mcpServers": {
    "mcd-mcp": {
      "type": "streamablehttp",
      "url": "https://mcp.mcd.cn",
      "headers": { "Authorization": "Bearer YOUR_MCP_TOKEN" }
    }
  }
}
3. 设置环境变量(脚本层需要)
export MCD_MCP_TOKEN=你的Token        # Linux / macOS / Git Bash
setx MCD_MCP_TOKEN 你的Token          # Windows(需重开终端)
4. 运行
git clone https://github.com/akexin/mcd-points-actuary.git
cd mcd-points-actuary
python -m unittest discover -s tests        # 118 项离线自检
python scripts/run_unified_live.py --offline  # 无需 Token 复现全流程
无需
pip install:本项目只依赖 Python 标准库。
使用示例
示例 A · 统一联调(真实 MCP,本项目的入口)
export MCD_MCP_TOKEN=你的Token
python scripts/run_unified_live.py --city 南京市 --keyword 新街口
python scripts/run_unified_live.py --store 1990346 --items 1100 4810 9900008751
python scripts/run_unified_live.py --store 1990346 --shadow-ypp 0   # 积分即将过期
真实运行输出(2026-10-09,麦当劳南京新百餐厅 1990346):
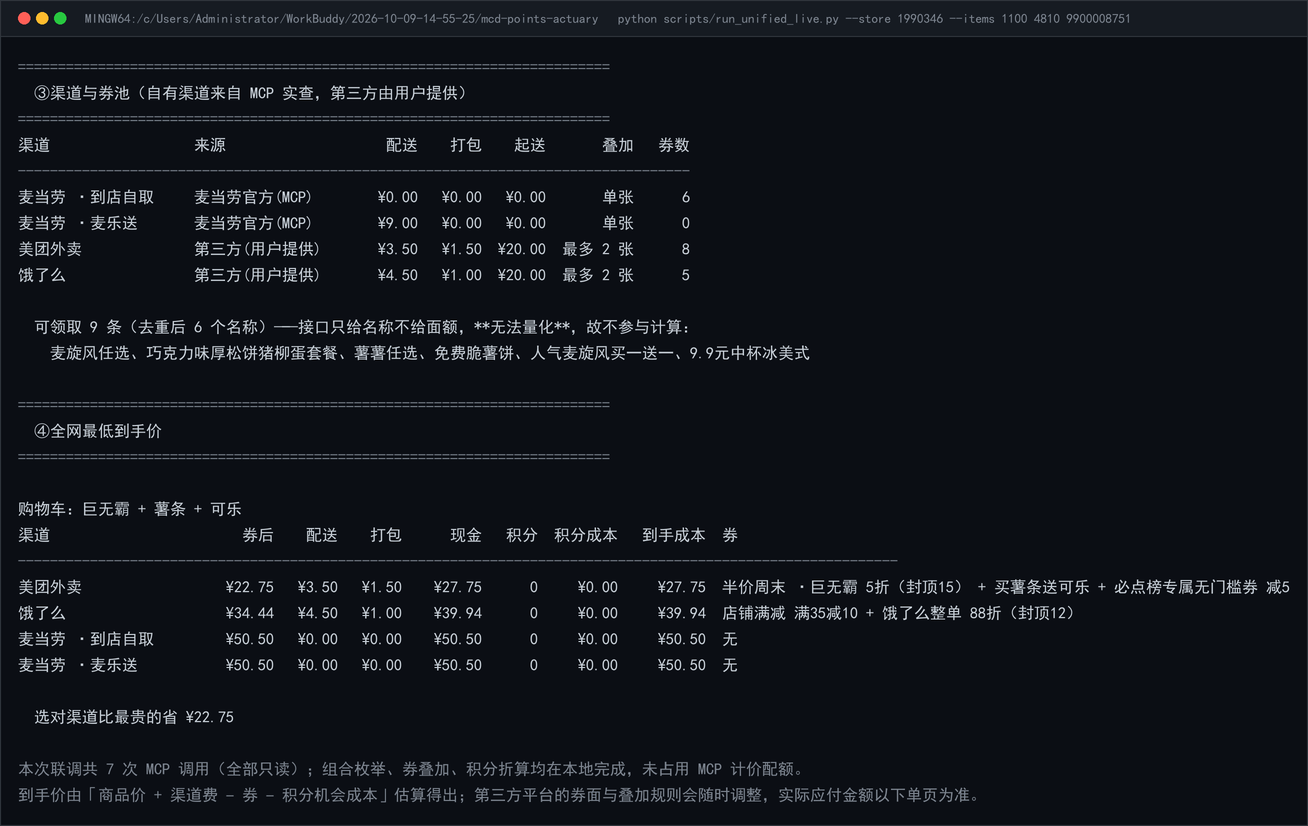
上图是原样渲染的真实 stdout —— ③ 列出各渠道费率与券数,④ 给出四个渠道的到手价对比。
输出里处处留着可复核的诚实标注:外送菜单不可得 … 按到店价估算、可领取 9 条(去重后 6 个名称)… 无法量化,故不参与计算、
以及末尾那句 实际应付金额以下单页为准。
逐字原文与复现命令:docs/captures/unified-live.txt
(74 行,由上表那条命令原样重定向得到);配图由tools/make_readme_assets.py 从该文件渲染 ——
所以改一个数字,图就跟着变,不存在"图和代码对不上"的可能。
示例 B · 离线体验(不需要 Token)
python scripts/run_unified_live.py --offline
python scripts/points_engine.py matrix --products data/sample_points_products.json
积分价值矩阵输出(节选,真实商城数据脱敏快照):
可定价标的 20 项(周期内 7 · 已过周期 13 · 无法定价 4)
中位效率 0.0695 元/积分
效率倍数差:全库 13.7 倍 | 周期内 5.0 倍
 1.    0.3760 元/积分     50 积分  18.8元麦辣鸡腿汉堡两件套  ← 已过周期·待复核
 4.    0.1380 元/积分     50 积分  6.9元可乐麦炫酷
20.    0.0274 元/积分    800 积分  21.9元巨无霸可乐组合  ← 陷阱
示例 C · 抽奖到底划不划算
python scripts/points_engine.py lottery \
  --lottery data/sample_lottery.json --products data/sample_points_products.json \
  --refs data/sample_reference_prices.json
单次消耗 24 积分 | 兑换基准 0.1380 元/积分
打平直接兑换所需期望价值:¥3.31
  最高单项 ¥17.25 | 最低 ¥1.00 | 全池等概率期望 ¥8.24 | 悲观期望 ¥6.95
判定:抽奖占优 —— 结论不依赖头奖命中率(ROBUST)
示例 D · 积分资产诊断
python scripts/run_points_live.py --city 南京市 --keyword 新街口 --points 1500 --expiring 800
【800 积分即将过期,止损方案】
  ① 兑换挽回 ¥92.10:18.8元麦辣鸡腿汉堡两件套 + … + 16.9元中薯麦乐鸡组合
  ② 余额抽奖 6 次(144 积分,按基准折价 ¥19.87)
  合计挽回 ¥111.97
  ⚠ 仍有 6 积分无法消耗,预计损失 ¥0.83
示例 E · 影子价格的历史与保守分位
python scripts/shadow_price.py report
  共 1 条快照:
    2026-10-10  门店 1990346    最优 0.1380  中位 0.0695  最差 0.0274  (周期内 7 项)

  口径                           建议值
    最新实测(主口径)     0.1380 元/积分  ← 主口径:对外公布、跨期可比,刻意偏保守
    保守分位(近窗 P25)   0.1380 元/积分  ← 下界:历史攒够多期后才与主口径分叉

  主口径 0.1380 · 保守 P25 0.1380 · 区间 [0.1380, 0.1380] · 样本 1 次 · 窗口 6
  历史样本仅 1 次(<6 次窗口要求)→ 保守分位退化为单点值,**不假装有历史**
样本只有 1 条时它明说自己退化了,而不是拿单点冒充"历史区间"。
每跑一次run_unified_live.py --record-shadow就往data/shadow_price_history.json
入档一条(按「门店+日期」去重,同日重复跑不会堆垃圾数据)。
攒够一个窗口之后,两个口径才真正分叉 —— 分叉的那一天,保守值会自己出现。
示例 F · 到期前的序贯兑换策略
python scripts/expiry_policy.py --balance 1500 --expiry 2026-11-15
余额 1500 积分 · 距到期 36 天(2026-11-15)

建议兑换 5 类、共 9 次:
  6.9元香芋派/菠萝派任选 × 2  → 花   100 积分换回 ¥13.80(单件 0.1380 元/积分)
  6.9元可乐麦炫酷 × 2  → 花   100 积分换回 ¥13.80(单件 0.1380 元/积分)
  10.9元指定小食任选 × 2  → 花   200 积分换回 ¥21.80(单件 0.1090 元/积分)
  10.9元指定小食任选 × 2  → 花   400 积分换回 ¥21.80(单件 0.0545 元/积分)
  17.9元板烧可乐组合 × 1  → 花   500 积分换回 ¥17.90(单件 0.0358 元/积分)

合计:花 1300 积分 · 挽回 ¥89.10 · 余 200 积分 · 相对最优解少拿 ¥0.00
建议日均消耗 36.1 积分

影子价格(这是本模块的核心产出):
  最优标的效率(v3 现用口径)  0.1380 元/积分   ← 只对最前面那几十个积分成立
  余额处平均效率               0.0594 元/积分   ← 全部积分摊平后的真实产出
  余额处**边际**效率 ← 建议用  0.0000 元/积分   ← 最后一份积分还能换回什么
  现用口径的高估幅度           0.1380 元/积分(100.0%)
  前向:再攒一份能多换回       0.0020 元/积分   ← 手上的分已换不完,别再攒

有效兑换容量 1300 积分(再多积分也换不出更多价值)· 死积分 200 积分

最晚开始日:2026-10-15(5 天后,还有 36 天到期)
两个名字很像的「10.9元指定小食任选」是两条不同的标的(100 分 / 200 分),
所以清单里它们分开列 —— 按名称合并会把结论改掉,这一条有专门的回归测试守着。最晚开始日也不是拍出来的:它是对「每期可兑换次数被到期日截断」做扫描求出来的
—— 再拖下去,可挽回金额会真的下降。
示例 G · 券组合的约束求解与两套口径
python scripts/coupon_solver.py --items data/sample_menu.json \
  --channels data/sample_channels.json --channel meituan \
  --cart BURGER-BIGMAC BURGER-DOUBLE-CHEESE CHICKEN-MCNUGGETS-5 --shadow-ypp 0.138
  渠道:美团外卖(券 6 张,可叠加 ≤ 2 张)
  购物车:巨无霸 + 双层吉士汉堡 + 麦乐鸡(5块) = ¥52.50

  ── order_mode=middle ──
    方法 exact · 单品级展开 2/2 状态(剪掉 0.0%)· 整单级试算 2 次
      半价周末·巨无霸 5折(item_discount)→ ¥12.25
      美团平台券 满39减8(threshold_reduce)→ ¥8.00
      麦当劳商家券 满30减8(threshold_reduce)→ ¥8.00
    抵扣 ¥28.25 · 积分 0 · 应付 ¥24.25 · 净收益 ¥28.25
    商品池占用:巨无霸 ¥12.25
「商品池占用」这一行就是约束 C3 的可视化:巨无霸一共只被抵了 ¥12.25(它标价的一半)。
两套整单级口径并列输出 ——middle(都在扣掉单品级优惠后的同一个余额上算)与sequential(逐张在上一张扣减后的余额上算),差异看得见,见「建模口径」第 2 条。方法 exact表示这是精确解;规模超限时会自动退化为beam并如实标注。
自检(243 项,全离线)
python -m unittest discover -s tests -v
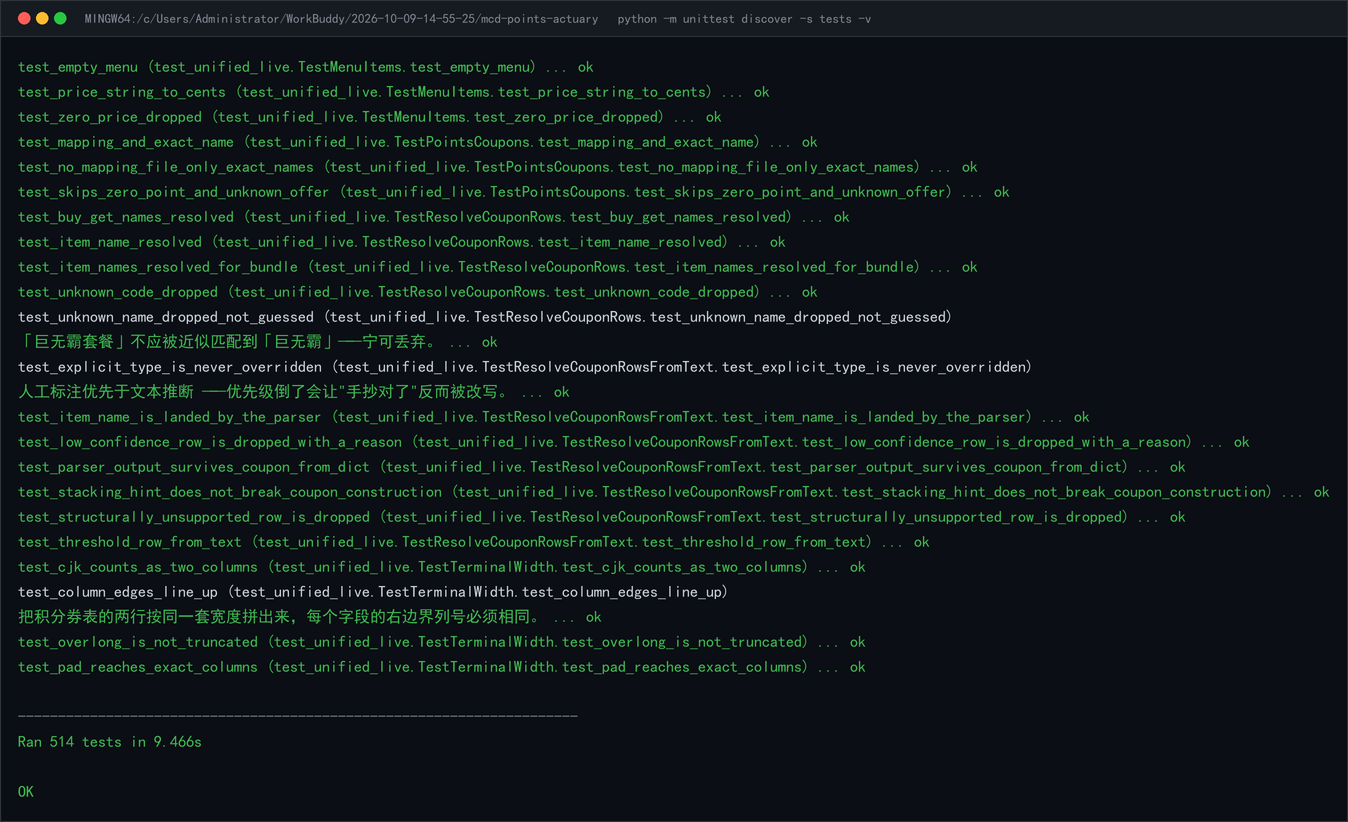
| 测试文件 | 项数 | 盯住什么 |
|---|---|---|
test_expiry_policy.py |
48 | 有界背包对拍穷举、回溯自洽、同名不同档不合并、余额饱和时边际为 0 |
test_points_engine.py |
47 | 价值矩阵、抽奖期望分层夹逼、止损背包、券名匹配回归 |
test_channel_planner.py |
39 | 券叠加口径、bundle_price、渠道比价、按净收益决定用不用积分券 |
test_lottery_mc.py |
30 | 蒙特卡洛均值对拍解析解、固定种子可复现、跨假设压力测试 |
test_shadow_price.py |
27 | 统计量、快照去重、样本不足时降级、保守分位永不高于主口径 |
test_coupon_solver.py |
20 | 2548 组购物车与旧实现对拍、C1–C4 约束、剪枝不改变结果 |
test_unified_live.py |
19 | 菜单归一化、券名精确解析、积分券生成判据、终端列宽对齐 |
test_optimizer.py |
13 | v1 点餐组合引擎 |
几个刻意写成"回归哨兵"的用例:
test_point_bundle_coupon_rejected_when_points_are_valuable—— 抵扣 ¥12.10 的积分券
在影子价格 0.1380 下被判为不该用;影子价格取 0(积分即将过期)时同一张券又变为可用。
两种口径的分歧就是结论本身,所以必须锁死。test_unknown_name_dropped_not_guessed—— 「巨无霸套餐」绝不能被近似匹配到「巨无霸」。
实测证明 v2 的 0.85 字面重合阈值挡不住这个错配(24 张餐品券里只有 1 张能通过
去价格前缀后的完全同名校验),因此阈值匹配被整体废弃。test_column_edges_line_up—— 表格必须按显示列宽(汉字 2 列)补齐:
两行字段的右边界列号必须逐一相等。这条测试保护的正是上面那两张截图的整齐。test_matches_brute_force/test_random_cases_match_brute_force—— 有界背包与笛卡尔积穷举
逐一对拍(含 60 组随机用例)。背包写错是最容易"看起来对"的一类错,所以必须有个不依赖
待测代码的第三方裁判。test_aggregates_by_identity_not_name—— 积分商城里存在同名但积分档位不同的标的
(实测「10.9元指定小食任选」同时以 100 分和 200 分出现)。按名称合并会把它们并成一项、
直接改变结论,所以按对象聚合。test_conservative_never_above_point—— 200 组随机序列下,保守分位必须永远不高于主口径。
早期实现用分位数做"缓冲",在"刚跌下来"的序列上反而给出更高的值 —— 这条测试就是那次翻车的墓碑。test_uniform_mean_matches_expected_if_uniform/test_pessimistic_mean_matches_expected_pessimistic
—— 蒙特卡洛均值必须收敛到闭式解(差 3 分左右,抽样误差内)。
这是唯一能证明"模拟没写错"的硬校验。test_pruning_does_not_change_result—— 剪枝只能省时间,不能改变答案:
剪枝前后必须逐字相同。这是性能优化唯一可接受的安全性证明。test_item_pool_no_double_count/test_pool_used_never_exceeds_price—— 商品池约束 C3 的哨兵:
两套引擎对拍 2548 组购物车,逐组比对抵扣额与每件商品的占用。test_attribution_sums_to_total—— 券求解与背包都自检"逐项之和 = 总额",不等就自己喊归因异常,而不是安静地输出一个看着对的错数。
建模口径(显式声明,便于复核)
券叠加在真实平台远比这复杂且会随时变,所以本项目只承诺:在声明的口径下,结论可复算。
- 单品级券先落地:
item_free/item_reduce/item_discount/buy_get/bundle_price
作用于单件或指定组合,等价于平台常见的"半价周末""单品直降""X 元买这个组合"。 - 整单级券后应用:
threshold_reduce/discount作用在扣除单品级优惠后的金额上
(保守口径 —— 因此"平台满 39 减 8"在单品直降后可能不再满足门槛,报告里会看得见)。 - 同
stack_group内互斥,跨组可叠加;空组视为同一默认组,
因此"单笔只用 1 张券"的官方规则天然包含在内。 max_stack限制整单级券张数(单品级属平台定价,不占叠加额度)。- 按净收益择优:
净收益 = 抵扣额 − 积分消耗 × 影子价格,净收益 ≤ 0 的券永不使用。 bundle_price要求每个指定商品各出现一次。购物车是"商品集合",
无法表达"2 份某单品",因此「X 元 2 份 Y」这类券在数据层排除,而非勉强近似。- 整单级券有两套口径,并列输出不混用:
middle= 所有整单级券都在同一个
(扣掉单品级优惠后的)余额上计算;sequential= 逐张在前一张扣减后的余额上计算。
默认middle,两者结果不可直接比较,所以输出里会带上口径名。 - 影子价格三档并列,主口径不动:主口径 = 周期内最优标的效率(0.1380,对外公布、
跨期可比);保守分位 = 近窗 P25,样本不足时退化为主口径并明确标注;
余额处边际效率 = 有界背包在你的余额处的后向差分,只用于"这一单该不该花积分",
不改动任何已公布结论。 - 兑换节流是假设,不是事实:官方接口不返回"每人每月限换几次",
expiry_policy.py默认取「每 30 天 1 次」,并允许--period-days/--per-period显式覆盖
—— 宁可把假设写在参数里,也不假装知道。 - 性能优化不许改变答案:缓存、剪枝、微优化都必须输出等价。
任何一处优化让结果发生变化,就按 bug 处理 —— 由对拍测试(剪枝前后逐字比对、
新旧引擎 2548 组对拍)守着。用了近似(如beam)必须在结果里写明。
目录结构
mcd-points-actuary/
├── SKILL.md                          # WorkBuddy Skill 定义与工作流
├── README.md                         # 本文件
├── CONTEST_DECLARATION.md            # 参赛声明(官方原文,未改动)
├── MCP_INTEGRATION.md                # MCP 接入说明与实测记录
├── mcp-config.example.json           # 脱敏 MCP 配置(环境变量占位符)
├── workbuddy.md                      # WorkBuddy 开发对话上下文
├── scripts/
│   ├── channel_planner.py            # ★ v3 跨渠道到手成本规划器(券叠加 + 渠道比价)
│   ├── run_unified_live.py           # ★ v3 统一端到端联调(点餐 ⊗ 第三方券 ⊗ 积分)
│   ├── coupon_solver.py              # ★ 券叠加的**约束求解**(C1–C4 + 分支定界 + 对拍旧引擎)
│   ├── expiry_policy.py              # ★ 跨期序贯策略(有界背包 → 有效容量 / 边际效率 / 最晚开始日)
│   ├── shadow_price.py               # ★ 影子价格历史与保守分位(样本不足时明确降级)
│   ├── lottery_mc.py                 # ★ 抽奖蒙特卡洛(四种概率假设 × 定点种子 + 解析解校验)
│   ├── termtext.py                   # 终端**显示列宽**工具(全项目唯一实现,汉字按 2 列)
│   ├── points_engine.py              # v2 积分价值引擎(矩阵 / 抽奖 EV / 背包 / 止损)
│   ├── run_points_live.py            # v2 端到端联调(真实 MCP)
│   ├── optimize_deals.py             # v1 点餐组合引擎 + 统一券模型(7 种券型)
│   ├── run_live.py                   # v1 端到端联调
│   └── mcd_mcp.py                    # MCP Streamable HTTP 客户端(429 退避 / 结构化优先)
├── data/
│   ├── live_third_party.json         # ★ 美团/饿了么渠道费率与券面(用户提供,按**商品名**声明)
│   ├── sample_points_mapping.json    # ★ 积分商城标的 → 菜单商品 的**人工核验映射**
│   ├── shadow_price_history.json     # ★ 影子价格实测快照(按「门店+日期」去重,只记实测值)
│   ├── sample_channels.json          # 渠道建模样例(离线演示用,编码式)
│   ├── sample_points_products.json   # 积分商城标的(真实商城数据脱敏)
│   ├── sample_lottery.json           # 抽奖活动与奖品池
│   ├── sample_reference_prices.json  # 折扣券原价映射(门店菜单实查)
│   ├── sample_menu.json              # 离线示例菜单
│   └── sample_coupons.json           # 离线示例优惠券
├── tests/
│   ├── test_expiry_policy.py         # 48 项:背包对拍穷举 / 回溯自洽 / 同名不合并 / 容量与边际
│   ├── test_channel_planner.py       # 39 项:券叠加 / 组合特价 / 渠道比价 / 积分成本
│   ├── test_lottery_mc.py            # 30 项:MC 对拍解析解 / 种子可复现 / 跨假设压测
│   ├── test_shadow_price.py          # 27 项:统计量 / 去重 / 降级 / 保守分位不越界
│   ├── test_coupon_solver.py         # 20 项:2548 组对拍旧引擎 / C1–C4 / 剪枝等价
│   ├── test_unified_live.py          # 19 项:菜单归一化 / 券名解析 / 积分券生成 / 列宽对齐
│   ├── test_points_engine.py         # 47 项:积分引擎 + 匹配回归
│   └── test_optimizer.py             # 13 项:v1 点餐引擎
├── docs/captures/
│   ├── unified-live.txt              # ★ 真实运行 stdout 原样重定向(配图的数据源)
│   └── tests-verbose.txt             # ★ 全部测试的原始输出
├── tools/
│   └── make_readme_assets.py         # 由 captures 渲染 README 配图(架构图 / 截图 / 测试图)
├── assets/                           # 渲染产物(4 张 PNG,README 引用)
└── LICENSE
docs/captures/*.txt是配图的唯一数据源:先跑脚本重定向出文本,再由tools/make_readme_assets.py渲染成 PNG。图不是画出来的,是可复算的 ——
这也是为什么截图里的表格列能对齐(渲染器逐字符摆放到固定列网格上,
并对 SimHei 缺失的¥ ➜ ⚠ −自动走符号字体兜底)。
能力演进
本项目是三轮迭代 + 一轮精算加固的结果,仓库同时保留三层能力:
| 版本 | 命题 | 引擎 | 状态 |
|---|---|---|---|
| v1 | 怎么买最省?(组合剪枝 + MCP 精算) | optimize_deals.py |
已完成,13 项测试 |
| v2 | 怎么花积分最值?(价值矩阵 + 期望值边界) | points_engine.py |
已完成,47 项测试 |
| v3 | 在哪买、用哪张券、要不要动积分? | channel_planner.py + run_unified_live.py |
已完成,58 项测试 |
| v3.1 | 上述结论在什么条件下还成立? | coupon_solver.py + shadow_price.py + expiry_policy.py + lottery_mc.py |
当前主线,125 项新测试 |
为什么一轮轮往前走?
v1 把"钱"算到极致 → 发现钱之外的资产没人算(积分会过期、多路径、价值差 13 倍);
v2 把积分算清楚 → 发现积分算清了却没用上:它必须和现金放在同一刻度上,
才能真正回答"这单该怎么买"。v3 就是把前两层接进同一个目标函数。v3.1 补的是可信度:v3 的每个数字都能算出来,但有几个地方经不起追问 ——
影子价格是单点还是区间?券叠加在商品池这一层对不对?拖着不换行不行?
"期望为正"就等于"不会亏"吗?这四个问题各自对应一个新的内核,
而且每一个都用"能不能证伪自己"来设计:对拍穷举、对拍旧引擎、对拍闭式解。
已知边界(写出来,而不是藏起来)
- 券叠加的真实规则比本项目建模的更复杂,且会随时变。 本项目只承诺
「在声明的口径下结论可复算」,不承诺复现平台的全部细节。 - 兑换节流(每人每月限换几次)官方接口不返回,默认按「每 30 天 1 次」假设,
可显式覆盖。这个假设会直接影响"有效兑换容量",所以它写在参数里、也写在这里。 - 影子价格历史目前只有 1 期,保守分位因此退化为单点值 —— 代码会明说,
不会拿单点冒充区间。多跑几次--record-shadow即可积累。 - 抽奖的官方概率不公开,所以只给"在什么假设下结论是什么",不给一个假装权威的概率。
beam退化:券组合规模超过精确求解上限时用束搜索,结果里会标注method=beam
—— 此时答案是近似的,不是精确的。
数据说明
data/下的商城标的、奖品池、菜单与金额均来自真实 MCP 响应的脱敏快照
(不含账号、Token 等隐私字段),用于离线复现与文档演示。live_third_party.json的第三方券面取自公开活动信息,仅用于建模演示;
各平台券的可领状态、门槛与叠加规则因人因店因时段而异,实际应付金额以各平台下单页为准。sample_points_mapping.json是人工逐条核验的映射表,两条路径:
① 券名明示组合成分;② 券名去价格前缀后与菜单商品名完全一致。
收录与排除的理由都写在文件里 —— 排除项比收录项多,这是刻意的。- 商城下架/上新、菜单调价都会改变结果,请以实时 MCP 返回为准。
声明
本项目为麦当劳程序员节创意开发大赛参赛作品,由参赛者独立开发,非麦当劳官方产品。
项目输出仅供参考,不构成投资、金融或其他专业建议;积分规则、奖品池及兑换可用性以麦当劳官方渠道的实时结果为准。
许可证
MIT © 2026 akeXin
Yorumlar (0)
Yorum birakmak icin giris yap.
Yorum birakSonuc bulunamadi