amlei-resume
Health Uyari
- License — License: MIT
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 6 GitHub stars
Code Gecti
- Code scan — Scanned 6 files during light audit, no dangerous patterns found
Permissions Gecti
- Permissions — No dangerous permissions requested
Bu listing icin henuz AI raporu yok.
写简历的 Agent Skills 技能包,运行在 Claude Code / Cursor / Codex 等 AI 助手里——聊过的经历跨会话记住,一份底稿投影出多个岗位方向,选主题导出矢量 A4 PDF
amlei-resume
写简历最浪费的地方,是每投一个方向,都要把自己重讲一遍。
amlei-resume 是一个装进 AI 助手的 Agent Skill:你的经历和能力只沉淀一次,之后想投哪个方向,就把这份画像投影成那个方向的简历。支持 Claude Code、Cursor、Codex、Gemini CLI、OpenCode、Copilot。
它是什么
三个词:记得住、分得清、管到底。
- 记得住——你聊过的经历、项目、能力沉淀成跨会话画像
profile.md;长文、导出、项目文档等原始证据留在materials/,确认后的事实再进画像。下次打开,不用从头讲起。 - 分得清——「做过什么」是事实,全局只记一遍;「怎么讲」是强调,每个求职方向各有一版。换岗不是重写,是重新选材。
- 管到底——从按需岗位调研、挖素材、写改,到导出矢量 A4 PDF、生成招聘平台招呼语,一条流程走完。
核心设计:一份画像,多个方向,每个方向一个当前版本
profile.md(跨会话画像)
  已确认的短事实——经历、项目、能力
        ↑ 提炼
materials/(跨方向证据池)
  原始素材、来源、版本与待确认信息
        ↓ 投影
identities/{方向}/简历.md
  这个方向怎么选材、怎么组织、怎么措辞
        ↓ 导出
export/(预览 HTML、A4 PDF、长图)
判断标准只有一个:两次不同方向的面试里,这件事你会讲得不一样吗? 不会变的事实进 profile.md,证据留在 materials/;会变的表达属于某一份简历。
记忆:像 ChatGPT Memory 一样自然衔接
profile.md 只有五段事实,短到能一眼看完(另加一个可选的 materials/index.md 指针):
# 关于我
- 姓名 / 城市 / 联系方式 / 教育 / 链接

# 经历与项目
## 机构 | 角色 | 时间
- 做过什么,结果如何(带数字/证据)

# 能力与证据
- 能力:由哪个项目/成果证明

# 跨方向偏好
- 长期方向 / 明确排除 / 稳定工作偏好 / 通用表达偏好

# 待确认
- 下次要问的缺口、待核实数字
具体投递方向的目标岗位、行业/公司、城市、层级与 JD 基准属于该方向的 target.json,不混进 profile.md。
记忆怎么用:
- 每次开聊先读
profile.md,把它当作已经知道的用户信息,不重复问。 - 用户给文章、导出、项目文档或长口述时,先落进
materials/并登记索引;只有确认后的短事实才提升进profile.md。 - 聊到新东西,用三问判断值不值得记:未来的简历会用到吗?有证据吗?换个方向也不会变吗?
- 简历定稿是最大的记忆来源:从 0 写简历时,定稿本身就是一份完整信息——把里面首次出现的客观事实、成果、偏好回写
profile.md,下次不用重讲。 - 保持短小:重复、过时、被取代的内容合并或删除;它是画像,不是聊天记录。
写简历的过程
你跟它聊。聊目标方向、聊做过的事、聊那些你自己都没当回事的细节——它会带着推理去读你给的资料,把疑点追问出来,而不是照单全收。聊出的客观事实经你确认后进入 profile.md。
也可以直接丢一份旧简历(.docx / .pdf)进来,它负责解析、重排模块、抽出证件照,转成能继续打磨的底稿。
需要了解目标岗位的行情时,它会联网搜索薪资、能力要求、行业趋势,产出市场报告,作为选材和定位的依据。
每一步都有人工卡点:你没说「可以」之前,它一个字也不会写进你的简历。
导出效果:矢量 A4 简历 PDF
一份简单的 Markdown,渲染成矢量 A4 简历,所见即所得:
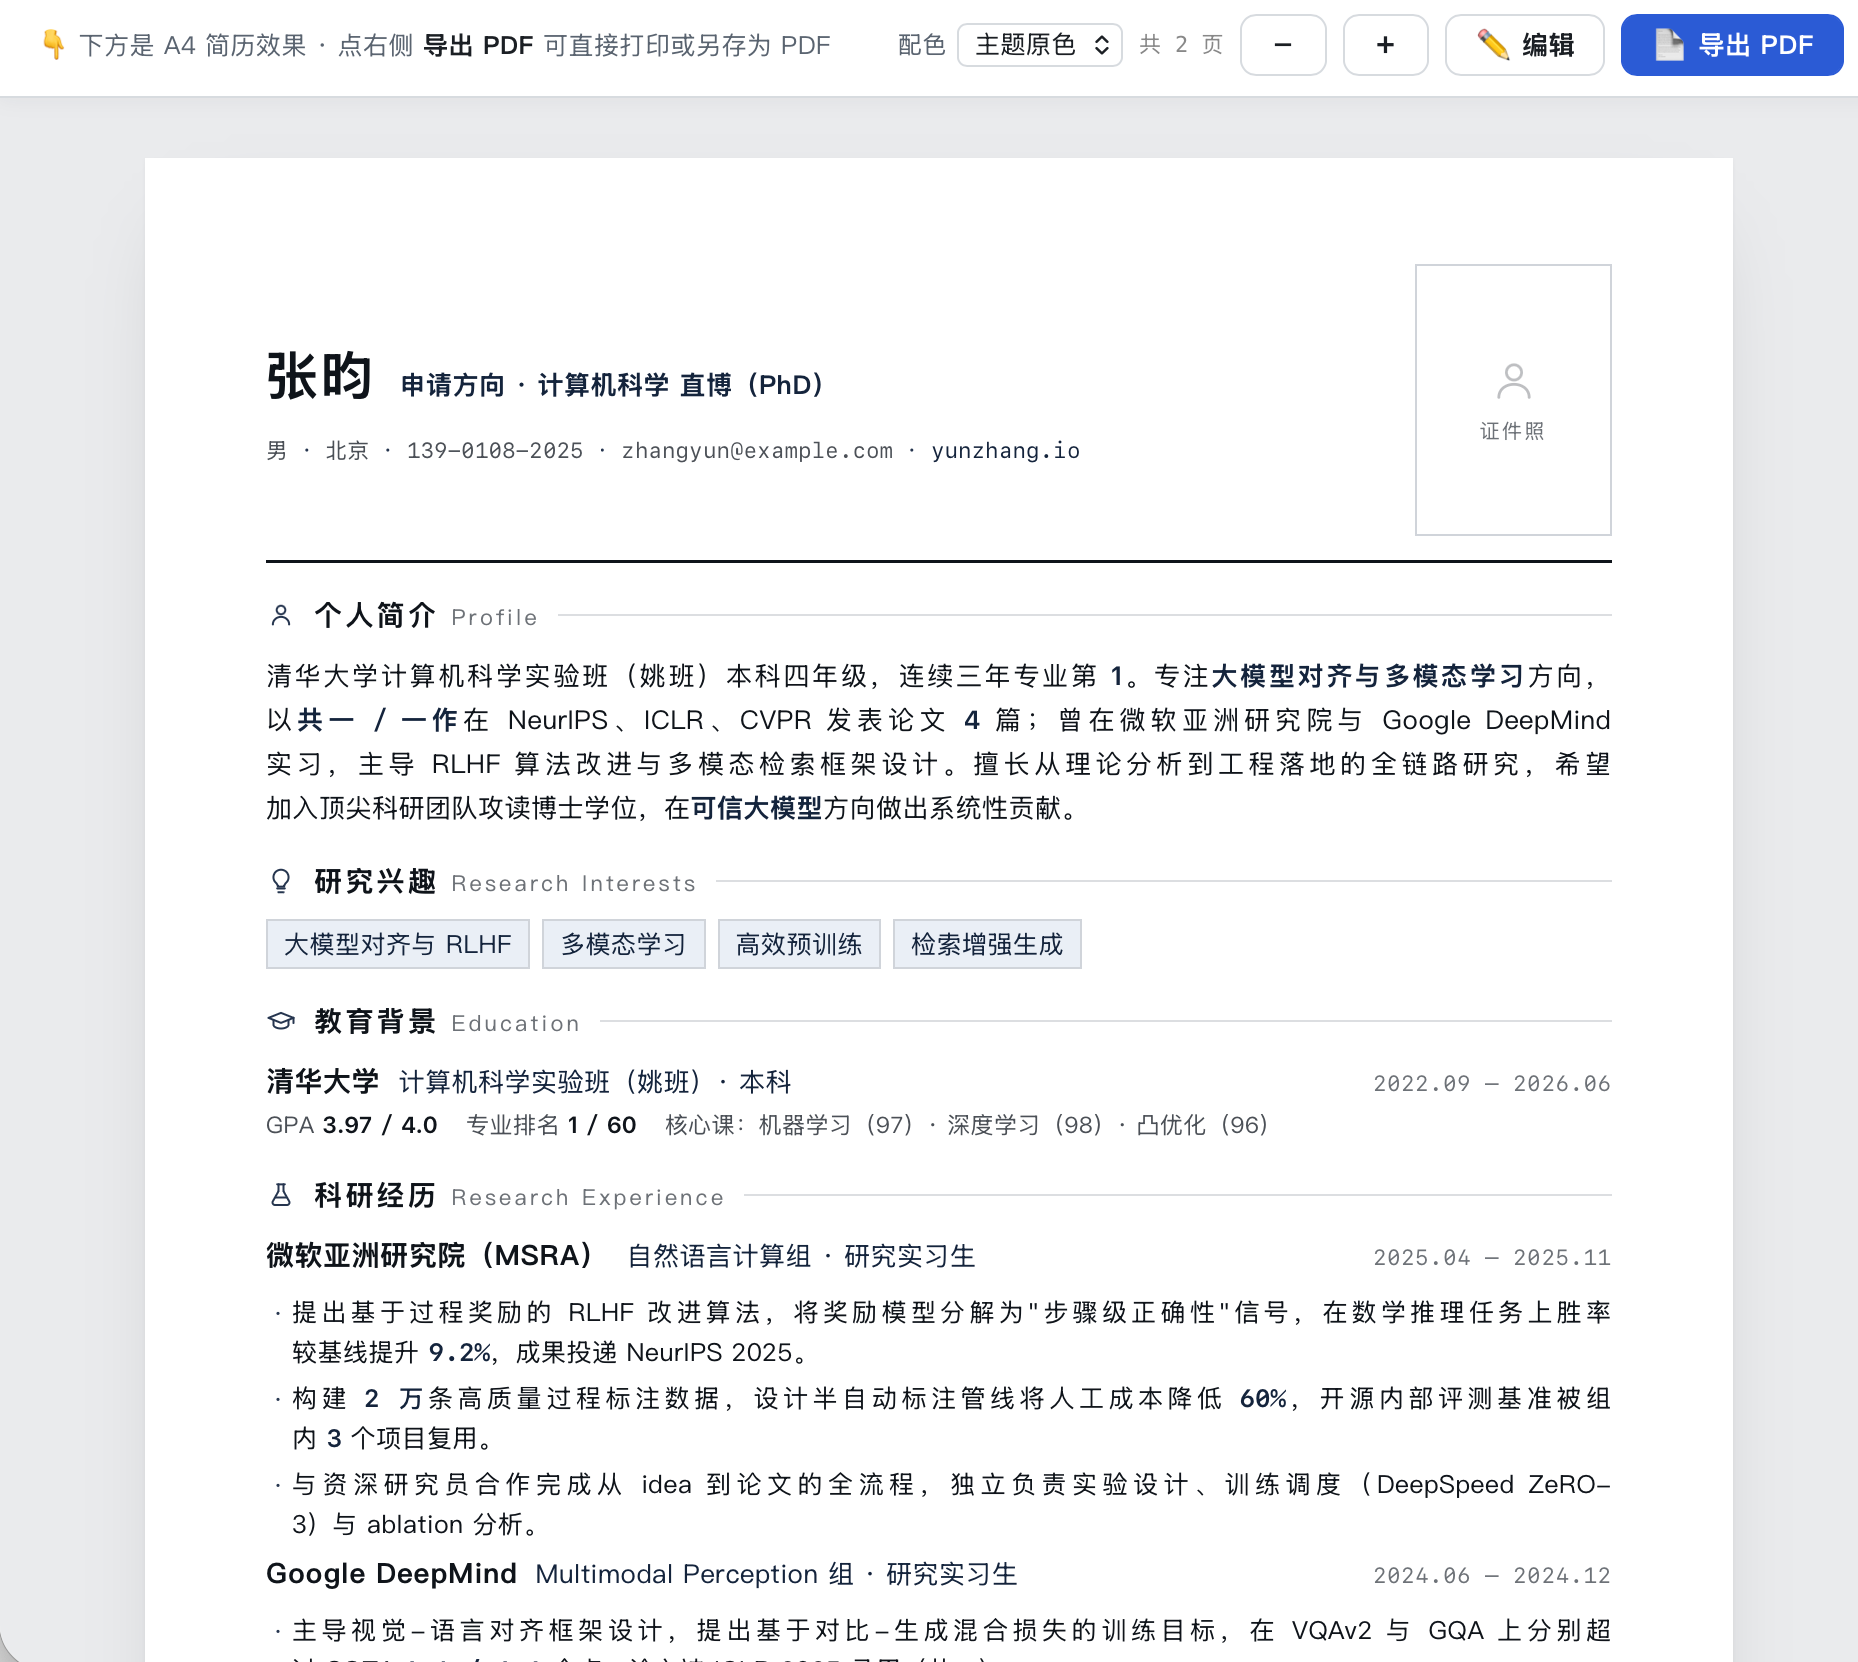
想看 PDF 版?打开 A4 预览 PDF。
源文件就是朴素的 Markdown——模块顺序即简历顺序,写完选主题、一键导出:
# self-intro

name: 张昀
role: 申请方向 · 计算机科学 直博(PhD)

# 科研经历

## 微软亚洲研究院(MSRA) | 自然语言计算组 · 研究实习生
date: 2025.04 — 2025.11

- 提出基于过程奖励的 RLHF 改进算法……
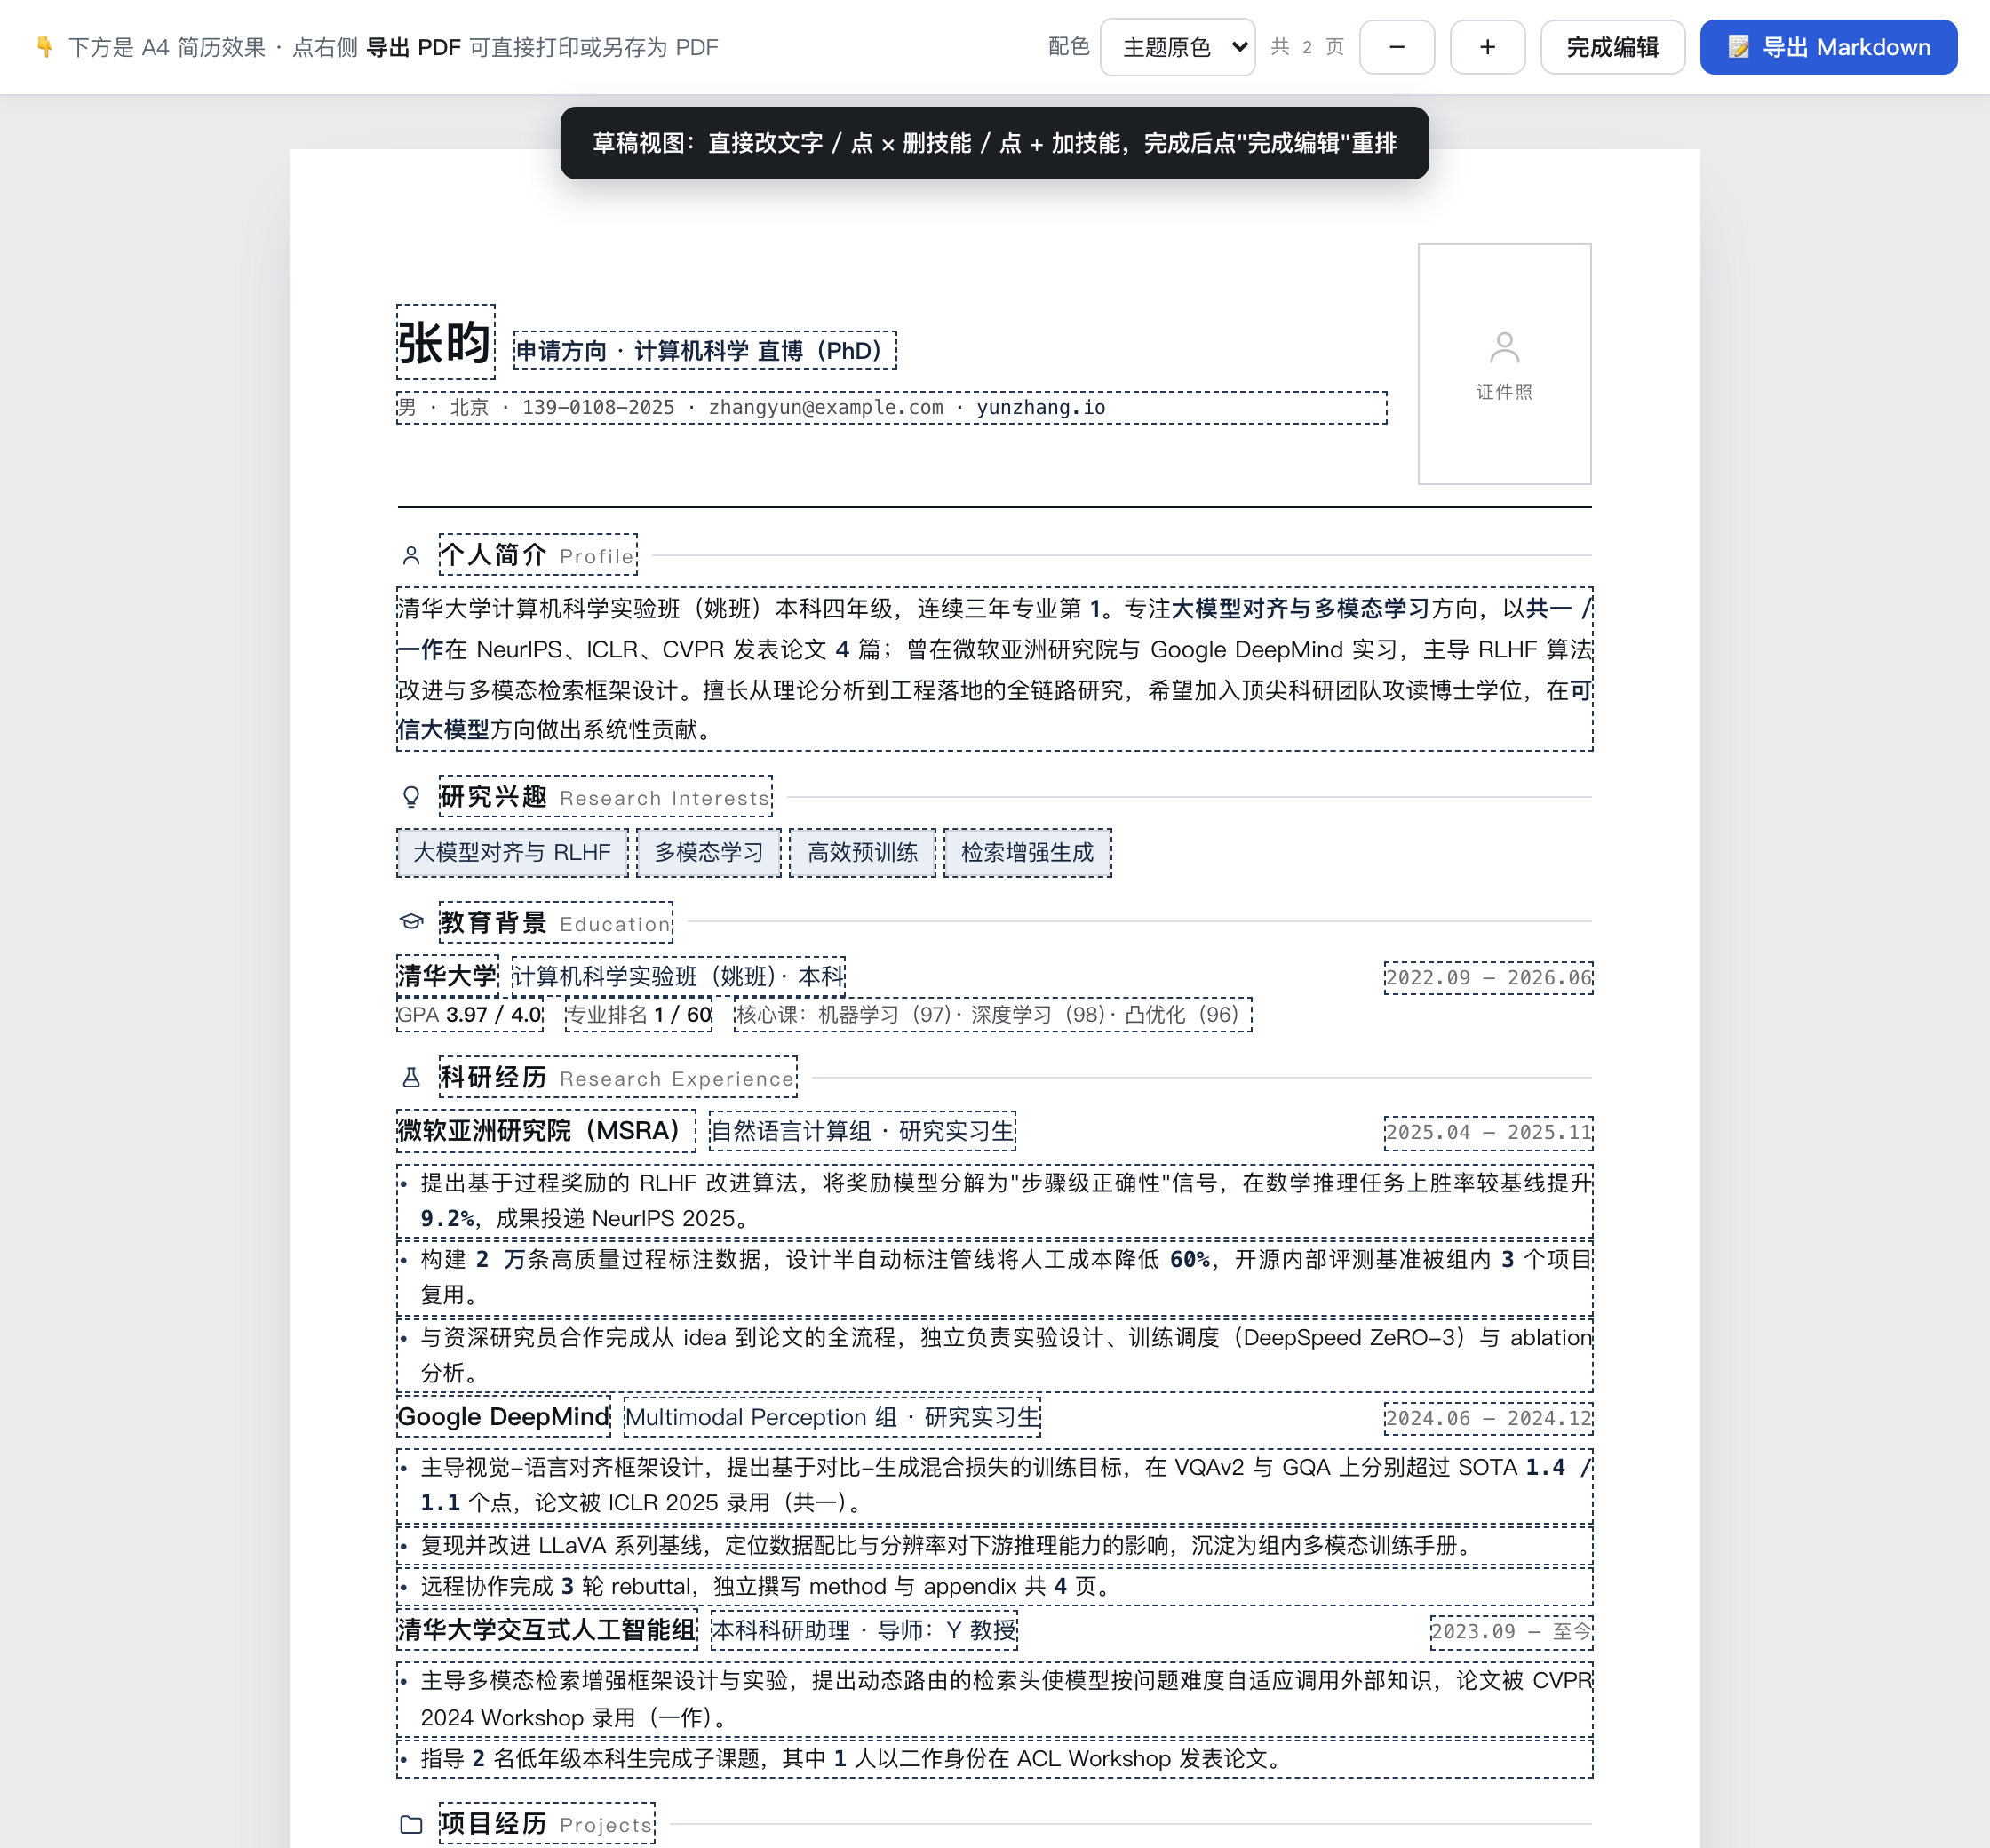
预览页还能就地改:改字、删加技能条,自动重排分页,改完一键导回 Markdown:
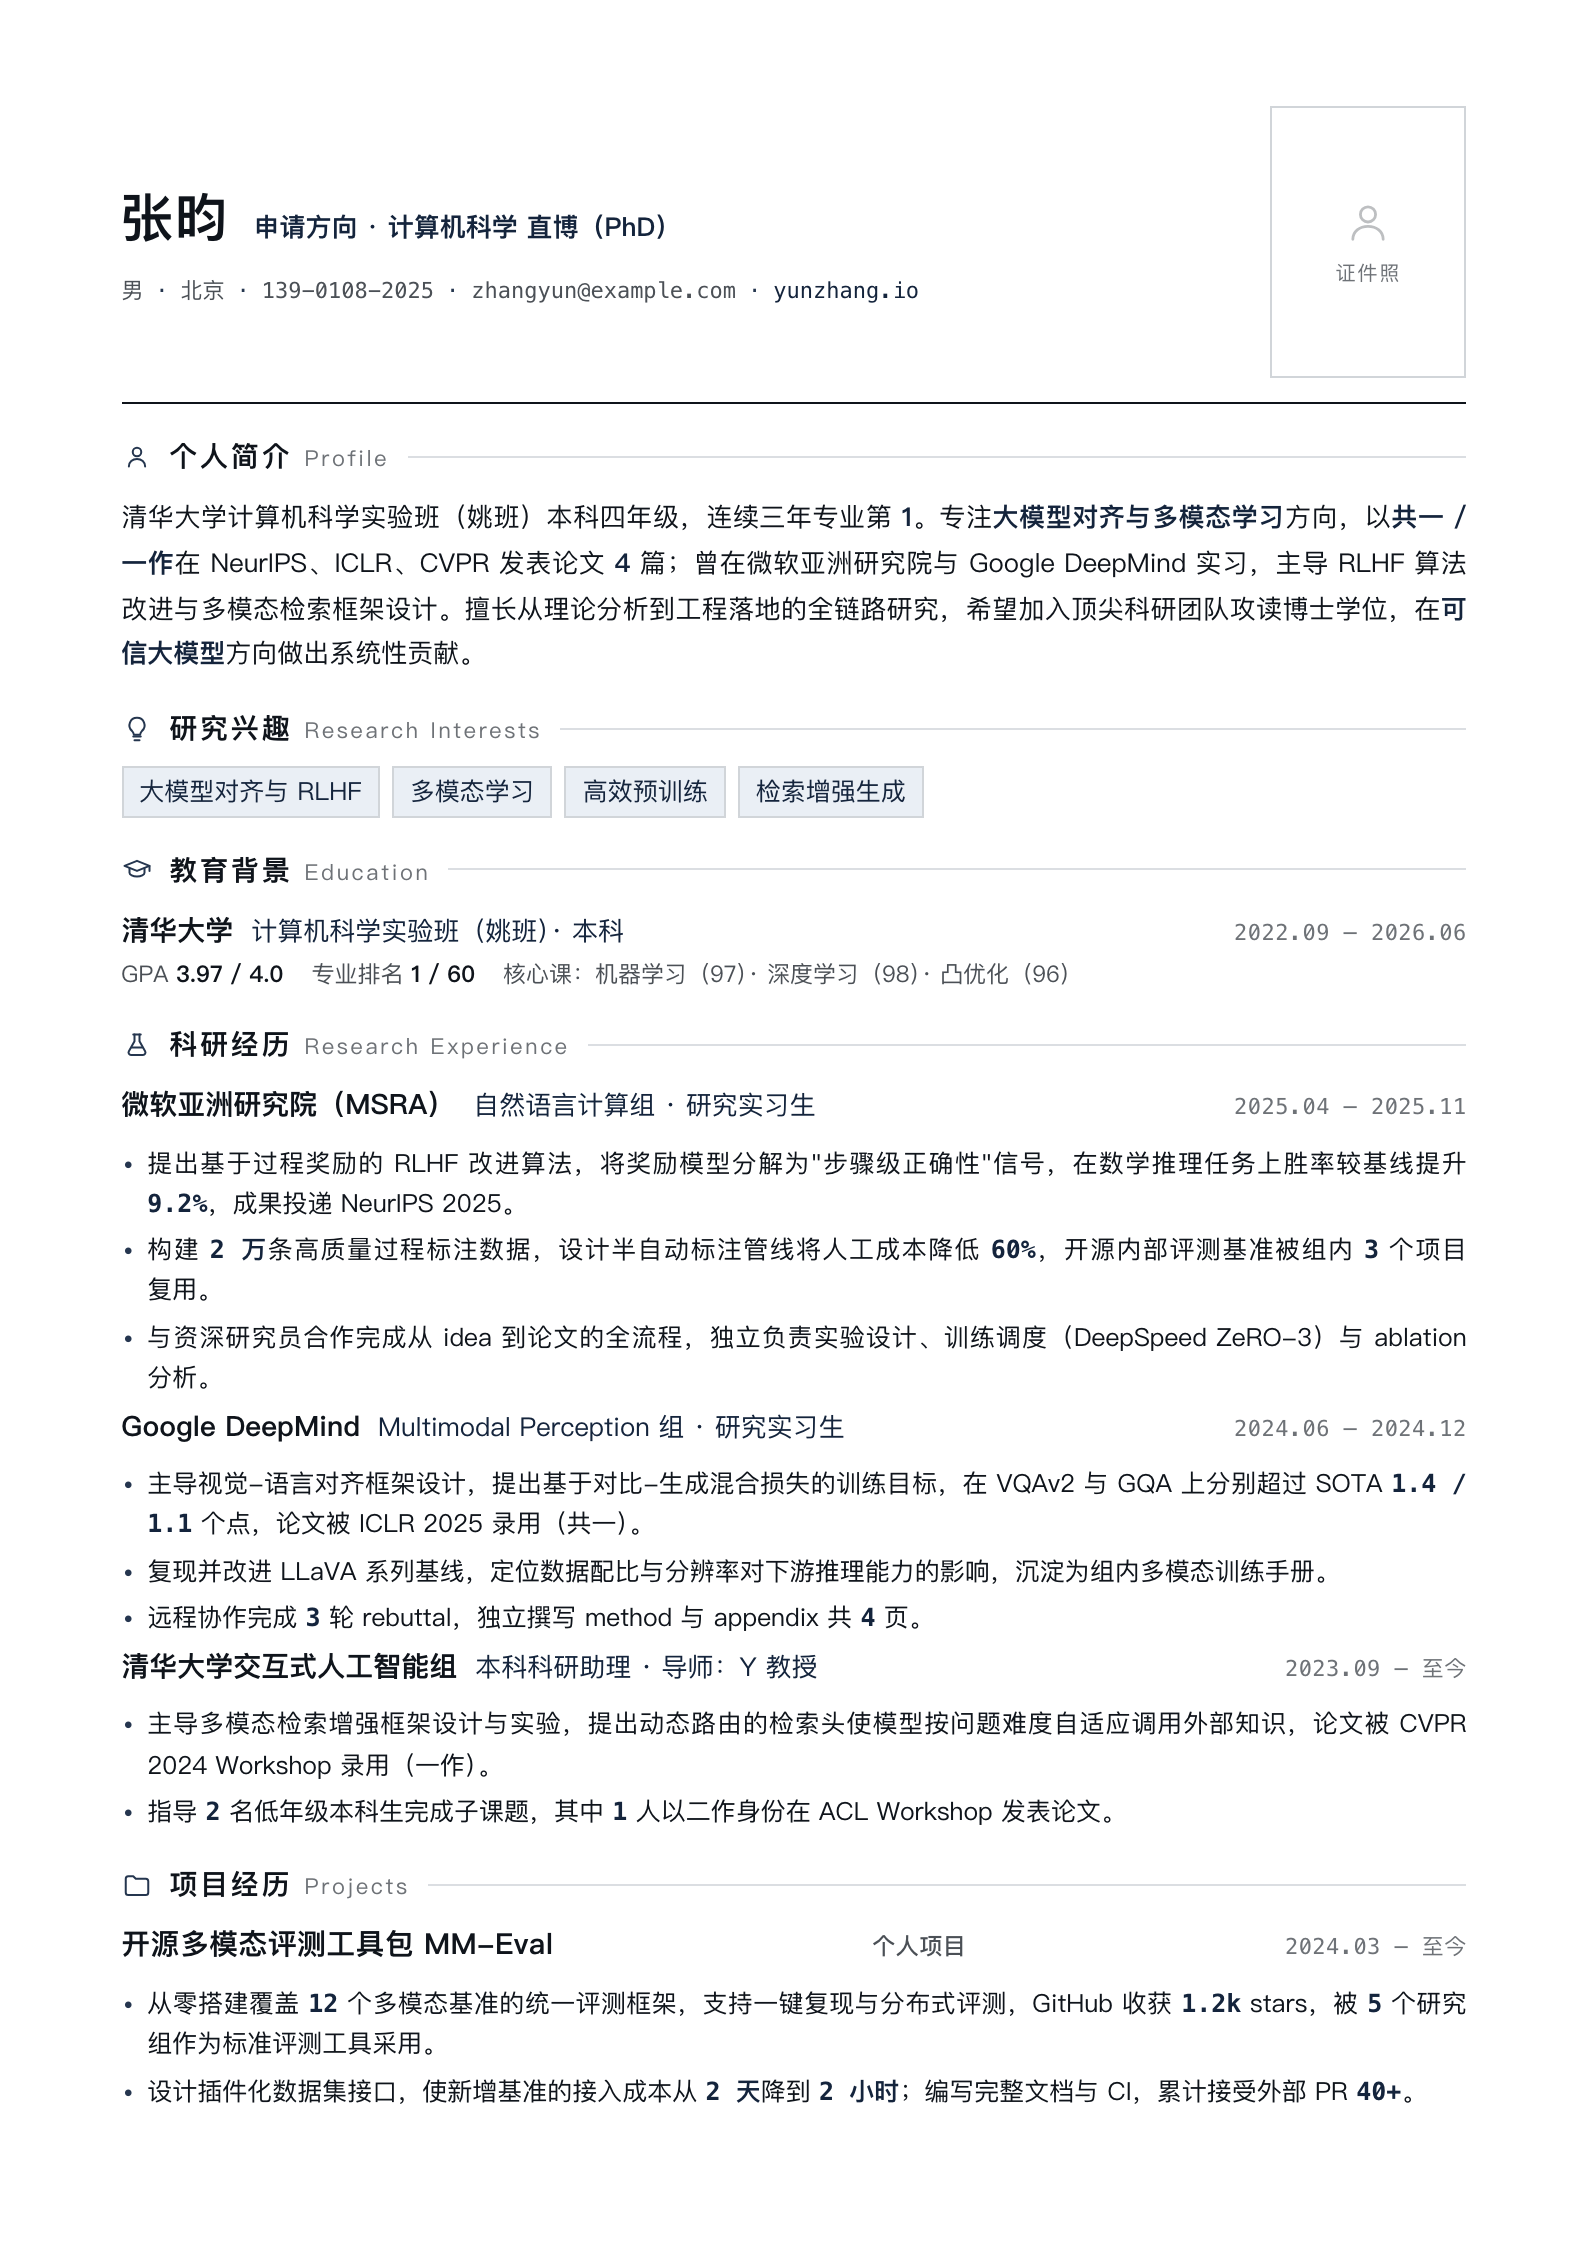
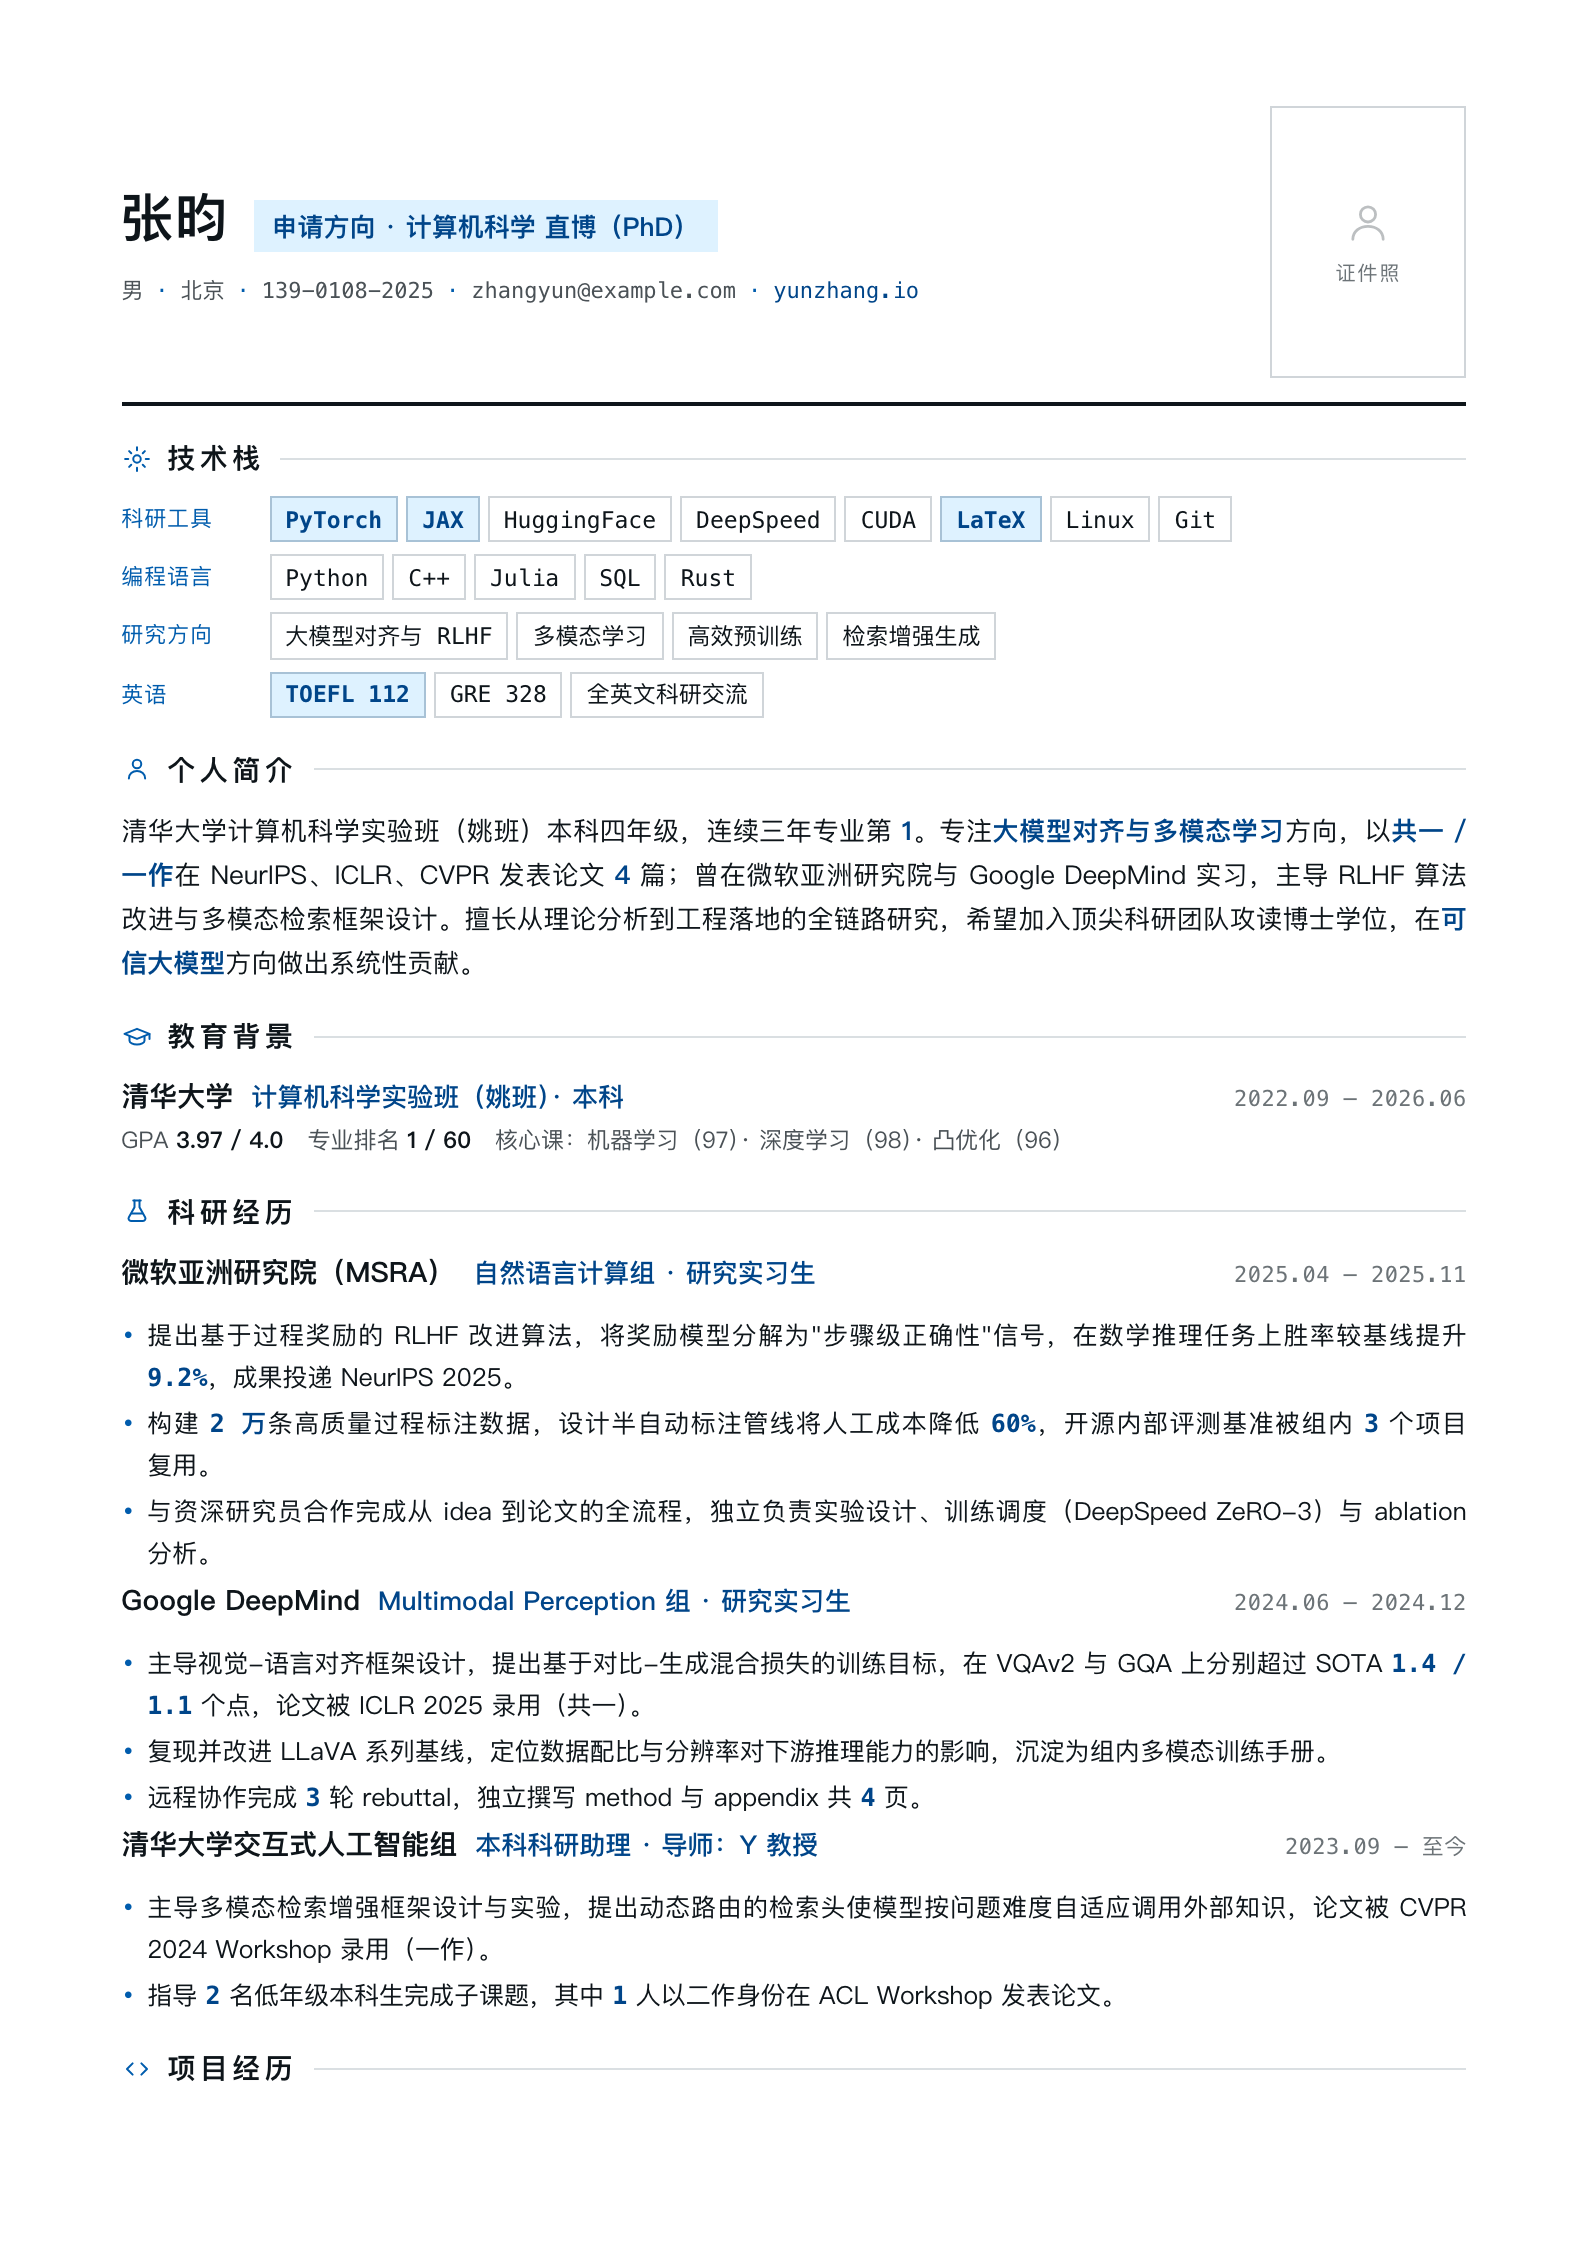
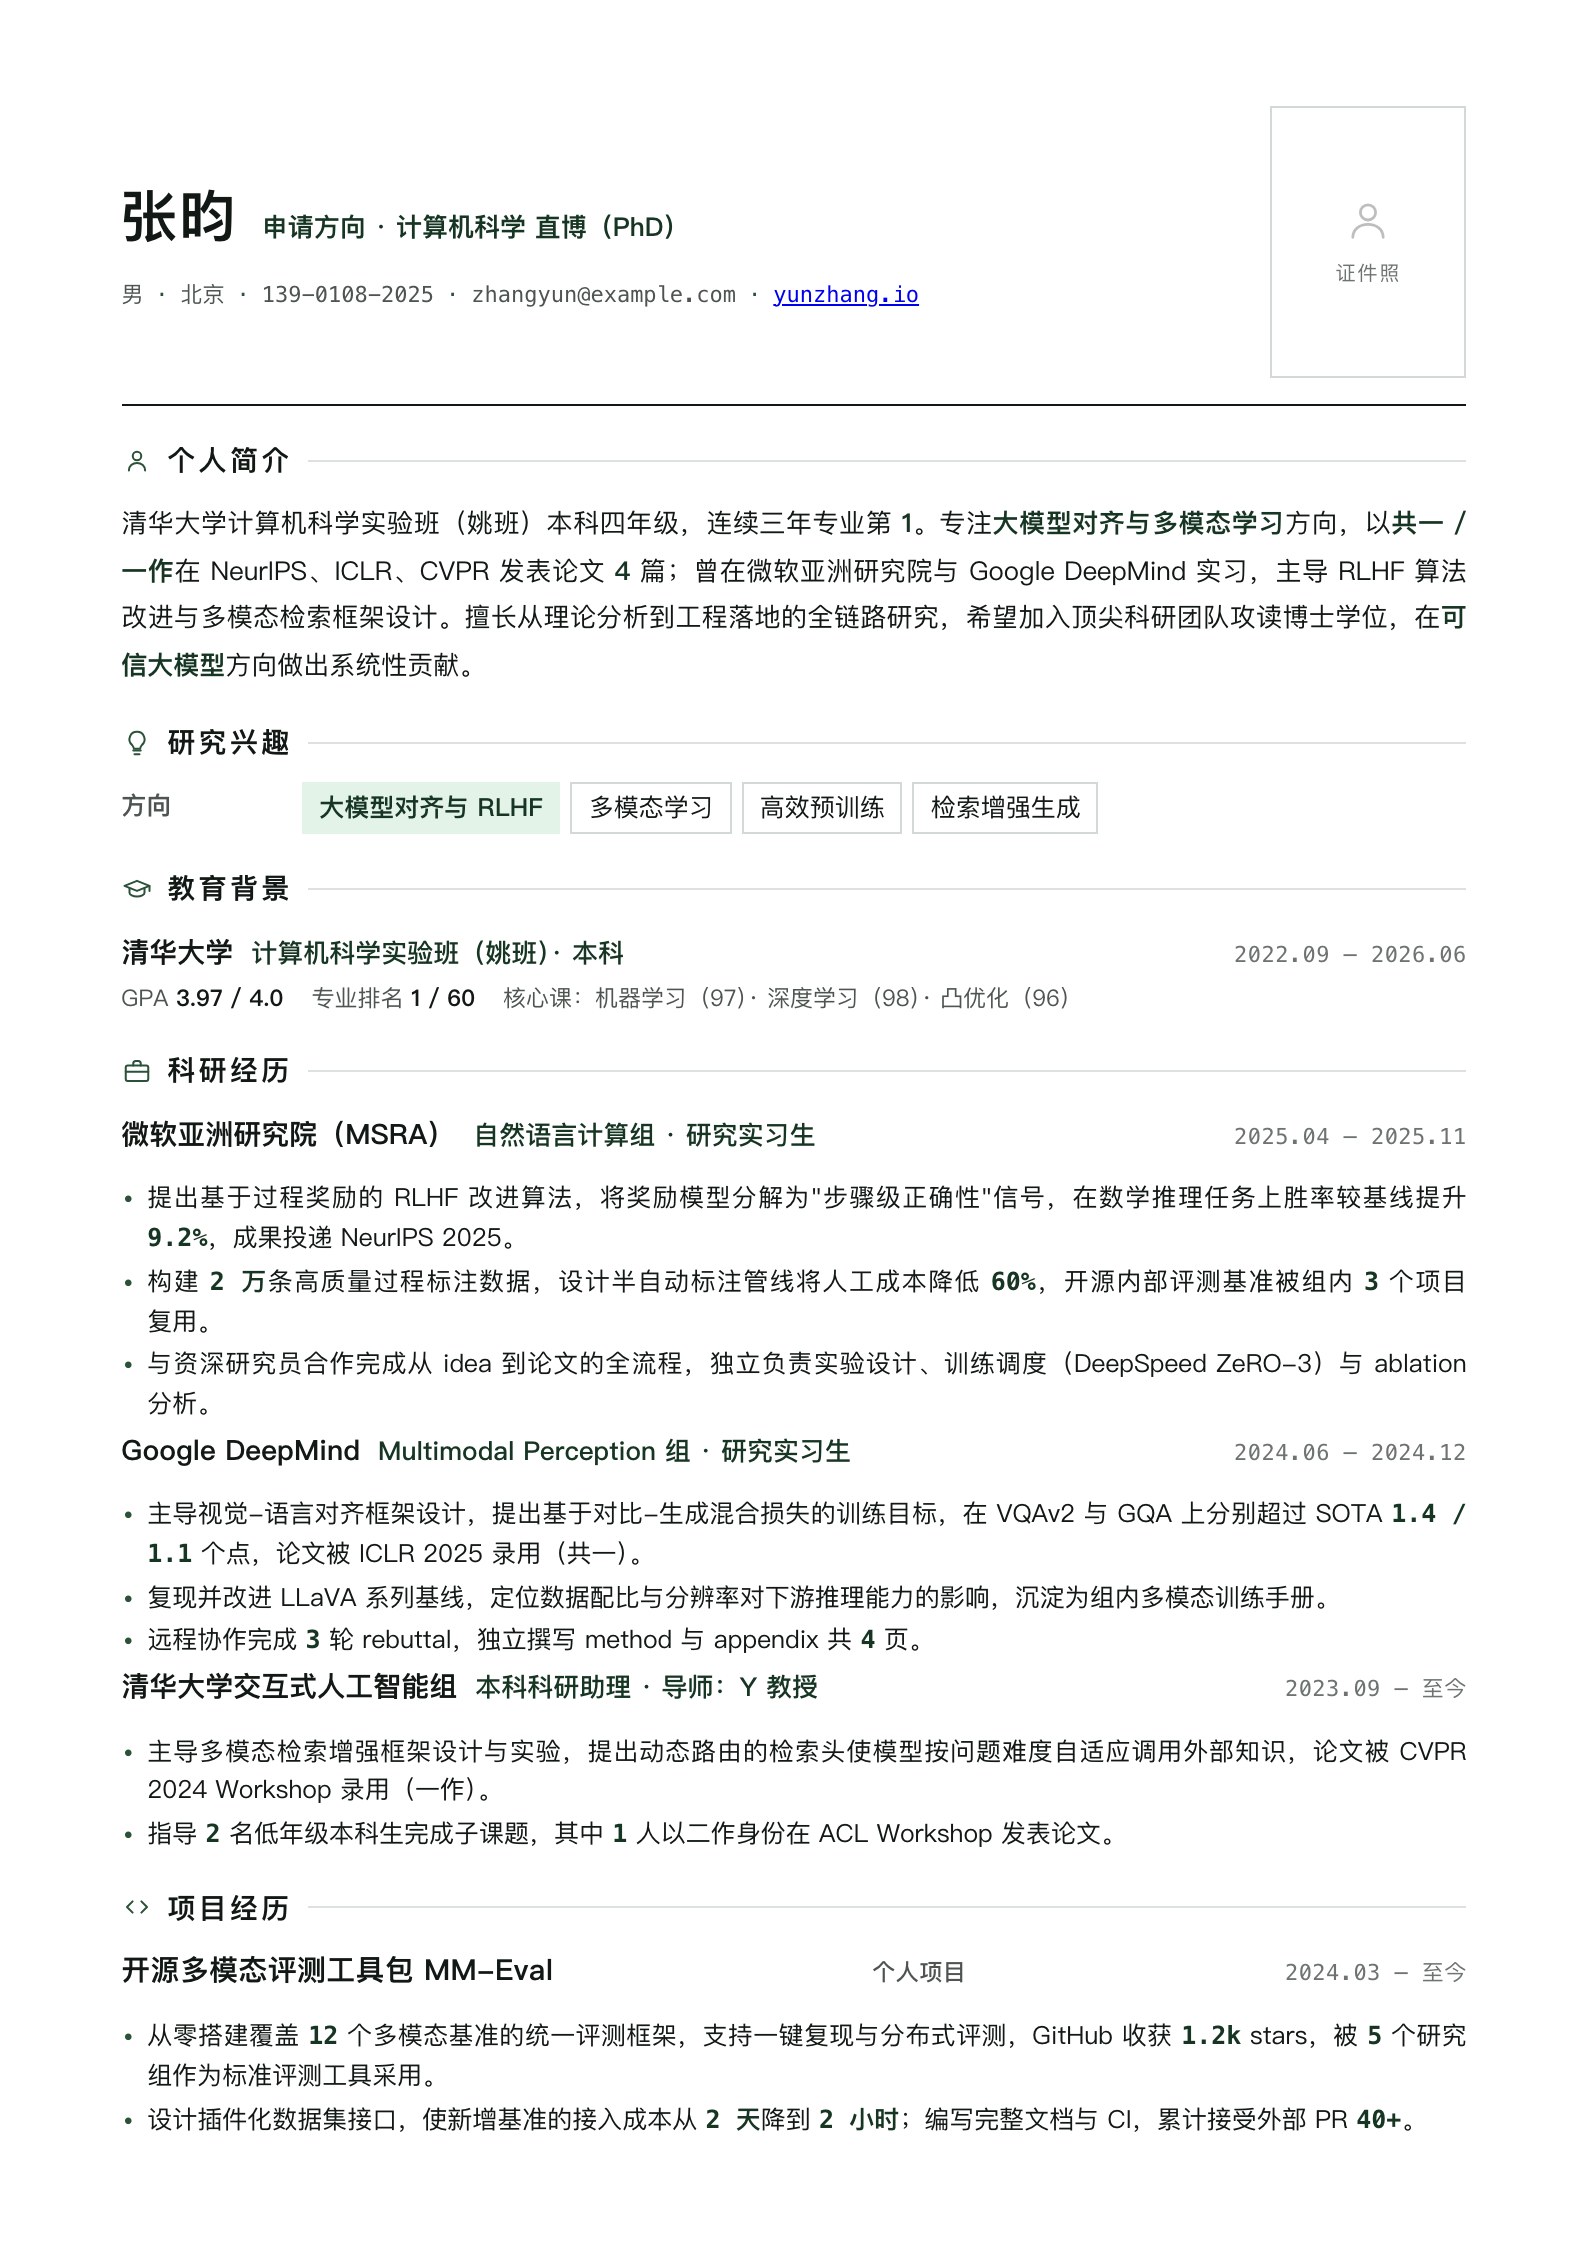
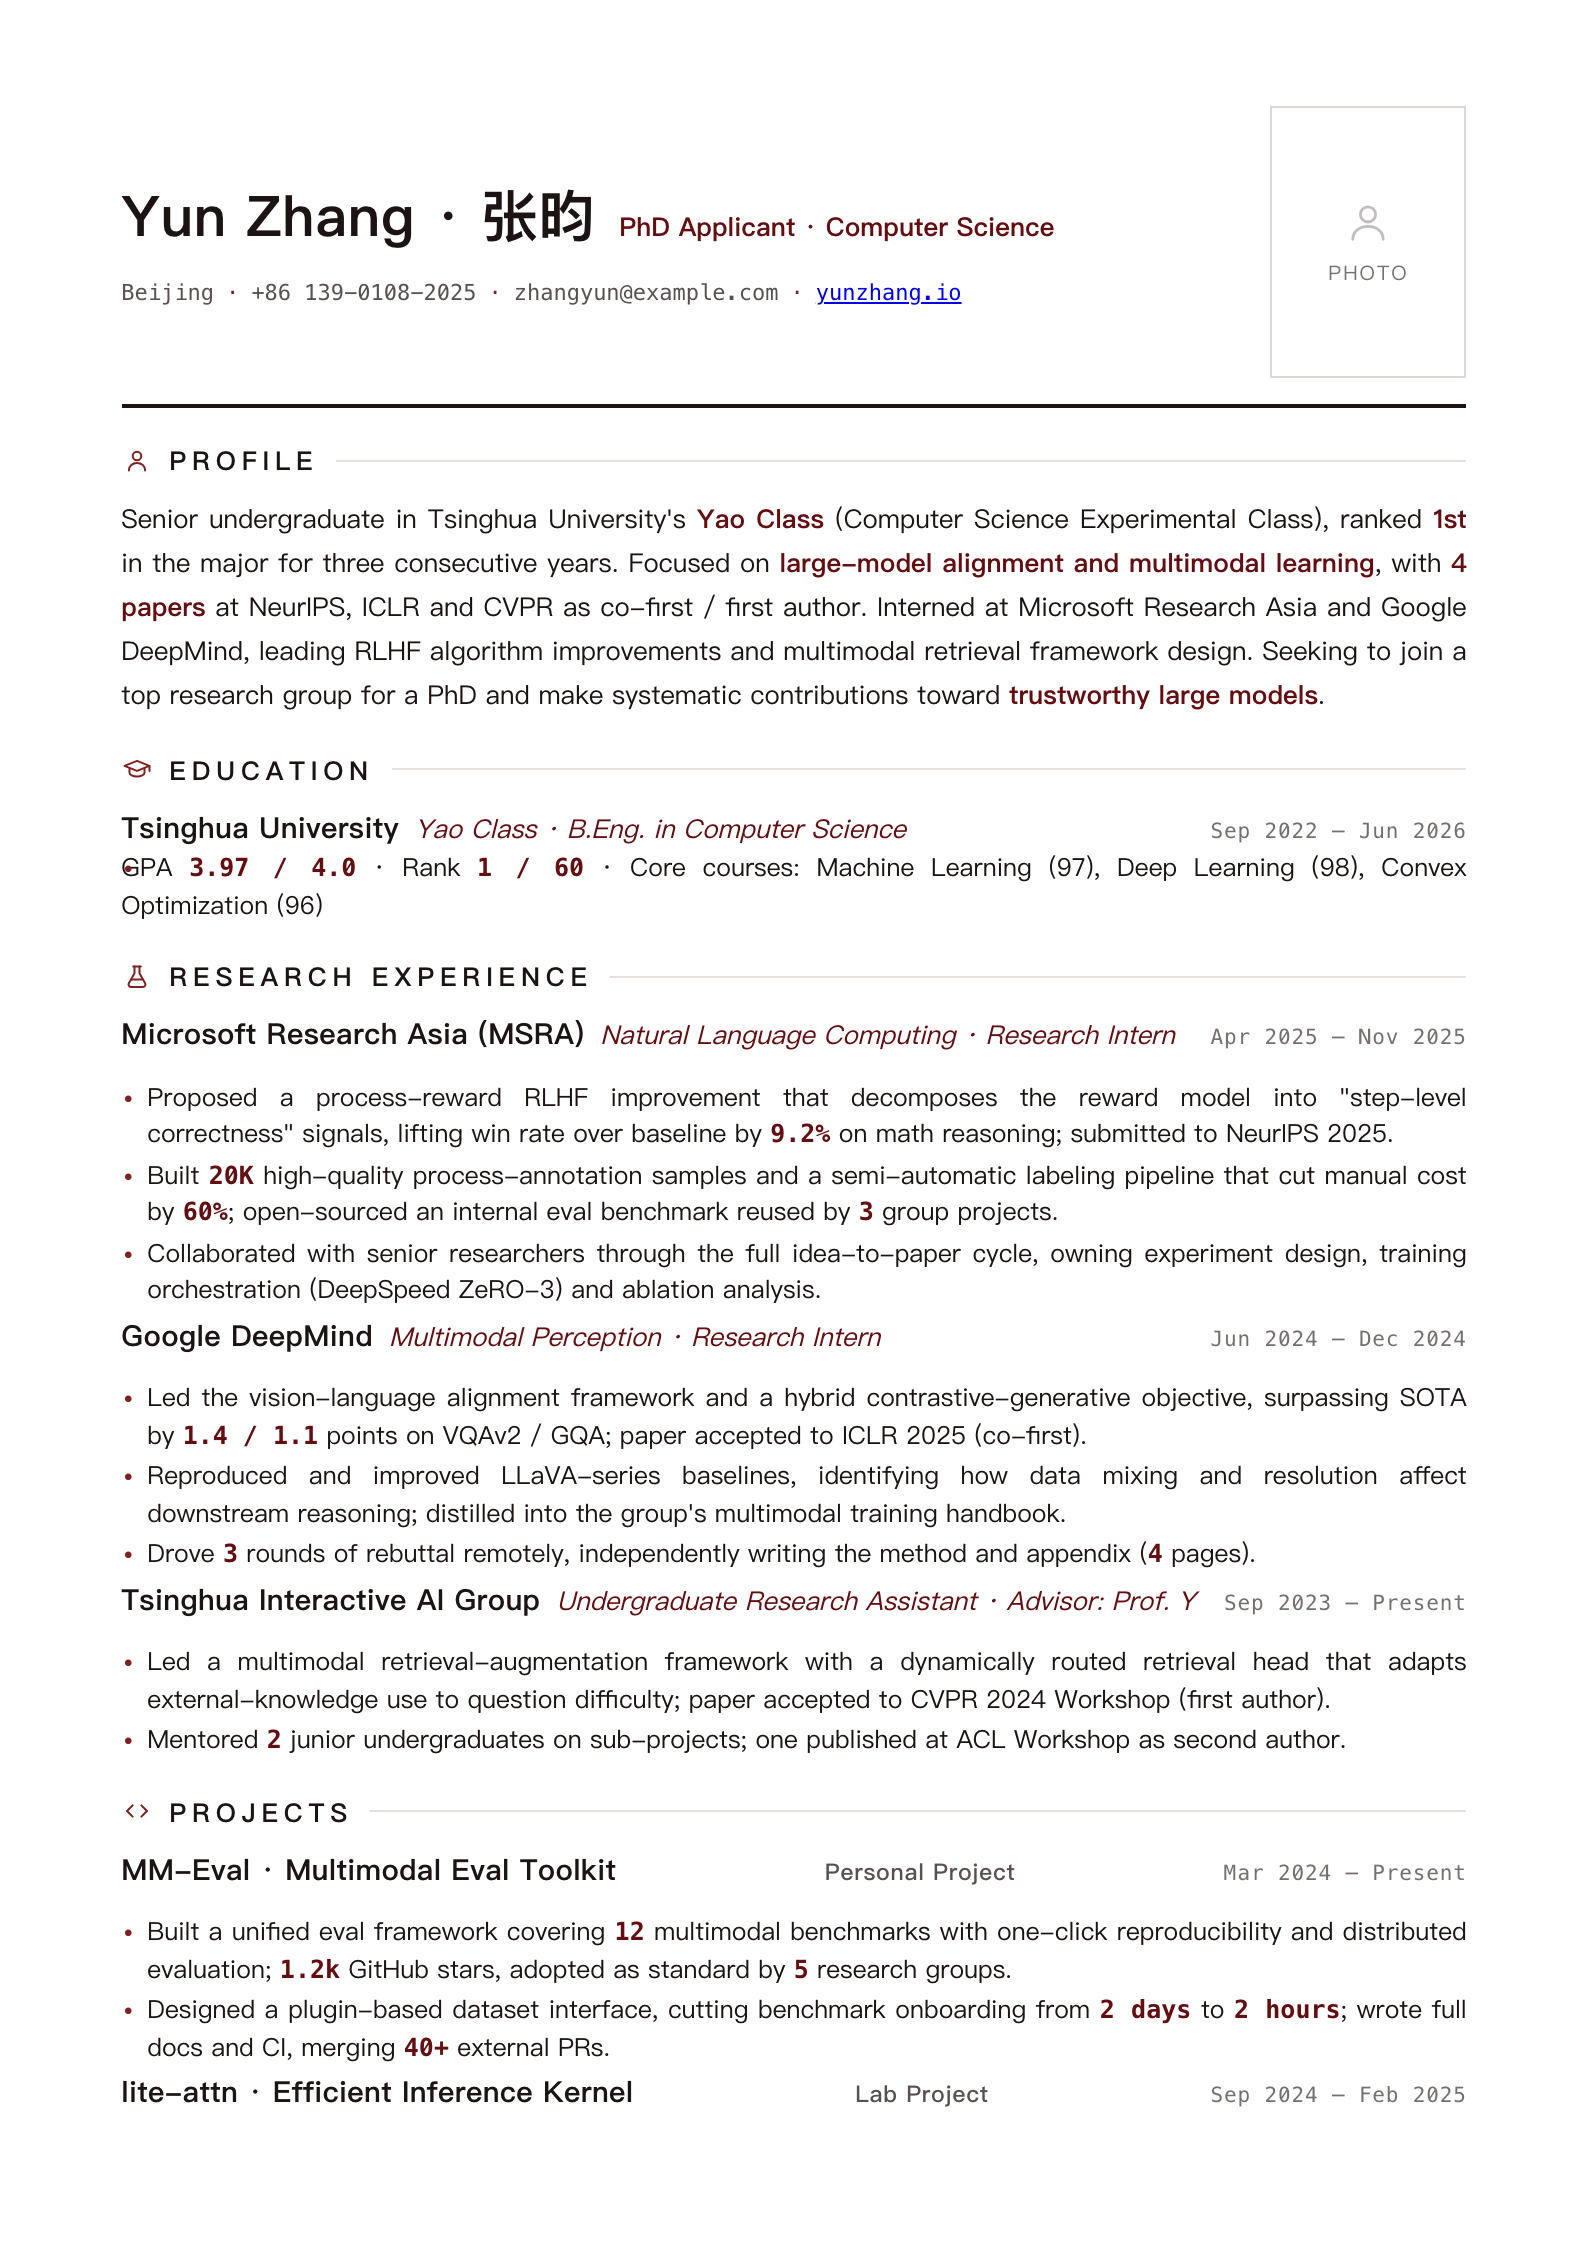
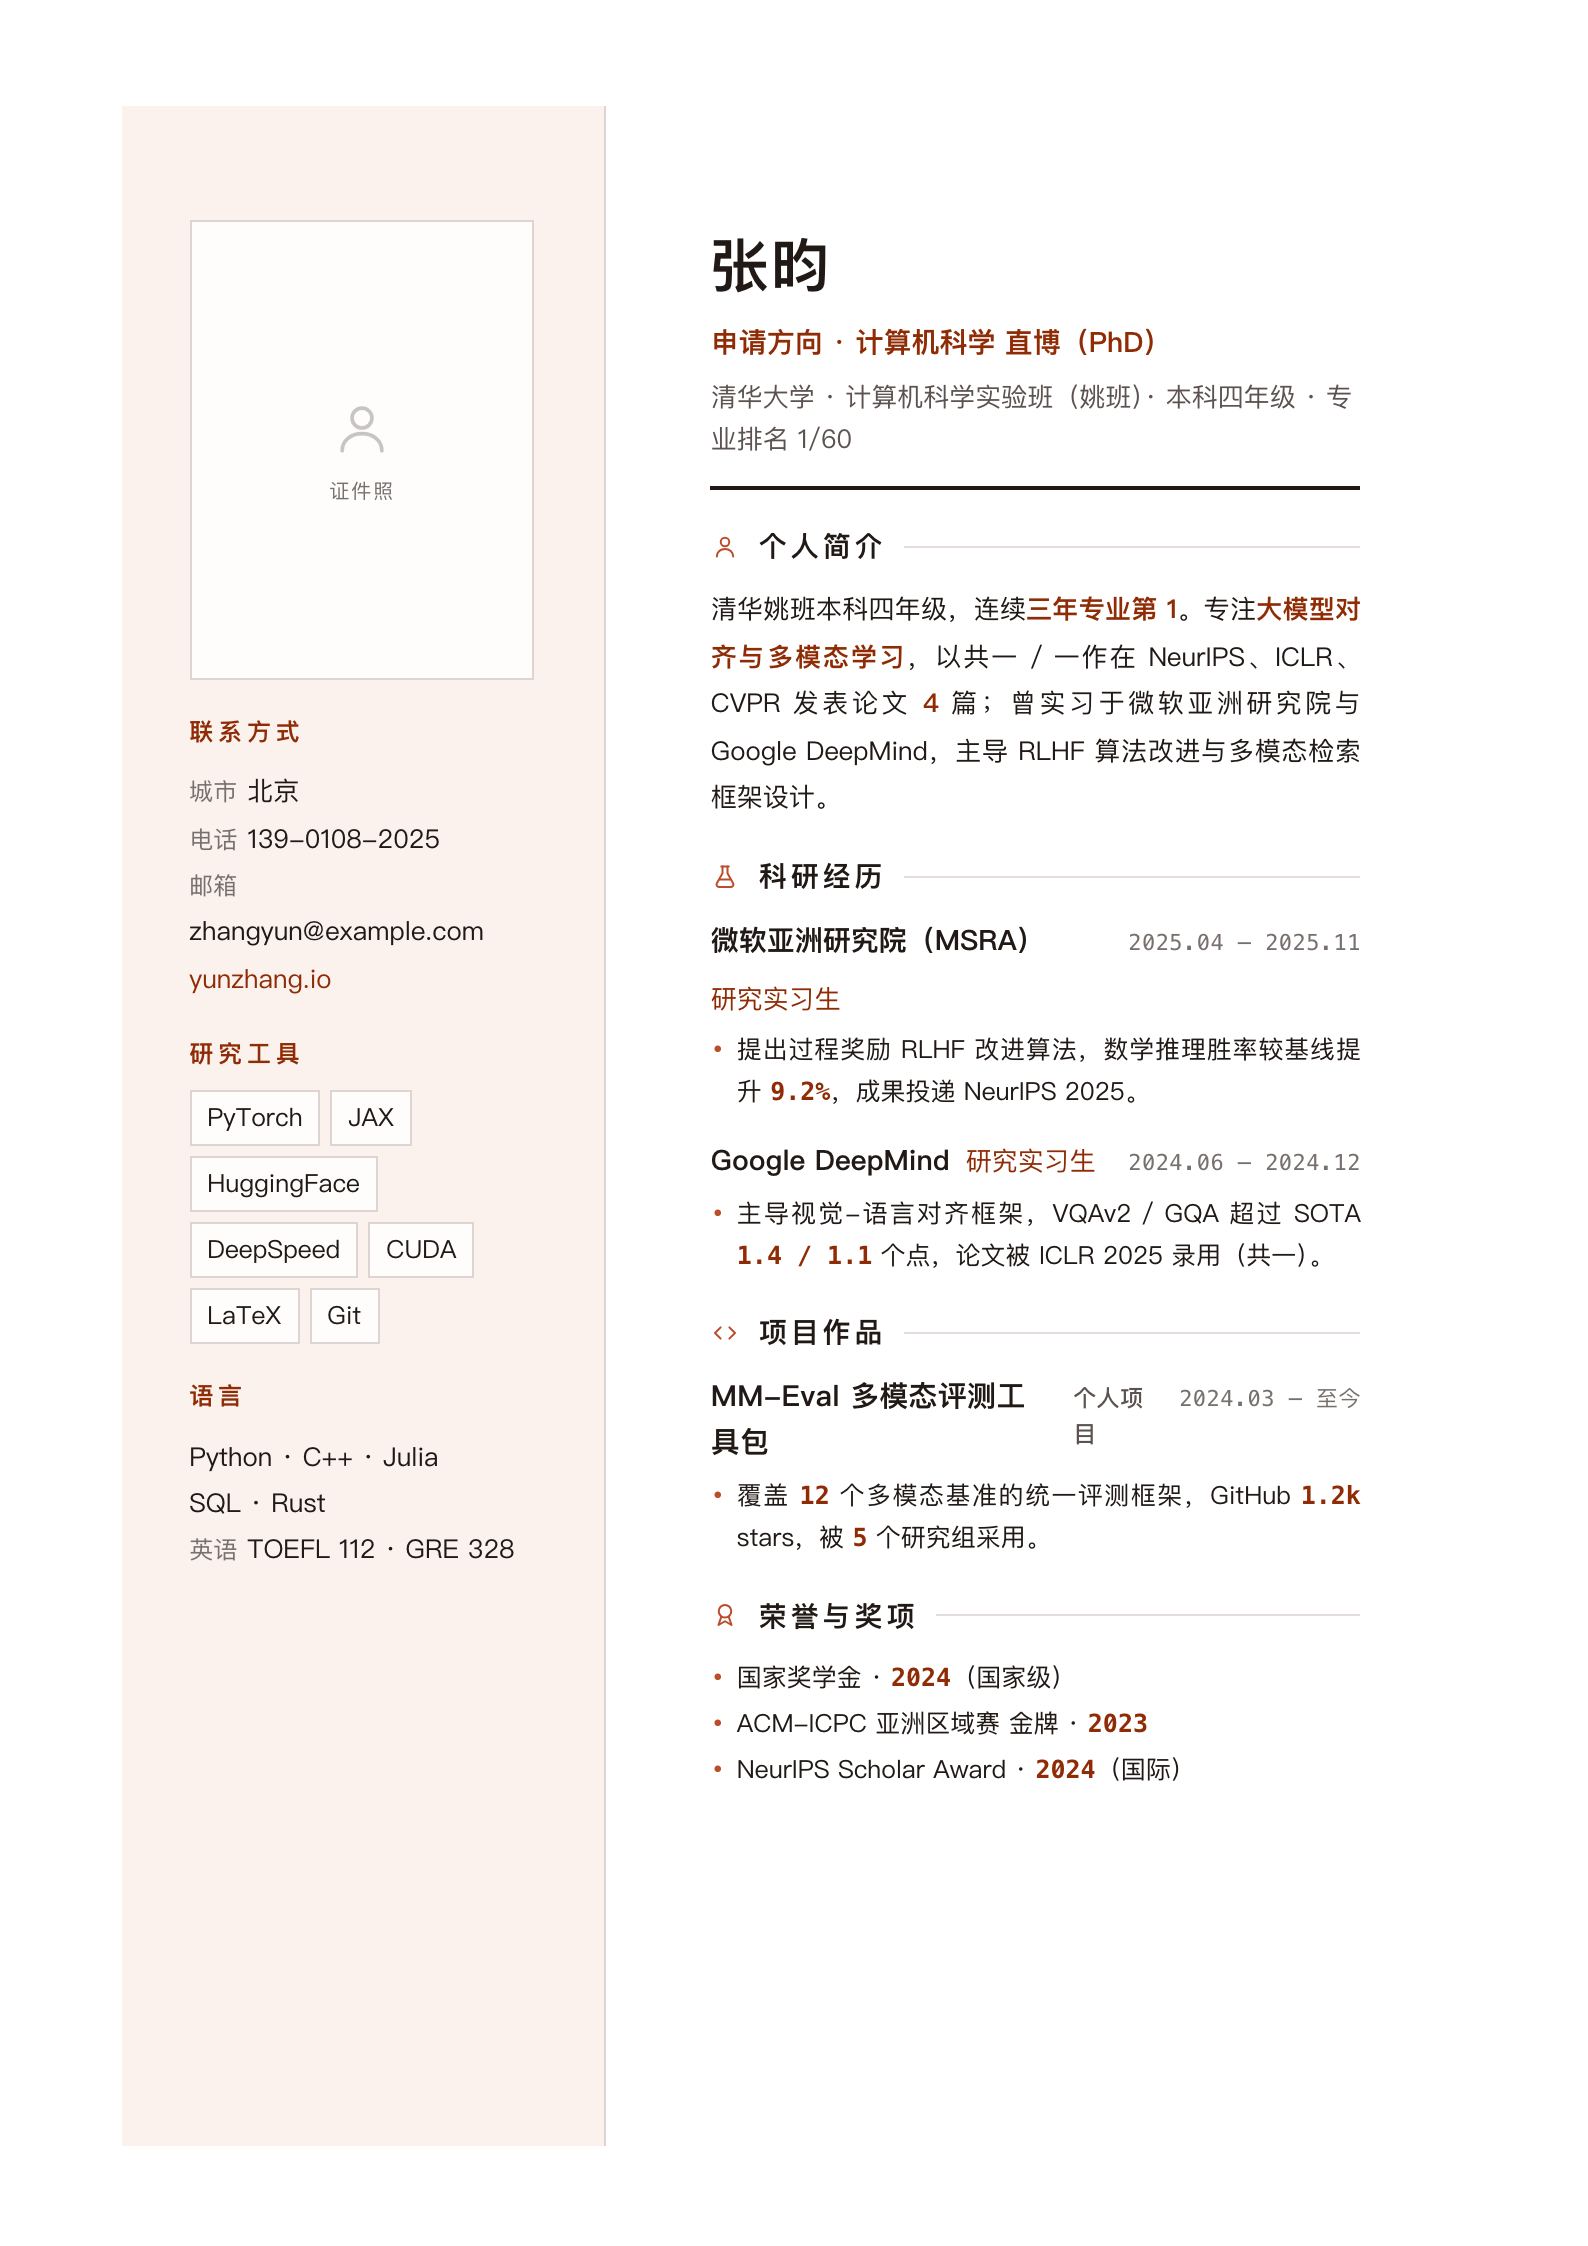
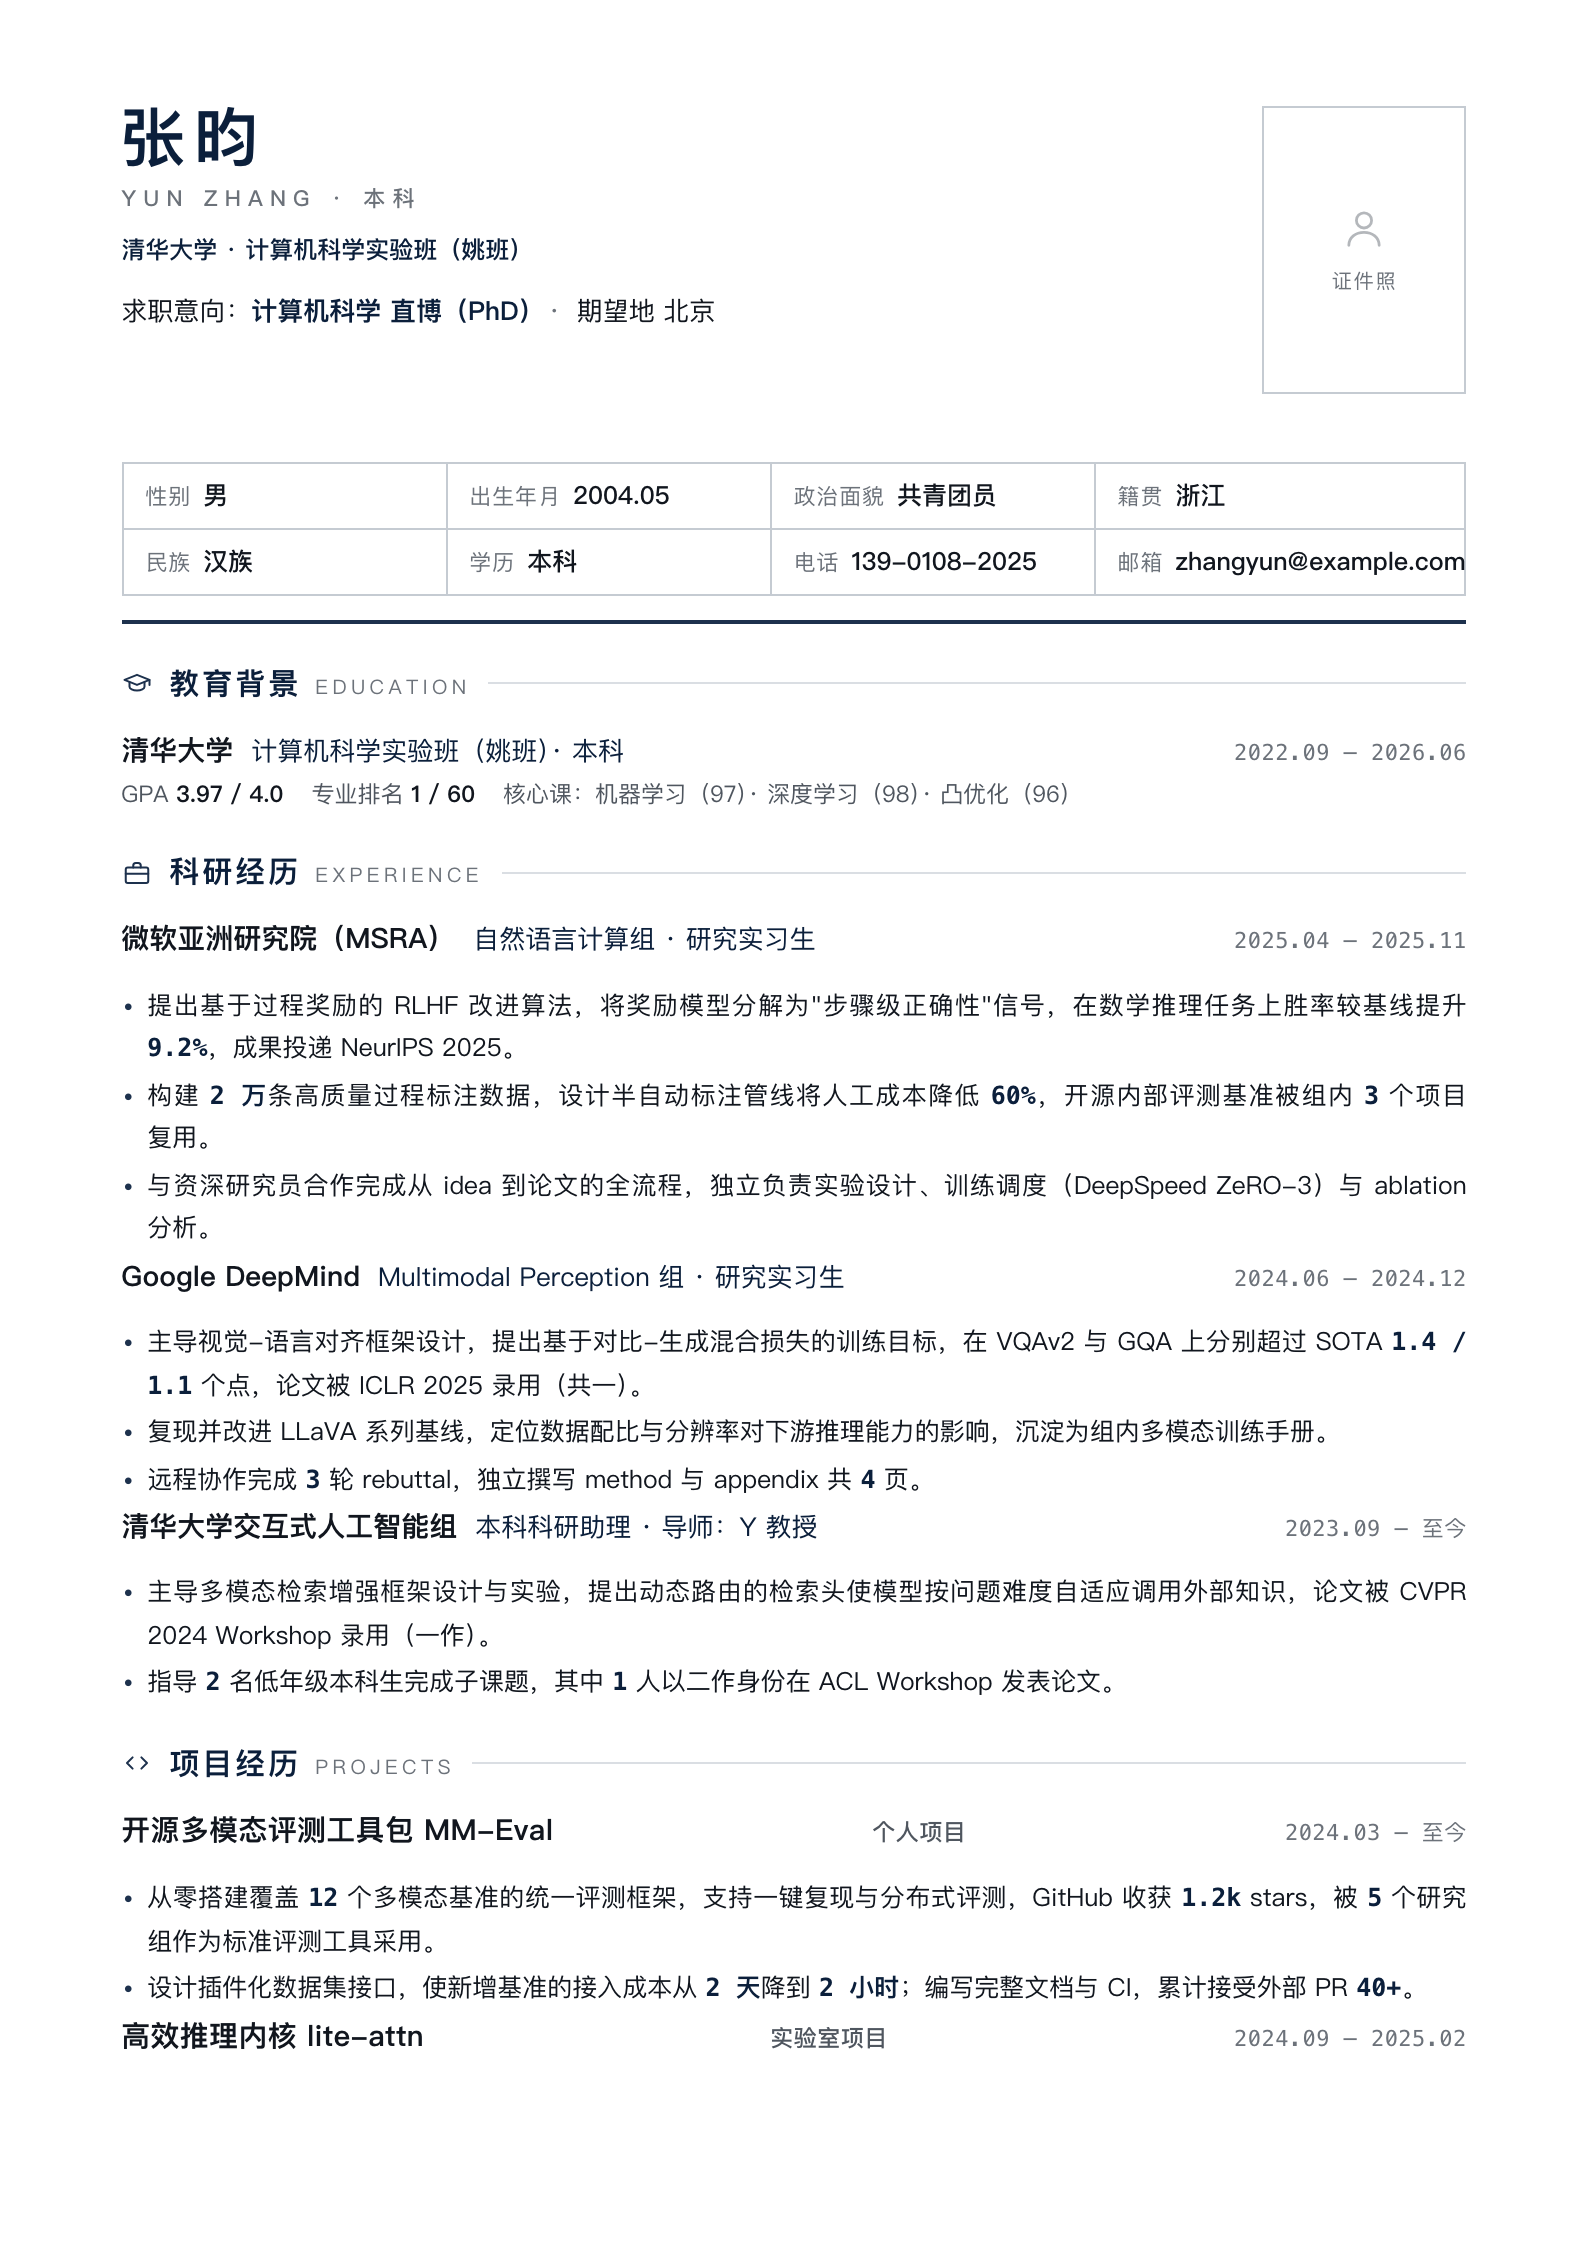
六套主题,同一份内容换皮:
| 学术 / 科研 | 技术密排 | 内容运营 |
|---|---|---|
 |
 |
 |
| 外企 / 英文 | 侧栏创意 | 国企 / 正式 |
|---|---|---|
 |
 |
 |
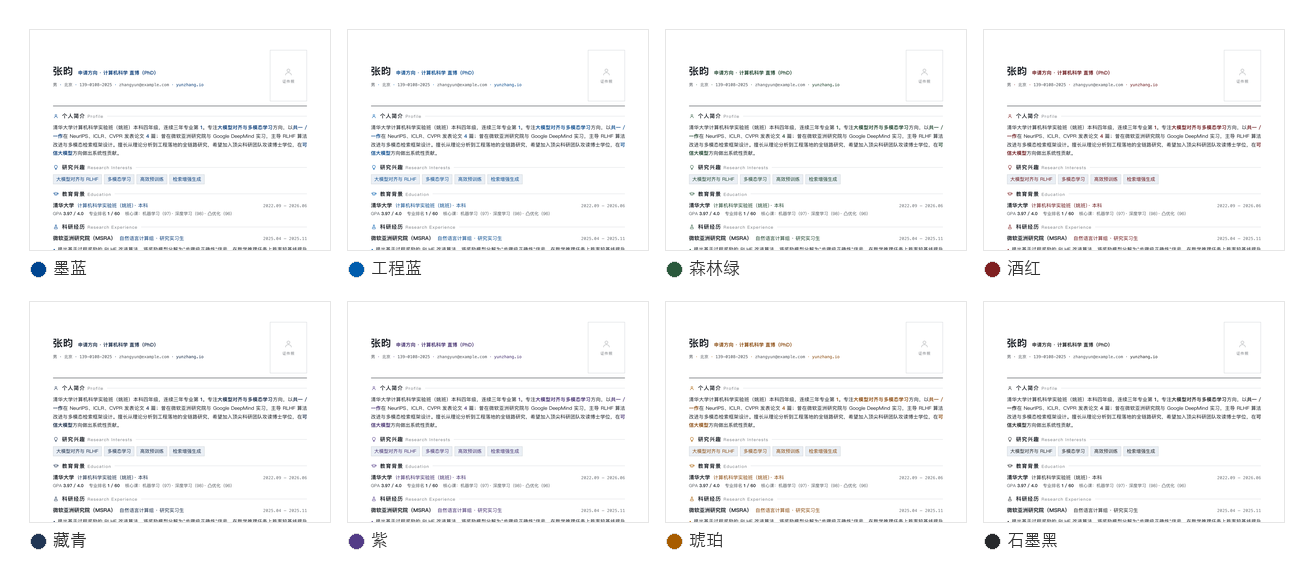
同一份简历还能换 8 套点缀配色,预览页选好,导出 PDF 沿用:
一个 skill,一条流水线
amlei-resume 一个 skill 管到底:记忆底座 profile.md + 多方向简历 + 按需岗位调研 + 预览导出。
内部结构:
SKILL.md:主流程、记忆与材料、每轮筛选决策自问references/index.md:参考文件索引与按任务读取顺序references/resume-format.md:简历.md的 DSL 与格式约束references/file.md:整个.amlei-skill/resume/的目录、命名与材料池规范references/profile.md:profile.md模板与熟练度判据references/job-research.md:按需调研 JD、岗位、行业与市场行情references/content-packaging.md:岗位化包装、程度校准与事实边界references/export.md:预览、配色与 A4 PDF 导出references/themes/:六套主题的组件库与规范scripts/:预览壳、页数检查、长图与证件照
上手
1. 安装(以 Claude Code 为例)
claude plugin add amlei/amlei-resume
2. 开聊。一句话就能开始——
- 「做了三年后端,想转 AI Agent 方向,这是我的旧简历,帮我重新讲一版。」
- 「帮我看看 AI Agent 开发在北京的行情,再按这个方向改一版简历。」
- 「简历定稿了,导出 A4 PDF,再帮我写几条招聘平台的开场白。」
更建议把目标、经历、材料来源一次说全,它就能照着画像开工。说漏了也没关系,细节是边聊边冒出来的。
几条较真的原则
- 能力必须有证据——写进
profile.md的每条能力,都要能指回证明它的项目;举不出证据的,只能算讲法。 - 写「做到什么」,不写「怎么做到的」——bullet 落在结果,做法细节是面试官的常识,写出来只会稀释重点。
- 事实更新只提醒,不动你的文案——底层事实变了,它标记出来等你决定,绝不自动改写你敲定的措辞。
- 记忆只记事实,不记措辞——简历怎么讲、怎么组织,不写回
profile.md。 - 定稿即沉淀——一份简历写完,里面首次出现的客观事实、成果、偏好会回写画像,下次不用重讲。
依赖
核心流程只依赖 Agent 自带能力;脚本为可选增强:
| 脚本 | 用途 | 依赖 |
|---|---|---|
wrap_preview.py |
把简历正文包进 A4 预览壳 | 仅 stdlib |
export_long_image.py |
导出简历长图 | playwright + Pillow |
extract_avatar.py |
从旧简历提取证件照 | opencv-python + numpy |
许可
MIT © amlei
Yorumlar (0)
Yorum birakmak icin giris yap.
Yorum birakSonuc bulunamadi