auto_paper_reading
Health Uyari
- License — License: MIT
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 5 GitHub stars
Code Gecti
- Code scan — Scanned 12 files during light audit, no dangerous patterns found
Permissions Gecti
- Permissions — No dangerous permissions requested
Bu listing icin henuz AI raporu yok.
AI agent skill for research paper reading: baseline comparisons, figures, equations, and illustrated Chinese/English Word reports. 无需 API key 的论文精读工具包:检索论文、对比 baseline、图文讲解,生成中英文 Word。
auto_paper_reading
简体中文(默认) · English documentation
一个给 AI Agent 用的论文阅读工具包(skill):把本仓库交给带视觉能力的 Agent
(Claude Code / Codex / Qwen Code / Kimi Code 等),对它说一句「阅读 XXX 论文」,
Agent 就会按 SKILL.md 工作流自动搜索下载论文 → 解析裁剪关键图 → 视觉选图 →
查找 baseline 与领域问题 → 图文结合撰写讲解 → 生成 docx → 渲染自检,最终交付中文或英文讲解 docx,默认中文。
工具包不调用 LLM API、不需要额外模型 API key:所有「智能」都由 Agent 自己完成,
本仓库只提供机械的解析、裁剪、排版与自检脚本。
先读完整案例:Attention Is All You Need
想先看看生成效果,可以直接阅读 output 中的中英文完整讲解,无须安装依赖:
| 语言 | 在线阅读 | 下载可编辑 Word |
|---|---|---|
| 中文 · 14 页 | 阅读 PDF | 下载 DOCX |
| English · 15 pages | Read PDF | Download DOCX |
两份案例均包含摘要、核心符号表、ConvS2S baseline 对比、完整方法与数据流、原文图表,以及结合后续论文的“证据 → 推断”场景分析。已通过公式检查和逐页视觉检查,详见案例说明与来源。
examples/ 提供可运行的中英文排版样例,便于了解内容格式。
可以得到什么
- 图文结合的中文或英文 Word 讲解,默认中文,也可分别生成两种语言。
- 前置摘要和精简符号表;正文讲清前置知识、方法动机、核心机制、数据流和实验结果。
- 查找可靠 baseline,对比双方核心;结合领域研究,以“证据 → 推断”分析解决范围和剩余问题。
- 可编辑公式、黑白三线表、居中的表格单元格和统一的三级标题编号。
- 使用免费 LibreOffice 转换 Word 输入、生成 PDF 和逐页预览,不需要 WPS 或付费转换服务。
在 Agensi 使用与发布
下载 Release 中的上传包:auto-paper-reading-agensi-v0.6.0.zip。包内包含技能入口、参考说明和 MIT 许可证;
运行时调用用户独立安装的本地工具包,需要 Agent 具备终端、文件、联网和看图能力。
本地重新打包:
python tools/package_agensi.py
输出位于 output/agensi-v0.6.0/,含上传 ZIP、商品文案、上传说明、文件清单和校验值。
打包采用固定文件清单,只收集技能需要的文本。GitHub 自动生成的 Source code ZIP
用于获取整套源码,上传 Agensi 时请使用上述专用附件。
怎么用
- 把本仓库放进 Agent 的工作区(克隆后在 Agent 中打开本目录即可;
Claude Code 也可以把SKILL.md挂到自己的 skills 路径下)。 - 对 Agent 说:「阅读 CVPR2025 的 OpenSDI」或「讲解 papers/xxx.pdf」。
- Agent 按
SKILL.md逐步执行,产出output/<论文名>/<论文名>/讲解_*.docx。
前提:Agent 具备联网检索与读图能力;本机装有 Python 3.10+ 与 Node.js。
首次安装依赖:
python -m pip install -r requirements.txt
npm ci
选择报告语言:说“用中文讲解 Attention Is All You Need”或“Explain Attention Is All You Need in English”。
需要两种版本时说“生成中文和英文两份讲解”,Agent 会在不同输出目录分别撰写、生成并检查。
# 英文流程;中文可将 en 换为 zh,省略 --language 时默认中文
python run.py papers/paper.pdf --stage prep --out output/en --language en
# Agent 在 output/en/paper/content.json 撰写英文内容,设置 "language": "en"
python run.py papers/paper.pdf --stage docx --out output/en --language en --verify
实际工作目录为 <--out>/<论文文件名(不含扩展名)>/。DOCX 阶段未传 --language 时,
优先读取 content.json.language,再默认中文;英文文件名为 Explanation_<论文标题>.docx。
PDF 解析和 DOCX 生成不依赖办公软件;Word 输入转换与 --verify 预览默认使用免费的 LibreOffice。
缺少转换器时仍可生成 DOCX,但不能声称完成了视觉检查。安装与选择方式如下。
PDF 转换后端
Windows / macOS:安装 LibreOffice,包含 Writer 与 Math。
Ubuntu / Debian 可用:
sudo apt install libreoffice-writer libreoffice-math fonts-noto-cjk fonts-liberation
程序自动查找 PATH 和常见安装目录。自定义路径时,LIBREOFFICE_PATH 指向可执行文件:
# Windows PowerShell;通常不需要手动设置
$env:LIBREOFFICE_PATH = 'C:\Program Files\LibreOffice\program\soffice.com'
# macOS 自定义路径示例;Linux 通常为 /usr/bin/libreoffice
export LIBREOFFICE_PATH=/Applications/LibreOffice.app/Contents/MacOS/soffice

# Word 输入:默认 LibreOffice
python run.py papers/paper.docx --stage prep --out output/demo
# 预览:默认 LibreOffice
python run.py papers/paper.pdf --stage docx --out output/demo --verify
# 可选:继续使用已安装的 Windows WPS 无头转换器
python run.py papers/paper.pdf --stage docx --out output/demo --verify --pdf-backend wps
--pdf-backend libreoffice|wps 同时用于 Word 输入和预览;--allow-wps 是 WPS 选项的别名,两者不能同时传。
转换器在系统临时目录中使用短文件名和独立配置,完成后验证 PDF,再安全写回目标目录;转换或写入失败时保留已有 PDF。需要允许本地转换器读写系统临时目录。
LibreOffice 支持 Windows、macOS、Linux;项目已在 Windows 验证真实 DOC/DOCX、深路径转换及中英文排版样例,
macOS/Linux 的实际渲染尚未验证。字体与办公软件的排版引擎会影响换行、公式间距和分页,须安装报告所需字体并逐页检查;
Linux 的替代字体不能保证与 Windows 页数一致。案例 PDF 的生成配置见案例说明。
效果演示
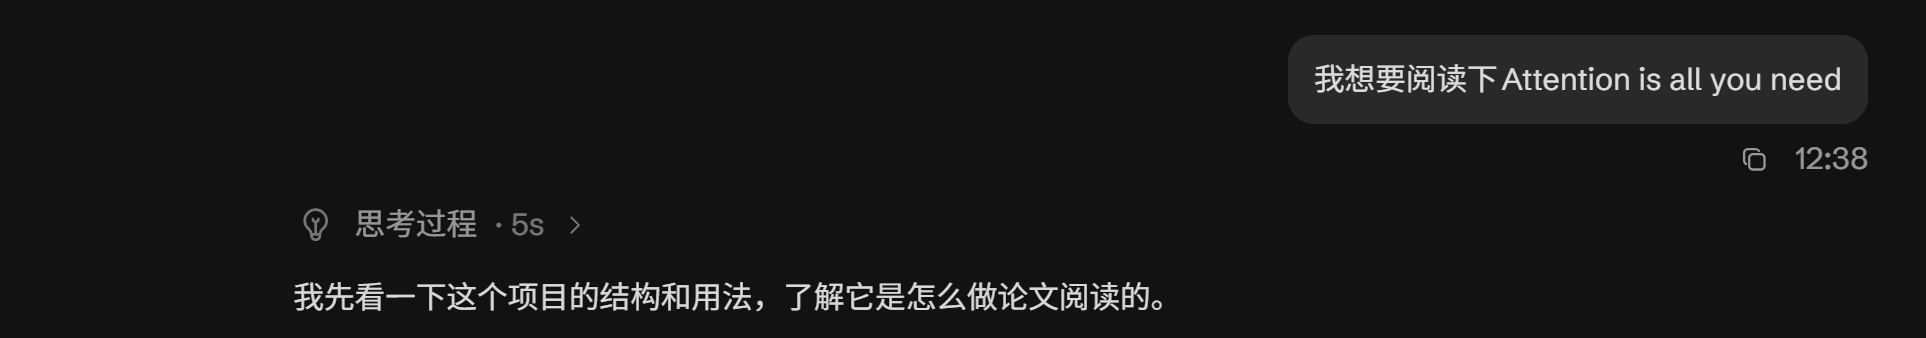
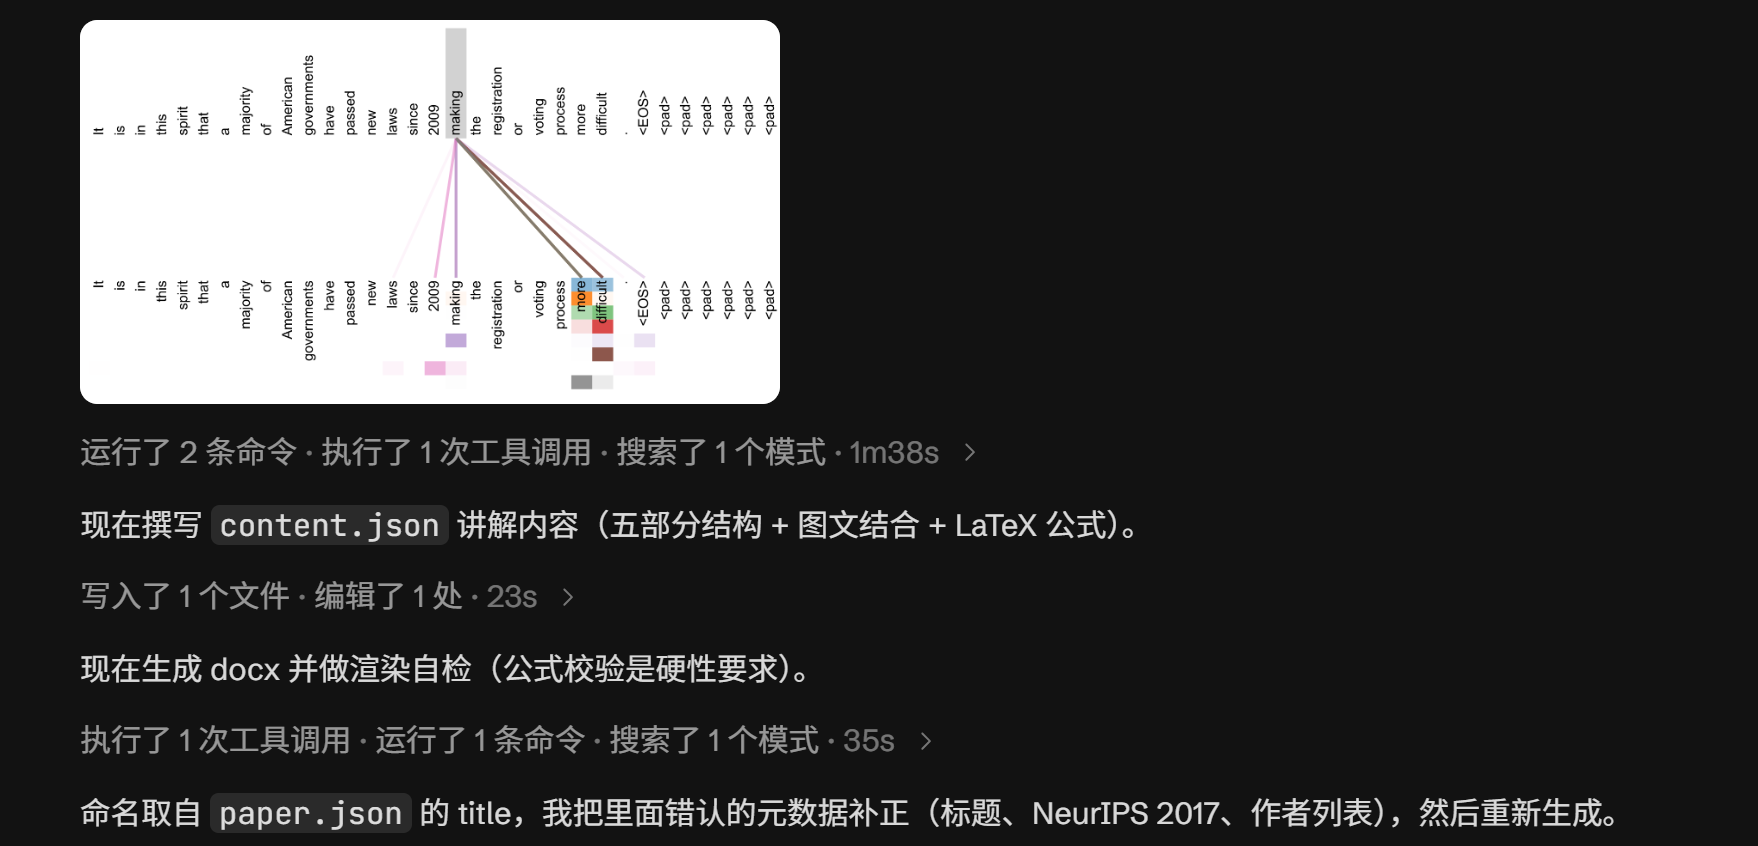
以对「Attention Is All You Need」的一次完整阅读为例:
| ① 一句话触发 | ② Agent 自动制作(看图 → 撰写 → 自检) | ③ WPS 打开成果 |
|---|---|---|
 |
 |
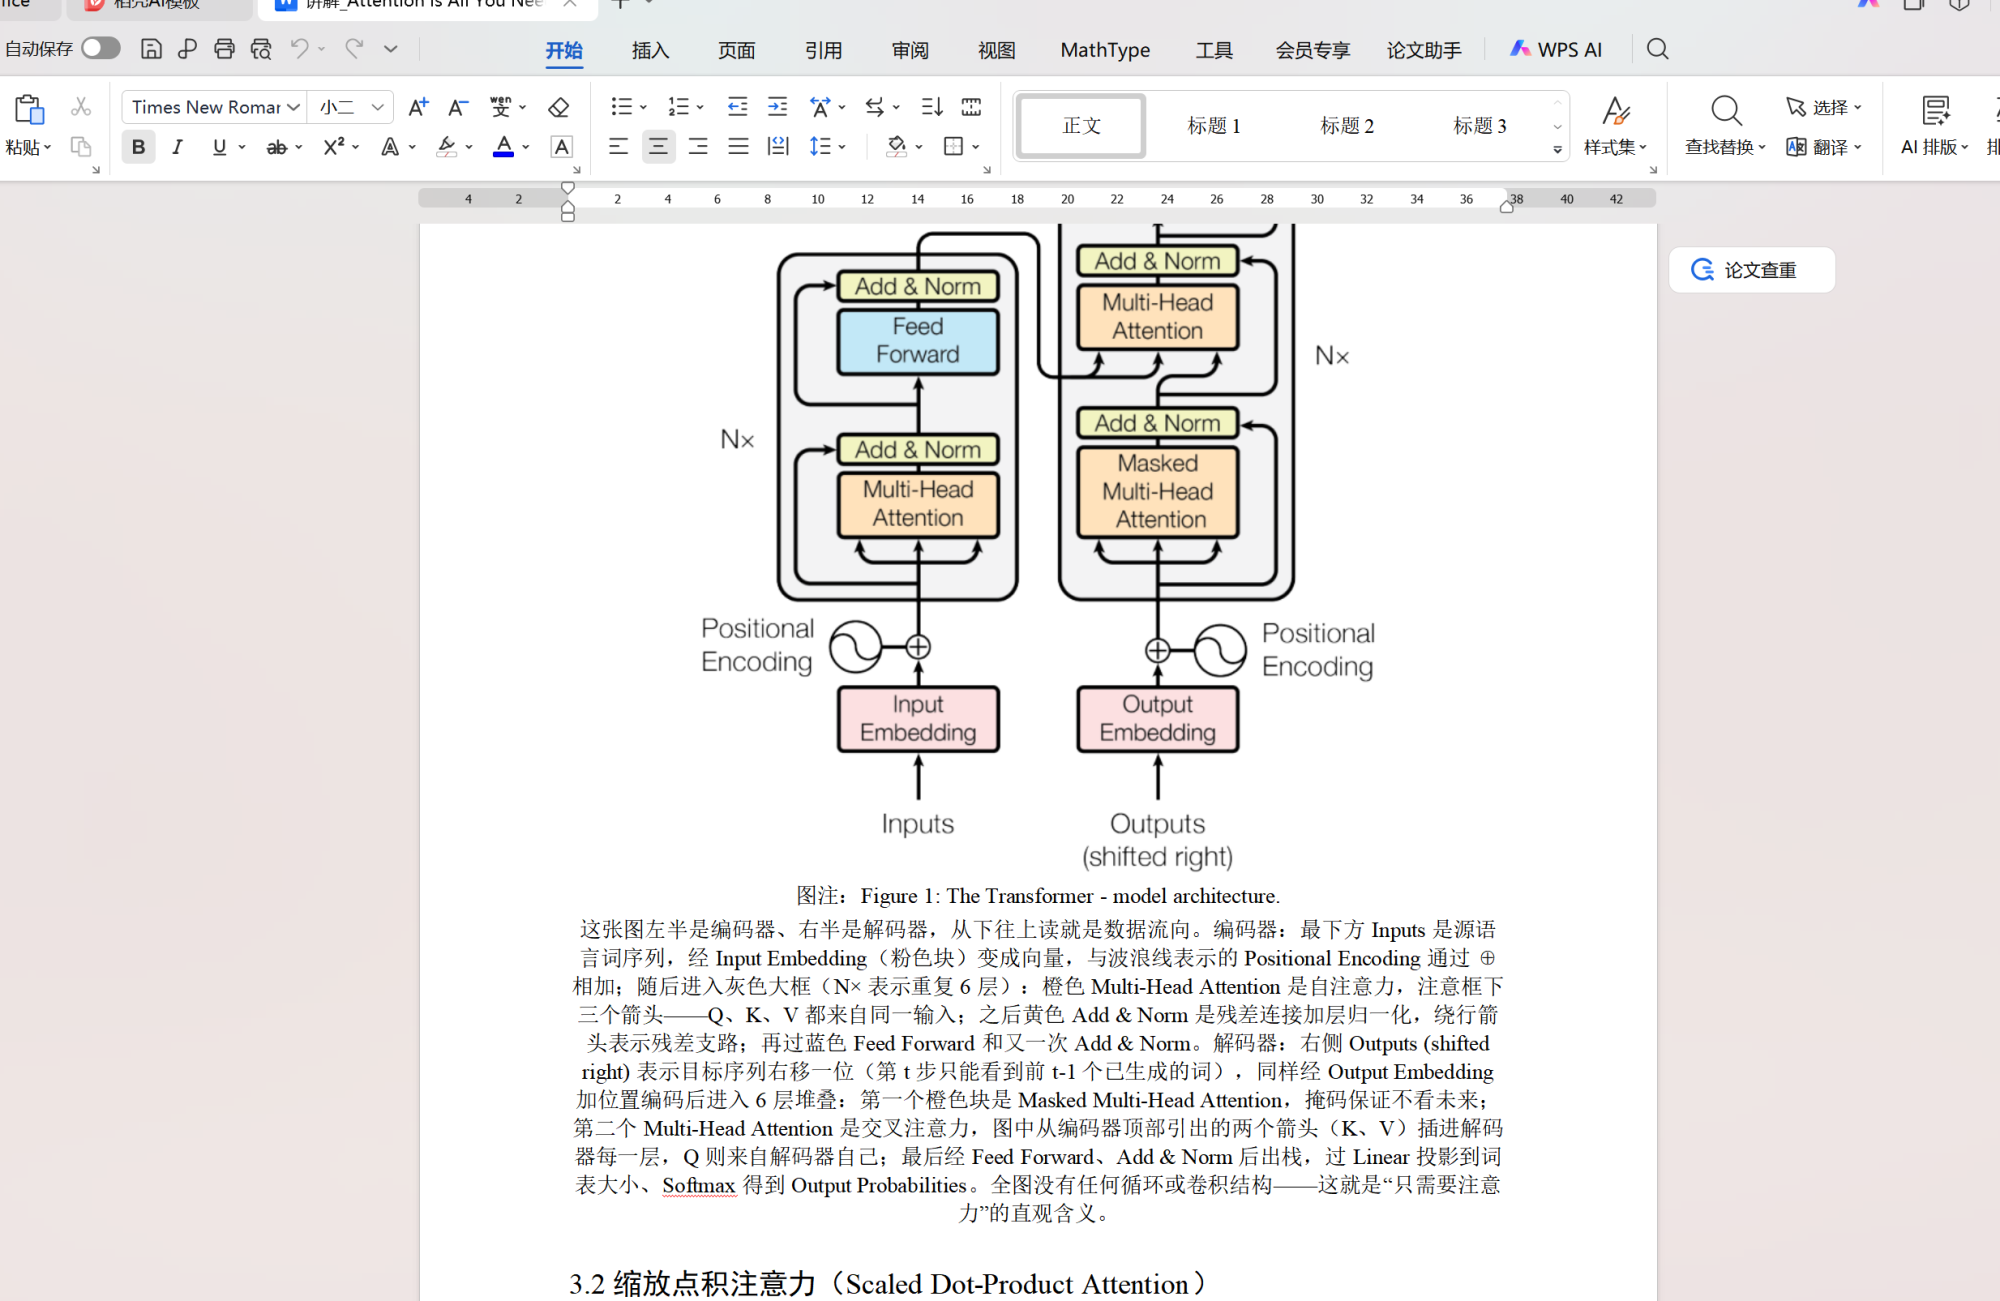 |
用户只需说「我想要阅读下 Attention is all you need」,Agent 便自动完成搜索下载、
解析裁剪、撰写图文讲解、渲染自检,最终交付可用 Word、LibreOffice 或 WPS 打开的讲解文档。
讲解内容结构
标题和发表信息之后,先给摘要 → 符号表,再进入五部分正文。
- 摘要:简述论文背景、应用场景、解决的问题和方法核心,报告具体数据集/划分、指标及数值;
有同协议 baseline 时给出对照值和原文出处,区分百分点与相对百分比。 - 符号表:只收录贯穿方法、反复出现、论文特有或易混淆的核心符号,解释含义、类型/维度、作用与出处。
简单索引、临时变量随用随释,维度中的辅助量可在同一行解释,不必另列。原文没给的维度不猜填。
中文正文采用三级编号标题 一 / 1.1 / 1.1.1;下一章为 二 / 2.1 / 2.1.1。
英文为 1 / 1.1 / 1.1.1;摘要与符号表不占编号:
- 基础知识讲解 —— 前置知识拆成小点逐个讲(CLIP、ViT、注意力、Adapter/LoRA、
Prompt Learning、测试时自适应、高频信号与 DCT、任务设定等),每点注明本文用法 - 方法灵感和发表期刊 —— 发表信息、动机、灵感来源
- 方法 —— 找到可靠 baseline 时,先对比 baseline 核心、本文核心及具体改动,再分模块图文讲解
- 输入内容的变换过程 —— 数据流视角:每一步如何变换、每步学什么、注意力如何变化
- 创新点、可以借鉴的经验 —— 核心创新点 + 实验结果(直接调用论文原表逐表讲解)+ 本文实际解决范围、仍未解决的问题与适用场景 + 可借鉴经验
第五部分撰写前,Agent 必须检索该领域近期相关论文,查清当前问题出现在哪些具体场景,
再对照本文的方法假设和实验覆盖,回答“本文解决了哪一部分、在什么条件下有效、还留下什么”。
每项按“证据 → 推断”展开,证据同时标注领域文献与主论文出处,并记录检索日期。
区分“未解决”与“尚未验证”,也区分历史论文的贡献与后续研究已处理的问题;不把旧问题直接称为
当前空白,不只列泛化、效率等通用缺点。检索不可用时说明实际依据范围,不声称已核实领域现状。
baseline 检索聚焦论文明确使用的基础方法或实验对照,区分两者,避免把骨干网络或最强竞品
直接当成方法基础。能找到可靠资料就讲清双方核心和改动;找不到就跳过,不递归扩展成文献综述。
数值优先比较同一实验协议下的结果;协议不同则分别描述,不直接相减作为改进收益。
生成 docx 的格式规范
| 元素 | 字体 | 字号 |
|---|---|---|
| 封面标题 | 黑体(西文 Times New Roman 正体) | 18pt |
| 一级标题 | 黑体 | 三号 16pt |
| 二级标题 | 黑体 | 四号 14pt |
| 三级标题 | 黑体 | 小四 12pt |
| 正文 | 宋体 | 小四 12pt |
| 图注/说明 | 宋体 | 10.5pt |
| 表格中的文字 | 宋体 | 小五 9pt |
| 参考文献 | 宋体 | 六号 7.5pt(整节匹配"参考文献/References"生效) |
- 英语字母和数字一律 Times New Roman 正体(中文正体,排版脚本自动切分)
- 仅公式中的变量(英语字母)采用斜体(由 OMML 数学样式承担),其他情况不做改变
- 全文档字体颜色统一黑色(含标题/正文/公式/图注,禁止主题蓝)
- 标题自动编号(中文一级 一、二、三……;英文一级 1、2、3……;二/三级均为 1.1 / 1.1.1),content.json 只写标题文字
- 所有生成的原生表格统一黑白三线表:顶线/底线 1.5pt,表头下方线 0.75pt,无竖线、无其他行间线,白底黑字。
表格整体居中,全部单元格(含表头、说明列和公式)均水平、垂直居中。原论文表格截图作为证据图保留原貌。 - 正文专业名词用
**术语**加粗;公式用$LaTeX$包裹,自动转为可编辑的原生 OMML 数学对象 - 实验结果直接裁剪论文原表(Table)高清嵌入 + 逐表讲解
Agent 执行流程(详见 SKILL.md)
输入(论文题目或本地文件)
  ↓ ⓪ 搜索下载:联网找开放获取 PDF,落到 papers/ 并验证文字层
  ↓ ① 解析裁剪:python run.py papers/xxx.pdf --stage prep --out output/xxx
  ↓ ② 视觉分析:Agent 逐张看候选图选关键图,不理想则按坐标重裁
  ↓ ②.5 查找 baseline:从主论文定位,按需检索原作,对比双方核心;找不到就跳过
  ↓ ②.6 检索领域问题:查近期相关论文中的难题和场景,对照本文已解决、未解决及未验证范围
  ↓ ③ 撰写讲解:写 output/xxx/xxx/content.json(摘要 → 符号表 → 五部分图文正文)
  ↓ ④ 生成 docx:python run.py papers/xxx.pdf --stage docx --out output/xxx
  ↓ ⑤ 自检:--verify 渲染预览逐页核验 + python tools/verify_math.py
  ↓ ⑥ 交付:对话中讲解 + 告知 docx 路径
交付自检(硬性要求)
python run.py papers/xxx.pdf --stage docx --out output/xxx --verify   # 默认 LibreOffice 无头渲染
python tools/verify_math.py "output/xxx/xxx/讲解_标题.docx"                # 指定交付版本,检查对应 PDF
逐页查看预览,并放大检查公式密集区域;全部通过才交付。输出 docx 被占用(如正被 WPS 打开)时自动写 _v2 文件。
内容格式与检查
顶层
language支持"zh"(默认)或"en";正文不由排版器自动翻译。新报告顶层填写
abstract(非空的目标语言字符串)和symbols(符号数组),自动放在正文前;symbols每项填写symbol、meaning、shape、role、source,数学内容用$...$。
没有需要集中查询的核心符号时用[],简单变量在正文解释。原生可编辑表格块:
{"type":"table","headers":["方法","核心"],"rows":[["Baseline","核心机制"],["本文","具体改动"]],"column_weights":[1,3]}。
单元格支持换行、加粗和行内公式,表头跨页重复;表格内公式也会转换为 OMML 并执行数学检查。
详细字段和写作规范见 SKILL.md。正文与图后讲解默认两端对齐;封面、图注保留居中。
正文与图后讲解首行缩进 2 个汉字,随字号调整;标题、独立公式和图注不缩进。
独立公式单独一行,居中显示、编号右对齐;中文为(1)、(2)……,英文为 (1)、(2)……,均全文连续编号。
推荐公式块:
{"type":"equation","latex":"y = Wx + b"},不手工写编号。$...$在句内渲染为可编辑公式,不编号;多行$$...$$自动拆为独立编号公式并保留前后文字。句内变量和上下标同样使用 LaTeX。使用 Python
--stage docx完成 OMML 公式注入;Node 脚本仅为中间排版阶段。数学检查强制执行:逐公式核对
_/^与 OMML 上下标结构,扫描正文及数学对象残留;失败阻止成功返回,同名.math_audit.json记录位置及问题。文件名等字面下划线须用
math_review_exceptions记录完整段落和reason后逐项复核;公式内部残留不能豁免。交付前仍须渲染并逐页核对,自动检查不能证明数学语义或视觉效果正确。图片默认等比例缩到最高 4.5in,避免大图挤走正文;图片与图注保持相邻,标题与后文同页。
可在顶层
layout设置max_figure_height_in/max_figure_width_in,单个 figure 或引用它的 block 可用max_height_in/max_width_in覆盖。章节或 block 支持
page_break_before: true;{"type":"page_break"}可在下一段内容前换页。--verify生成verify/layout_audit.json,根据实际文字和图片位置提示大块留白。Agent 按 SKILL.md 主动检查全篇、调整单图尺寸或分页并重新渲染;审计不会自行改写内容,也不保证一次排版就最优。
目录结构
├── README.md / README.en.md    # 中英文说明,默认中文
├── SKILL.md / SKILL.en.md      # 本地工具包的中英文 Agent 工作流
├── skills/auto-paper-reading/ # Agensi 入口、参考文件与 MIT 许可证
├── marketplace/agensi/        # 英文商品文案与上传说明
├── examples/                  # 中英文 content.json 排版示例
├── docs/images/                # README 效果演示截图
├── run.py                      # CLI 入口(prep / docx 两阶段)
├── src/auto_paper_reading/     # 核心 Python 包(无 LLM API 依赖)
│   ├── parser/                 #   解析层(pdf/docx/doc 统一为 PaperDocument)
│   ├── figures.py              #   配图提取与裁剪(光栅图 + 图注定位矢量图)
│   ├── omml.py                 #   LaTeX → 可编辑的 OMML 公式
│   ├── models.py / docx_content.py  #   数据模型 / content.json 中间格式
│   └── cli.py                  #   命令行编排
├── tools/
│   ├── build_docx.js           # docx-js 排版(字体/字号/编号/公式占位)
│   ├── verify_math.py         # 公式渲染交付自检
│   └── package_agensi.py      # 生成 Agensi 上传包与商品资料
├── papers/                     # 论文输入目录(Agent 自动下载或用户提供)
├── output/                     # 讲解输出;公开 Attention 中英文案例,其余默认忽略
├── tests/                      # 功能与回归测试(python -m pytest tests/ -q)
├── requirements.txt / package.json / pytest.ini
依赖
- Python 3.10+:
pymupdf、python-docx、pillow、lxml - Node.js:
docx(docx-js 排版,npm ci) - LibreOffice(免费开源):仅
.doc/.docx → PDF输入转换与--verify预览渲染需要 - WPS Office:可选兼容后端,显式
--pdf-backend wps;不属于默认依赖 - 不需要:任何 LLM API key、OpenAI SDK、联网模型服务
许可证与引用
本项目的原创代码与文档采用 MIT 许可证。案例中引用的论文图表及其他第三方材料保留各自的版权与许可,来源见案例说明和报告参考文献。
在研究中使用本工具包时,可通过仓库侧栏的 Cite this repository 获取引用格式,元数据见 CITATION.cff。它引用的是本工具包;引用论文内容时仍应引用对应原论文。
Yorumlar (0)
Yorum birakmak icin giris yap.
Yorum birakSonuc bulunamadi