hypercontext-mode
Health Uyari
- License — License: NOASSERTION
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 5 GitHub stars
Code Gecti
- Code scan — Scanned 12 files during light audit, no dangerous patterns found
Permissions Gecti
- Permissions — No dangerous permissions requested
Bu listing icin henuz AI raporu yok.
Unified context OS for AI coding agents: sandboxed tool output + persistent memory + reversible conversation compression. Merges context-mode and billion-context.
HyperContext Mode

The other half of the other half.
Sandboxed tool output + reversible conversation compression, in one runtime.
HyperContext Mode 把两个互补的项目合并成一个上下文操作系统:
- context-mode — 管「进入上下文的工具输出」:沙箱执行、FTS5 知识库、会话记忆、hooks 路由、MCP 工具。
- billion-context — 管「已经进入上下文的对话历史」:模型 API 代理、增量分层压缩、可逆解压、前缀缓存友好。
想知道到底有没有用:直接看 效果实测 —— 本机跑出来的真实字节数,连失败案例一起写(自然语言提问 0/4 命中)。
合并后的 hctx 不是把两个 CLI 包一层,而是共享策略、存储、检索和生命周期的三层运行时:
┌──────────────────────────────────────────────────────────────┐
│ Client (Claude / Codex / Qoder / WorkBuddy / ... 34)         │
│   ├─ MCP: unified endpoint → ctx_* + hc_*                    │
│   ├─ Hooks: PreToolUse / SessionStart / PreCompact           │
│   └─ Model traffic: base URL / launcher / native plugin      │
└───────────────┬───────────────────────────┬──────────────────┘
                │                           │
        ┌───────▼────────┐          ┌───────▼──────────────┐
        │ Sandbox layer  │          │ Compression layer    │
        │ context-mode   │          │ billion-context      │
        │ - executor     │          │ - API proxy          │
        │ - FTS5 memory  │          │ - ACP summaries      │
        │ - session DB   │          │ - decompress/search  │
        └───────┬────────┘          └───────┬──────────────┘
                │                           │
        ┌───────▼───────────────────────────▼──────────────┐
        │ Control plane: policy · config · federation       │
        │ ~/.hypercontext/{config.json,data,state,logs}     │
        │ hc_search · hc_status · hc_doctor · hctx CLI      │
        └───────────────────────────────────────────────────┘
Windows 一键安装器(推荐小白)
下载 HyperContext-Setup.exe · 安装器源码
原生 WPF,支持 Windows 10/11,不需要管理员权限,不是 Electron。界面按「国际版 / 国内版」分组:
| 国际版 | 国内版 |
|---|---|
| Claude Code | Qoder 国内版 |
| Codex CLI | WorkBuddy 国内版 |
| Qoder 国际版 | DeepSeek Harness (dsh) |
| WorkBuddy 国际版 | Zcode (Z.ai) |
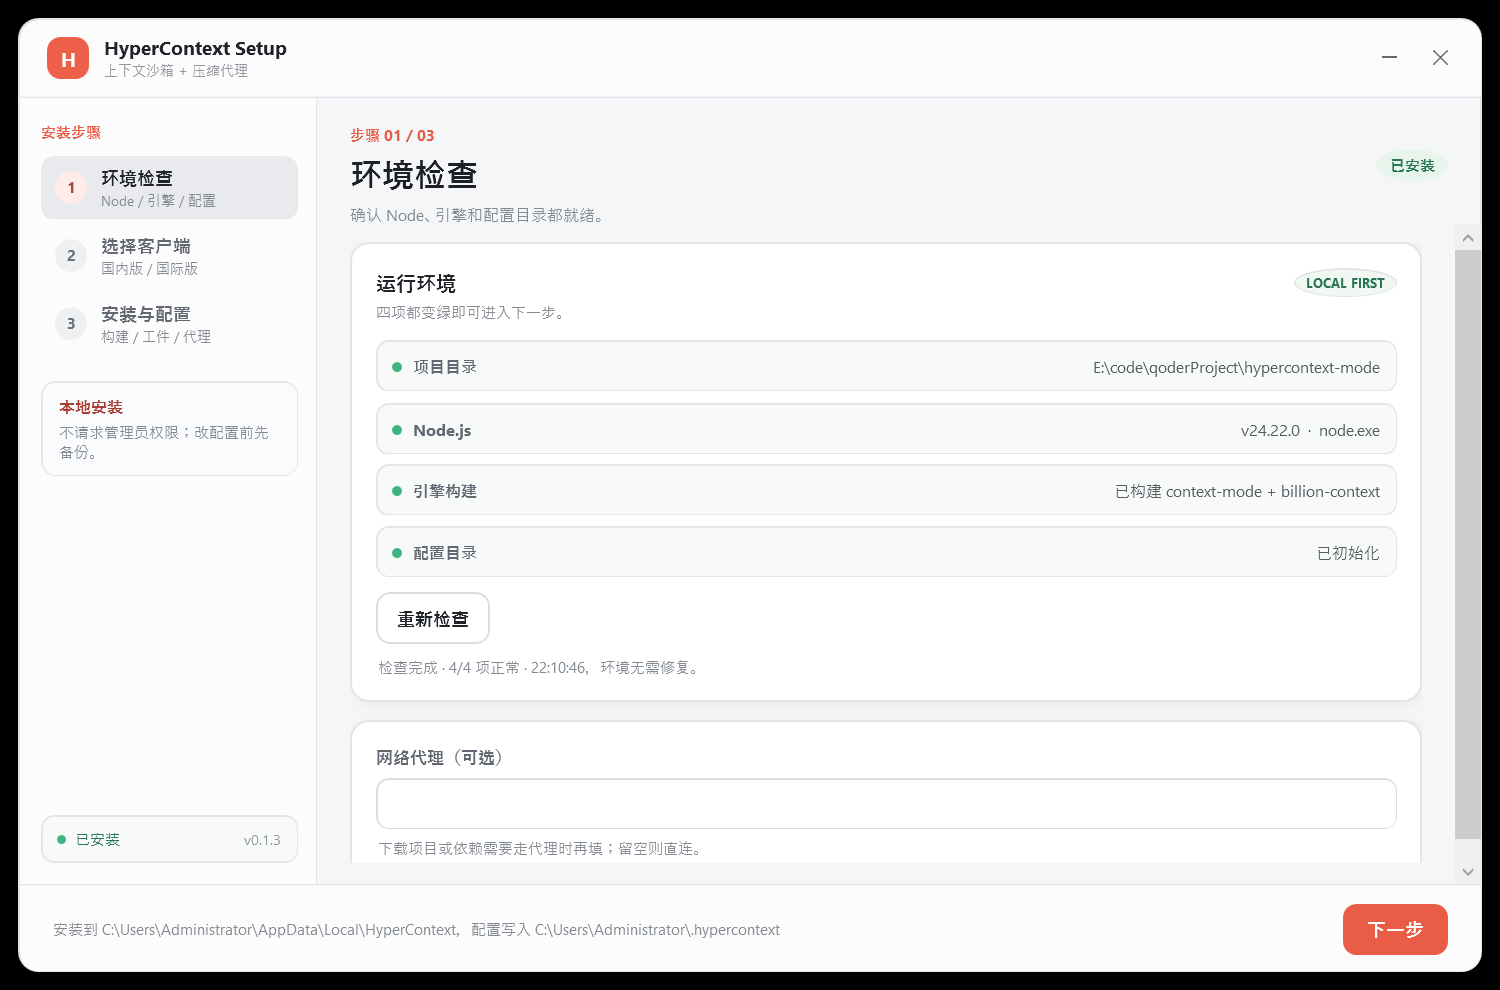
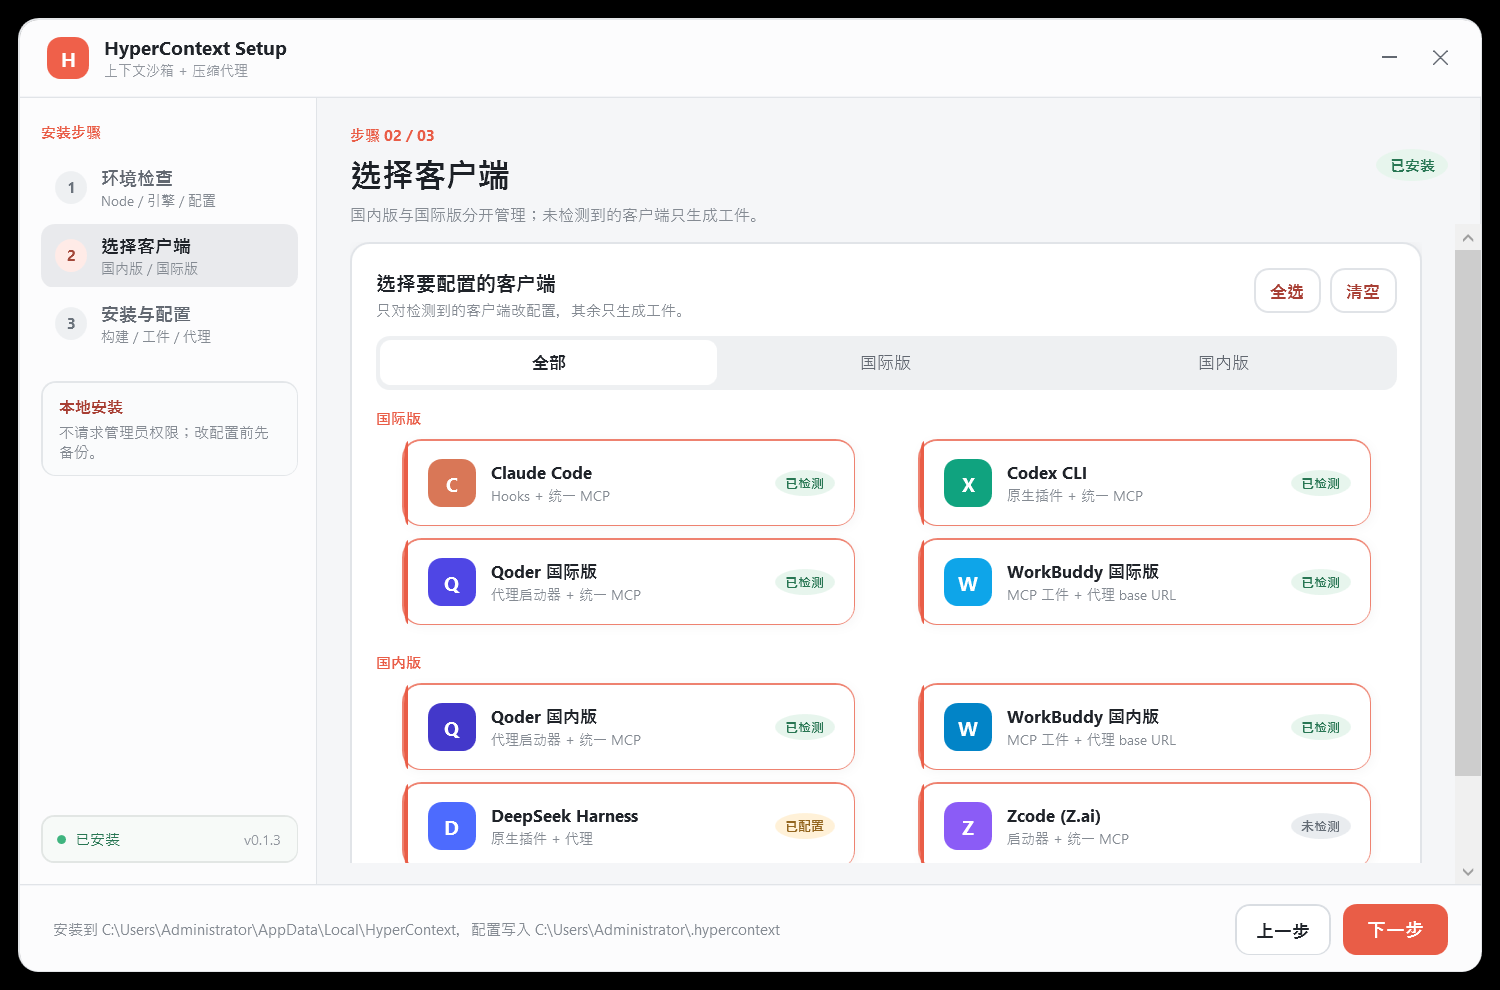
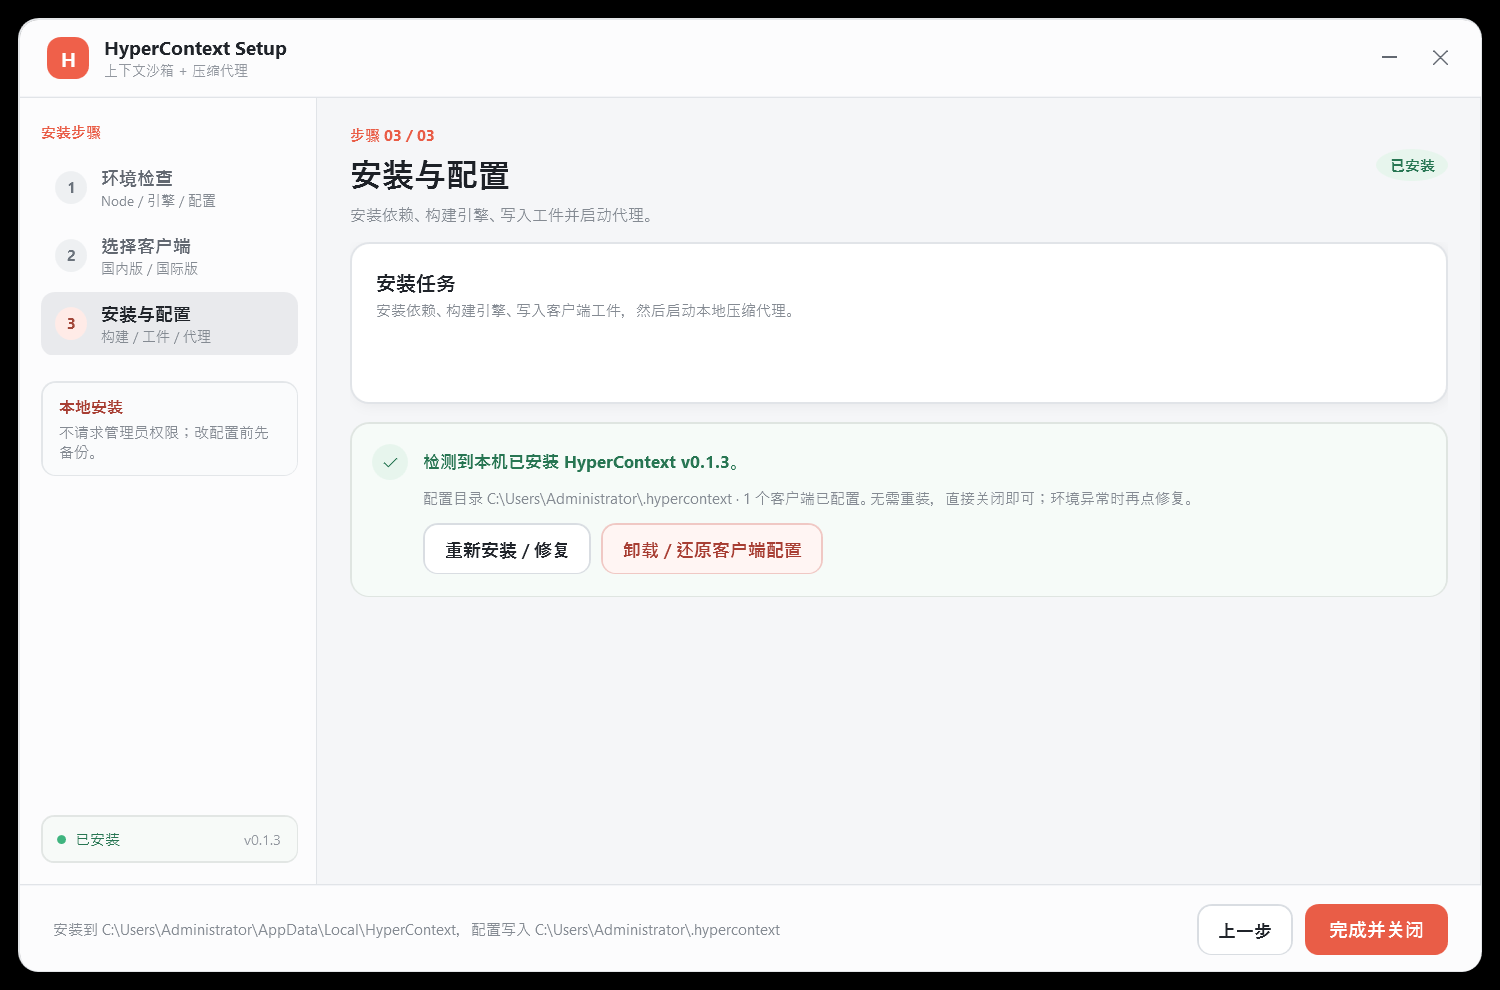
安装器会:
- 检测 Node.js 22.18+;没有就自动下载便携 Node 24。
- 如果本机没有项目,自动下载 GitHub 源码到
%LOCALAPPDATA%\HyperContext\app。 - 安装依赖并构建 context-mode / billion-context。
- 初始化
~/.hypercontext。 - 为选中的客户端生成 MCP / 启动器工件;只对检测到的客户端安装 hooks 或原生插件,并在修改前备份。
- 启动本地压缩代理,运行
hctx doctor和hctx status。
安装成功后安装器会记录状态(~/.hypercontext/state/installer.state)。再次打开时若检测到已安装,第三步会直接给出完成并关闭,不会强迫你重装;需要重建环境时再点重新安装 / 修复。
第一步只列出真正需要的操作:四项全绿时只剩重新检查(会给出检查结果和时间),缺 Node 或缺源码时才出现下载 Node 24、下载项目、选择已有源码目录…;需要补环境时才出现修复运行环境。
下载失败? 源码和 Node 的下载都会依次尝试多个源(GitHub → ghfast.top → ghproxy.net;nodejs.org → cdn.npmmirror.com → 清华镜像),每次尝试的失败原因都会写进日志,状态角标显示最后一次的真实错误而不是一句「下载失败」。仍然失败时:在网络代理里填代理后重试,或点**选择已有源码目录…**直接用本地源码(此时完全跳过下载)。npm 安装失败会自动改用
registry.npmmirror.com重试一次。
Qoder / WorkBuddy 的客户端 MCP 配置仍需在客户端里手动添加;安装器会生成对应的
mcp.json并在日志里打印路径。Qoder 的压缩层用hctx launch qoder启动。
如果你更喜欢手动安装,继续看下面的章节。
目录
- Windows 一键安装器
- 它解决什么问题
- 效果实测(安装前 vs 安装后)
- 功能总览
- 快速开始
- 安装
- 客户端接入
- 日常使用
- 统一 MCP 工具
- 配置
- 数据目录与隐私
- 故障排查
- 架构
- 与上游的关系
- 开发与测试
- 卸载
- 许可证
- 路线图
它解决什么问题
一次 MCP 工具调用会把原始数据直接灌进上下文:一个网页快照、20 个 GitHub issue、一份访问日志,可能瞬间吃掉几十 KB。与此同时,长会话的历史会不断膨胀,最终触发宿主压缩,模型忘掉正在改的文件、任务和用户刚才的要求。
两个上游分别解决了一半:
| 问题 | 谁来解决 | 合并后的行为 |
|---|---|---|
| 工具输出太大 | context-mode | ctx_* 沙箱执行,只把结果放回上下文 |
| 网页/命令/文件内容需要反复查 | context-mode | FTS5 索引 + BM25/trigram 检索 |
| 压缩后忘记上下文 | context-mode | SQLite 会话事件 + 可检索记忆 |
| 对话历史无限增长 | billion-context | API 代理 + 增量分层压缩 + 可逆解压 |
| 长会话跨天/跨周 | billion-context | 单会话可承载数十亿 token |
| 两套工具/存储/安装器打架 | 本项目的控制面 | 统一 MCP、统一搜索、统一状态、统一策略 |
效果实测(安装前 vs 安装后)
下面每个数字都是在本机(Windows 10 + Node 24)跑真实代码得到的,一条命令复现:
node tools/bench-effect.mjs --json docs/bench/effect.json
场景:从一份 68,567 B 的源文件里找回 4 个确切标识符
| 做法 | 模型侧要吃的字节 | vs 每次都读全文 |
|---|---|---|
| 每次都把整份文件读进上下文 | 274,268 B | — |
| 读一次全文,之后每次 grep(保守基线) | 69,649 B | −75% |
索引一次 + ctx_search 逐个找回 |
3,878 B | −98.6% |
这条路径不是白拿的:4 个标识符里 hypercontext-uninstall.bak 没检索到(分词把点号切开了)。所以沙箱检索不能当成 grep 的直接替身——命中后要核对,没命中就退回 grep / 直读。
它擅长什么、不擅长什么(同一脚本实测命中率)
| 查询类型 | 例子 | 命中 |
|---|---|---|
| 确切标识符 | RefreshClientBadges、installer.state、EnsureCodexMcp |
3 / 4 |
| 自然语言提问 | "卸载时备份文件叫什么名字"、"谁来负责启动压缩代理" | 0 / 4 |
ctx_search 是 BM25 + trigram 关键词检索,不是问答引擎。要答案,要么自己给准检索词,要么用 ctx_execute 让代码替你算。
大文件读取会被拦吗?
不会。读 68,567 B 的文件时,hook 只在本会话第一次注入 487 B 引导(提示改用 ctx_execute_file),读取本身照常放行。默认 balanced 和 advisory 都不拦;只有 strict 才对 WebFetch / curl 这类外部抓取做硬重定向。
压缩层到底省了多少?
这台机器上测不出来,我们就不编数字。 压缩率取决于模型自己写的摘要和真实流量,只有正常用一段时间才有意义。看实时数据:
hctx stats     # returned / avoided 字节、tokensSaved、hitPct、压缩块数
hctx status    # 代理健康度 + 概览
avoided 是 hook 逐次记账的真实字节数,不是估算。
有一项优化这次没测出差异
HYPERCONTEXT_MEMORY_INJECTION=minimal(会话恢复时只给一行提示、不灌整份快照)在本机两种模式下都是 4,968 B——因为这里没有真实客户端会话可恢复,快照本身是空的。要看到差异,需要在 Claude Code / Gemini CLI 里跑足够长的会话并触发一次压缩。
在 Qoder 里做的真 A/B(同一任务,四种配置)
任务:只依据 installer/HyperContextSetup.cs(1758 行 / 68,567 B)回答 6 个代码问题。每种配置各开一个全新 Qoder 会话,互不共享历史。
| 组 | 配置 | 实际工具序列 | 进入上下文的字节 | 答案正确率 |
|---|---|---|---|---|
| A | 未接入 | Bash×1 + Read×2(全文)+ Grep×1 |
≥ 68.6 KB 正文(另有 Read 行号前缀约 12 KB) | 5/6 + 1 题正确拒答 |
| B | 只挂 MCP,不引导 | Read×1(全文) |
≥ 68.6 KB | 5/6 + 1 题正确拒答 |
| C | 挂 MCP + 引导(修复前) | mcp_call 失败 → Grep×17 + Read×3 |
与 A 同量级 | 5/6 + 1 题正确拒答 |
| D | 挂 MCP + 引导(修复后) | ctx_execute_file×8 + ctx_stats×1 |
29.2 KB(ctx_stats 原文) |
5/6 + 1 题正确拒答 |
四个结论都是数据给的,不是推测:
- 正确率一模一样(都是 5/6;第 6 题的答案确实不在该文件里,四组都正确地回答了"找不到")。沙箱不提升答案质量,它只搬运字节。
- 只挂 MCP 不会自动生效:B 组一次
ctx_*都没调用。Qoder 的 MCP 工具是懒加载的,模型不会主动去够——省字节必须靠引导(hooks 或显式指令)。 - D 组省约 57%(68.6 KB → 29.2 KB),代价是工具调用从 4 次涨到 11 次。这是拿往返次数换上下文空间:长会话里划算,一次性小任务里不划算。
- C 组顺带暴露了一个真 bug,见下。
装完之后,新窗口要多付多少(固定成本)
工具面本身就要吃上下文,这笔账不能只算省、不算花。复现:node tools/bench-mcp-cost.mjs。
| 项目 | 字节 | 什么时候付 |
|---|---|---|
| 14 个工具的完整描述 + inputSchema | 28,151 B | 每个新会话(非懒加载宿主:Claude Code / Gemini CLI 等) |
| 会话启动 hook 注入 | 4,801 B | 每个新会话(装了 hooks 的客户端) |
| 懒加载宿主只注入名字清单 | 451 B | 每个新会话(Qoder 这类) |
| 单个工具的 schema(首次用到才取) | 269 – 4,883 B | 每次 mcp_get(D 组实际付了 3,029 + 269 B) |
最贵的三个描述:ctx_execute 4,883 B、ctx_search 4,396 B、ctx_batch_execute 4,342 B —— 描述长是为了教模型什么时候别用它,但这几 KB 确实要你付。
回本算术(拿上面 A/B 的数据,单任务净省 ≈ 68,567 − 29,901 = 38.7 KB):
- 非懒加载宿主:固定成本 32,952 B → 约 0.85 个这种任务回本,也就是第一次大文件调查基本打平,之后才是净赚。
- 懒加载宿主(Qoder):固定成本 3,749 B → 约 0.1 个任务回本,第一次就净赚。
反过来也成立:如果这次会话里根本没有大输出调查,那 32 KB 就是纯亏。我们不假装"装了一定省"。
A 组基线只按文件正文 68,567 B 计算,没算 Read 的行号前缀(1758 行 × 约 5 B ≈ 8.8 KB,估算)和 Bash/Grep 的返回;算进去净省会更大。D 组的 29,901 B 是
ctx_stats自己报的 29.2 KB。
检索在规模化后会退化吗(150 源实测)
| 索引源数 | 精确标识符命中 | 单次批量延迟 | 内容库大小 |
|---|---|---|---|
| 1 | 3/3 | 5 ms | 4 KB |
| 10 | 3/3 | 4 ms | 4 KB |
| 50 | 3/3 | 2 ms | 348 KB |
| 150 | 3/3 | 2 ms | 832 KB |
150 源时一次批量查 4 个精确标识符:4/4(5,798 B);同样 150 源查 4 个自然语言问题:0/4(319 B,全是 No results found)。所以规模不伤召回,伤召回的是查询形状。
复现:node tools/bench-scale.mjs。
顺带记录两个基准测试本身的坑(第一版脚本就是这么测错的):
ctx_search有滚动窗口节流(默认 8 次/窗口,超过先裁剪结果、再直接 block)。串行单查会先撞上节流器 —— 我们第一版因此测出"150 源召回崩塌 0/3",改成一次批量queries数组后是 3/3。崩塌的是节流器,不是检索。- 判"命中"不能用
answer.includes(query):No results found会把查询原文回显,永远为真。必须按## <query>分节后看正文长度。
检索 vs ripgrep 头对头(同一把尺,三个口径)
语料是本仓库 16 个真实源文件(312 KB)。两边用同一个判分函数:术语出现 / 定义行出现(定义行由 rg 自动抽取)/ 定义文件出现。复现:node tools/bench-retrieval.mjs。
| 查询类型 | ripgrep(逐条,N 次往返) | 沙箱(一次批量) |
|---|---|---|
| 精确标识符 10 项 | 术语 10/10 · 定义行 10/10 · 定义文件 10/10 · 13,028 B · 10 次 | 术语 10/10 · 定义行 6/10 · 定义文件 6/10 · 17,229 B · 1 次 |
| 词形变化 6 项 | 术语 4/6 · 定义行 2/6 · 定义文件 3/6 · 4,107 B · 6 次 | 术语 6/6 · 定义行 2/6 · 定义文件 3/6 · 15,048 B · 1 次 |
| 自然语言 4 项 | 术语 0/4 · 0/4 · 0/4 · 0 B · 4 次 | 术语 4/4(回显) · 定义行 0/4 · 定义文件 1/4 · 12,661 B · 1 次 |
对我们不利的部分也留着:
- 在仓库里找确切标识符,ripgrep 更强。 它直接给定义行;BM25 会把"引用最多的文件"排在"定义所在文件"前面,所以沙箱定义行只有 6/10。别信"检索可以替代 grep"。
- 词形变化沙箱赢(6/6 vs 4/6):
ranking/throttling/caching这类变形 rg 抓不到(原文是 ranked / throttled / cached)。 - 自然语言两边都不行(沙箱 1/4)。它不是语义搜索,别当问答引擎用。
- 沙箱唯一的结构性优势是往返次数:10 个问题 1 次 vs 10 次。
这一组数据纠正了我先前两个错误结论,写在这里免得别人重犯:
- 单条查询时 8 个标识符 8/8 全命中(
node tools/bench-identifier-recall.mjs),批量 10 条的小节也齐全。之前报"6/10 召回崩塌"是我判分口径写错(要求返回里必须出现定义文件名)。 - 更早报的"150 源召回 0/3"根本不是规模问题,是
ctx_search的滚动窗口节流:60 秒窗口内第 3 次后每问只给 1 条、第 8 次直接拒。基准测试串行单查,测的是节流器。
大输出到底省在哪(130 KB 日志实测)
复现:node tools/bench-runtime.mjs。原始日志 130,703 B。
| 做法 | 进上下文 | 结果 |
|---|---|---|
只 print 派生结论(ctx_execute) |
738 B | 省 99.4%,答案正确(errors: 3) |
ctx_batch_execute + queries |
1,487 B | 命中 ERROR 行 |
| 全量 print(对照:2.7 KB / 27 KB / 80 KB) | 2,854 / 27,635 / 83,036 B | 原样返回,不截断 |
第三行是关键:沙箱不会替你截断,print 多少就进多少。所以省不省完全取决于你有没有把派生逻辑放进代码、只 print 答案 —— 工具描述里那句"700 KB 日志只花 3 KB"不是自动发生的,是你写代码的方式决定的。
健壮性:并发写与杀进程
同一脚本测:
- 并发:4 个 MCP 客户端同时各写 25 条(共 100 次
ctx_index)→ 0 错误、1.6 s 完成、抽查 4/4 可检索。SQLite 单写者在这个规模下没丢写。 - 杀进程:
hctx start后对代理进程kill -9→hctx status同时报not running与 stale daemon state;hctx start --restart恢复 healthy。 - 全部跑在临时
HYPERCONTEXT_HOME,不碰正在运行的实例。
压缩层:确实会折叠,但不是免费(2026-10-20 修正)
上一版这里写的是“纯透传、零收益”。那个结论是基准测错了泳道,旧数据保留如下:
tools/bench-compression.mjs每轮发max_tokens: 64;代理把max_tokens <= 200判为 side request,走透传、不碰 kernel 状态。所以“无工具 / system 2 B /requests=0”是这条泳道的设计行为,不是压缩失败。- 只把
max_tokens改成1024,代理就注入 6 个工具 + 11.4 KB system prompt,requests从 0 变成 31;但 mock 从不调用compress,所以仍然看不到折叠。
补上“会调用 compress 的 mock”后,折叠确实发生:
| 指标 | 结果 |
|---|---|
| 折叠 | m00001–m00034 → 1 block,tokensSaved=23,951 |
| 线上消息数 | 41 → 9(折叠后首轮),61 → 27(第 30 轮) |
| 30 轮直连总字节 | 2,757.8 KB |
| 30 轮代理 baseline | 3,388.3 KB(固定开销 630.4 KB,20.3 KB/请求) |
| 30 轮代理 + 折叠 | 2,479.6 KB |
| 折叠节省 | 908.7 KB |
| 相对直连净结果 | +278.3 KB(省 10.1%) |
关键边界:
- 固定开销 20.3 KB/请求(11.4 KB system prompt + 6 个工具等)。折叠后每轮约省 90.9 KB,折叠后至少还要跑 ~7 轮才回本;折叠后马上结束是净亏。
- 仪表盘的
netSaved是“折叠 token × 后续轮数 − summary”,没有减去注入开销,不能直接当净省。 - 协作式 mock 是上界:真实模型可能不调用
compress、折错范围或写更长的摘要。真实客户端长会话的 fold 频率与账单仍未验证;decompress的端到端还原也未在本次 A/B 中调用。
复现:
node tools/bench-compression-coop.mjs --json docs/bench/compression-coop.json
# COOP_TURNS=30 COOP_FOLD_TURN=20 COOP_FILLER_REPEAT=120
完整方法、字节账、回本点和未验证项见 docs/VERIFICATION.md。旧的 bench-compression.mjs 保留,用来复现 side-request 泳道的行为,不要再用它判断压缩层。
自动折叠:不依赖模型配合,也不再交固定的注入税
协作式压缩有一个前提:模型必须主动调用 compress。模型不调用,代理就只能每轮白注 20.3 KB 的提示和工具。billion-context 自带的 externalSummary.autoFold 可以绕开这个前提:代理自己选范围、调用一个独立的摘要模型,主模型完全不参与。再关掉 injectTool / injectNudge,注入开销会从 ~18.9 KB/请求降到 ~0.6 KB/请求。
同一套 36 对消息、50K 窗口、autoFoldTargetTokens=8192 的实测。两组都开 autoFold,只差注入开关:
| 模式 | 注入 system | 注入 tools | 折叠方式 | 摘要调用 |
|---|---|---|---|---|
| autoFold + 注入开 | 12,193 B | 6,684 B | 代理自动,73 → 9 条 | 16 次 / 316 KB 输入 |
| autoFold + 注入关 | 582 B | 2 B | 代理自动,73 → 9~11 条 | 15~16 次 / ~300 KB 输入 |
结论:压缩不再依赖模型是否听话,短会话也不再为 20 KB 的提示付费。代价转移到摘要模型:15~16 次调用、约 300 KB 输入(本次样本),以及相应延迟。用便宜/快的摘要模型、把 concurrency 调到 8、把 autoFoldTargetTokens 从 8192 提到 40000,通常能把单位成本压下来。
用打包后的代理和 hctx 生成的配置又跑了一次端到端:HTTP 200,主上游收到 11 条消息(原始 73 条),注入 system 582 B / tools 2 B,摘要 15 次 / 301 KB。配置链路和折叠链路都通了。
推荐直接用统一配置的 autofold 模式(编辑 ~/.hypercontext/config.json,然后 hctx start --restart):
{
  "compression": {
    "enabled": true,
    "mode": "autofold",
    "summary": {
      "baseUrl": "https://open.bigmodel.cn/api/paas/v4",
      "api": "openai",
      "apiKeyEnv": "SUMMARY_API_KEY",
      "model": "glm-4.9-flash",
      "autoFoldTargetTokens": 40000,
      "concurrency": 8
    }
  }
}
hctx start 会把这段合并进 ~/.hypercontext/data/compression/config.json:注册 hctx-summary provider、写入 compress.externalSummary,并设置 injectTool=false / injectNudge=false。摘要 key 通过环境变量 SUMMARY_API_KEY 提供;hctx doctor 会在变量缺失时警告。若摘要服务失败,代理按 upstream 的 fail-open 语义原样转发,不会卡住会话。
切回
compression.mode: "cooperative"时,控制面会把受管的hctx-summaryprovider 移除,并把compress.externalSummary.enabled/autoFold关掉、恢复injectTool/injectNudge。如果你自己改过externalSummary.targets且不再指向hctx-summary/*,控制面不会动它。
第二轮:把固定注入税改成按需开关,并给出真实盈亏
上一节解决的是「模型不配合」。这一轮解决的是「就算模型配合,短会话也不该交这笔税」,并把账算清楚。
冷启动门槛(compression.coldStartTokens,默认 32_000):原始请求小于这个 token 数时,压缩 prompt、工具、nudge、tags-only 提示、absorb/rules 五个面全部关闭;一旦跨过,该会话永久打开(原生 compact 之后也不会中途消失)。它通过托管环境变量 ACP_INJECT_AFTER_TOKENS 交给引擎,没有新增配置文件字段,也没有改 kernel。
真的 Claude Code 2.1.177 CLI,30 轮:
| 阈值 | 门槛 | 30 轮注入开销 | 折叠节省 | 净 |
|---|---|---|---|---|
8_000 |
第 1 个请求就打开 | 135,510 token | 0 | −135,510 |
32_000(默认) |
30 轮都没跨过 | 0 | 0 | 0(对话与直连逐字节一致) |
真实净计量(hctx meter / hctx status / MCP hc_status):
net        = gross saved − re-pay − summary output − summary input − injected overhead
break-even = ceil(overhead ÷ (gross saved ÷ post-fold requests))
口径全部是实测值:每请求注入开销按「出站 system+tools − 入站 system+tools」逐请求累加;摘要调用次数/输入输出 token/延迟来自真实摘要调用(token 是引擎 tokenizer 的估算,延迟是真实墙钟);折叠后请求数逐请求计数。线上跑通验证:3 个请求测出 3,548 token 注入税、净为负——固定税现在看得见了。配置 pricing.* 会多一行金额换算;没有测过任何 provider 的真实账单。
lean MCP 门面:hc_* + ctx_execute + ctx_search 保留,其余 ctx_* 收进一个调度器 ctx_more(需要时才展开)。实测 14 工具 28,502 B → 6 工具 11,330 B(−17,172 B,−60.2%),调度器用真实 context-mode 子进程验证可用。
统一会话身份:宿主原生 session id 现在把沙箱会话库和压缩层索引对起来,检索自动收窄到这一场对话(--all-sessions 退出收窄)。
真实摘要器(本地 Ollama + 真引擎 autoFold 链路):2025 次调用、输入 87,889114,264 token、真实延迟 47~236 s、8 条关键事实召回 75%~100%。负结果也记:本地 0.5B 模型在 token 账上是亏的(净 −61,496 ~ −100,967 token)——省 26,901 token 的历史要重读十万级 token。
真实客户端 e2e:真的 Claude Code CLI 30 轮 --print/--resume,30/30 成功、0 失败。Codex CLI / Qwen Code 本机未安装,没有它们的实测数据。
第三个真实客户端:OpenCode,以及「组合后为什么变弱」的答案(tools/bench-opencode-e2e.mjs,真的 opencode CLI 1.2.24,12 轮,同一 mock 上游三组对照):
| 运行方式 | 上游请求 | 宿主压缩次数 | 总请求字节 | 引擎折叠 |
|---|---|---|---|---|
| 直连 | 17 | 2 | 1,009,644 B | — |
| 经代理,协作式(注入开) | 26 | 6 | 1,626,740 B(+61%) | 0 次 |
| 经代理,autoFold(注入关) | 16 | 2 | 949,368 B(−6%) | 1 块,1 次摘要调用 |
OpenCode 自己在超窗前压缩(网线上可见:请求 82 KB → 30 KB)。而我们的注入算进宿主的上下文预算:协作式每请求注入约 4.5K token(25 个请求共 113,957),把宿主的压缩次数从 2 次逼到 6 次,自己却一次都没折。autoFold(代理自折叠 + 注入关)反过来:每请求只剩 584 B(合计 2,034 token,差 56 倍)、自己折了 1 块、宿主压缩次数回到 2 次、总字节比直连还少 6%。
对自带压缩的宿主,压缩层必须「赢下这一轮」才有价值:在宿主压缩之前先折,而且不能靠注入去催模型。顺手还修掉一个真 bug——宿主压掉的内容之前搜不到(字节在 CAS 里但消息行被裁了),现在联邦检索会扫「孤儿」内容,被宿主压掉的历史照样能搜到。
node tools/bench-claude-e2e.mjs --turns 30 --json docs/bench/claude-e2e.json
node tools/bench-opencode-e2e.mjs --turns 12 --json docs/bench/opencode-e2e.json
node tools/bench-summary-real.mjs --json docs/bench/summary-real.json
node tools/bench-mcp-cost.mjs --json docs/bench/mcp-cost.json
完整方法与未验证清单见 docs/VERIFICATION.md 第 8 节。
C 组的 bug:桌面宿主下沙箱读不到工作区
Qoder 从自己的安装目录(本机是 D:\user\software\Qoder CN)启动 MCP 子进程,而我们的控制面又用 process.cwd() 覆盖了 CONTEXT_MODE_PROJECT_DIR,于是 context-mode 的工作区包含策略把仓库里的每个文件都判成"工作区之外":
File access blocked: "E:\...\installer\HyperContextSetup.cs" resolves outside the project root (D:\user\software\Qoder CN).
已修复:新增 resolveWorkspaceDir(),显式声明的 CONTEXT_MODE_PROJECT_DIR 优先于启动 cwd(packages/runtime/src/engines.ts),CLI 也不再伪造显式值;tests/workspace-dir.test.ts 钉住这个优先级。
Qoder / WorkBuddy 用户还要手动一步:在 MCP 配置里写 "CONTEXT_MODE_PROJECT_DIR": "<项目绝对路径>" 并重载该服务,否则沙箱工具会像 C 组一样被拒。
{
  "mcpServers": {
    "hypercontext": {
      "command": "…\\node.exe",
      "args": ["…\\bin\\hctx.mjs", "mcp", "--client", "qoder-cn"],
      "env": {
        "HYPERCONTEXT_HOME": "C:\\Users\\你\\.hypercontext",
        "CONTEXT_MODE_PROJECT_DIR": "E:\\code\\你的项目"
      }
    }
  }
}
安装器生成的 mcp.json 里没有自动写死这个路径:Qoder 的 MCP 配置是用户级的,钉死单个仓库会让多项目场景出错。
功能总览
已实现
- 统一 MCP 端点:
hc_*+ctx_execute/ctx_search+ 一个ctx_more调度器,一次接入两层能力;lean 门面比 full 少 60.2% 的 schema 字节。 - 统一联邦搜索:
hc_search/hctx search同时检索:- 已索引的工具/网页/文件内容(FTS5)
- 会话事件、决策、错误(SQLite)
- 压缩摘要与压缩前的原始消息(billion-context
index.db) - 默认按当前会话收窄(两层用同一个宿主 session id),
--all-sessions退出收窄。
- 代理侧联邦搜索:
search_context在统一运行时下也会追加沙箱 FTS5 命中。 - 统一状态:
hctx status/hc_status同时显示沙箱节省、压缩块、代理请求、缓存命中率。 - 真实净计量:
hctx meter给出gross − repay − summary − 注入开销的净额和回本点,注入开销与摘要延迟都是实测值。 - 冷启动门槛:
compression.coldStartTokens让压缩面只在会话真的变大之后才出现,短会话不再交固定注入税。 - 三档预设:
hctx profile lean|balanced|maximum显式切换层级、记忆注入和 MCP 门面大小。 - 统一体检:
hctx doctor/hc_doctor检查 Node、引擎构建、代理、存储、更新通道和策略冲突。 - 34 客户端能力矩阵:native plugin、launcher、MCP、proxy fallback 一目了然;Qoder / WorkBuddy 的国内版与国际版分开管理。
- 自动 hooks:Claude Code、Gemini CLI、Qwen Code 已验证全 6 事件安装(安装前备份、可重复安装)。
- 三档路由:
strict/balanced(默认)/advisory,不再无脑硬拦 WebFetch。 - 双压缩协调:压缩代理启用时,会话记忆只注入最小提示,快照仍入库可搜。
- 自更新默认关闭:不会在后台悄悄覆盖 vendored 引擎。
- 统一存储根:配置、会话、CA、日志、缓存全部收进
~/.hypercontext。 - 优雅启停:启动探测端口冲突;停止走代理的 flush 流程,外部代理不误杀。
当前边界
- 自动 hooks 安装首版只开放 Claude Code / Gemini CLI / Qwen Code;其余客户端通过统一 MCP + 压缩代理覆盖,不会贸然写配置。
- Qoder / TRAE / CodeBuddy 走 billion-context 的 launcher(证书 MITM)路径,MCP 工件已生成;Qoder 尚未做真实端到端启动验证。
- 压缩层已在协作式 mock 下验证折叠与字节收益(30 轮 A/B,净省 10.1%);真实客户端长会话的 fold 频率、摘要质量和账单仍未验证。
autofold模式已用真实摘要模型(本地 Ollama)跑通:代理独立折叠、摘要延迟与 token 量实测、事实召回 75%~100%;但任何 provider 的真实账单都没测过,本地小模型在 token 账上是亏的。- Windows 安装器已覆盖 Codex、Claude、WorkBuddy 国内/国际、Qoder 国内/国际、DeepSeek Harness、Zcode;Qoder/WorkBuddy 的 MCP 需要在客户端里手动接入。
- 真实客户端 e2e 目前只有 Claude Code(30 轮、0 失败);Codex CLI / Qwen Code 本机未安装,没有实测数据。
- 代理路径下客户端每轮会多发一次 sidecar 请求,
--passthrough下同样出现,根因未深挖。 - 代理侧沙箱检索暂未按项目过滤,使用跨项目去重。
- 本项目尚未发布到 npm;当前以源码仓库方式使用。
快速开始
要求:Node.js >= 22.18(直接运行 TypeScript)或 Node 24 LTS。
git clone https://github.com/cv-superding/hypercontext-mode.git
cd hypercontext-mode

npm install
npm run setup:engines       # 安装两个引擎的依赖
npm run build:engines       # 构建 context-mode + billion-context

node bin/hctx.mjs init      # 创建 ~/.hypercontext
node bin/hctx.mjs setup --all
node bin/hctx.mjs start     # 启动压缩代理
node bin/hctx.mjs doctor    # 全部检查应通过
Windows 下可以用 bin\hctx.cmd,Git Bash 下用 bin/hctx:
bin\hctx.cmd init
bin\hctx.cmd setup --all
bin\hctx.cmd start
bin\hctx.cmd status
启动客户端:
bin\hctx.cmd launch claude-code
bin\hctx.cmd launch codex
bin\hctx.cmd launch qoder
安装
1. 前置条件
- Node.js >= 22.18(推荐 24 LTS)。本项目直接运行 TypeScript,依赖 Node 的类型剥离能力。
- npm >= 10(随 Node 分发)。
- git(拉取仓库;部分引擎功能也会调用 git)。
- 首次构建需要网络访问 npm registry。
- Windows / macOS / Linux 均可。Windows 建议 PowerShell 或 Git Bash。
检查版本:
node -v
npm -v
2. 拉取并安装
git clone https://github.com/cv-superding/hypercontext-mode.git
cd hypercontext-mode
npm install
npm run setup:engines
npm run build:engines
setup:engines 会在 engines/ 下分别安装两个上游引擎的依赖;build:engines 会构建 context-mode 的服务端/CLI/hooks 和 billion-context 的代理/插件 bundle。
依赖安装默认带
--ignore-scripts,避免上游 postinstall 在你不知情时修改客户端配置。控制面全部使用 Node 内置node:sqlite,不依赖原生 SQLite 编译。
如果只想先体验,不安装依赖也可以运行控制面命令(
hctx init、hctx clients、hctx config),但start、index、MCP 沙箱工具需要先完成引擎构建。
3. 可选:安装全局 hctx
npm link
hctx --help
npm link 会在 npm 全局 bin 目录创建一个 hctx 软链。若提示找不到命令,把 npm 全局 bin 目录加入 PATH:
- Windows:
%APPDATA%\npm - macOS/Linux:通常是
/usr/local/bin或~/.local/bin
也可以不安装全局命令,直接使用:
node bin/hctx.mjs <command>
4. 初始化
hctx init
这会创建:
~/.hypercontext/
  config.json
  data/
  state/
  bin/
自定义位置:
HYPERCONTEXT_HOME=/path/to/home hctx init
所有命令和生成的客户端工件都会记住该路径。
5. 验证安装
hctx doctor
hctx status
doctor 的期望结果:
[ok] Node.js
[ok] Unified config
[ok] Engines
[ok] Update channels
[ok] Storage
[ok] Store integrity
[ok] Compression proxy
如果代理尚未启动,会显示一条 warn,执行 hctx start 即可。
客户端接入
1. 生成工件(所有客户端)
hctx setup --all
会为 34 个客户端生成:
- 统一 MCP 配置片段:
~/.hypercontext/state/clients/<client>/mcp.json - 一键启动器:
~/.hypercontext/bin/<client>.cmd和<client>.sh
这一步不会修改任何客户端配置。
2. 查看能力矩阵
hctx clients
每一行显示:
client               hooks   mcp   compression    label
claude-code          yes     yes   plugin:claude  Claude Code
qoder-intl           -       yes   launcher:qoder Qoder 国际版
qoder-cn             -       yes   launcher:qoder Qoder 国内版
workbuddy-intl       -       yes   proxy-only     WorkBuddy 国际版
workbuddy-cn         -       yes   proxy-only     WorkBuddy 国内版
hooks:是否支持自动 hook 路由。mcp:是否可接入统一 MCP。compression:走 native plugin、launcher,还是只能手动指向代理。
3. Claude Code(推荐完整接入)
hctx setup claude-code --hooks
会:
- 把统一 MCP 配置写到
~/.hypercontext/state/clients/claude-code/mcp.json - 在
~/.claude/settings.json安装 PreToolUse、PostToolUse、PreCompact、UserPromptSubmit、SessionStart、Stop 六个 hooks - 修改前自动备份为
settings.json.bak - 所有 hook 命令都指向统一的
hook-wrapper,并内嵌HYPERCONTEXT_HOME
手动把 MCP 片段合并进你的 Claude Code 配置,或使用上游插件机制指向:
{
  "mcpServers": {
    "hypercontext": {
      "command": "node",
      "args": ["<repo>/bin/hctx.mjs", "mcp", "--client", "claude-code"],
      "env": { "HYPERCONTEXT_HOME": "<home>/.hypercontext" }
    }
  }
}
4. Gemini CLI / Qwen Code
hctx setup gemini-cli --hooks
hctx setup qwen-code --hooks
同样会安装全 6 事件并备份设置。写入位置分别是 Gemini / Qwen 的 settings.json。
5. Codex CLI
hctx setup codex --plugin
或者直接使用启动器:
hctx launch codex
Codex 的 MCP 片段同样在 ~/.hypercontext/state/clients/codex/mcp.json。
6. Qoder 国内版 / 国际版、WorkBuddy、TRAE、CodeBuddy
Qoder 两个版本共用 billion-context 的 launcher(证书 MITM),但工件分开生成:
hctx setup qoder-cn
hctx setup qoder-intl
hctx launch qoder
WorkBuddy 通过统一 MCP + 本地代理 base URL 接入:
hctx setup workbuddy-cn
hctx setup workbuddy-intl
TRAE / CodeBuddy:
hctx launch trae
hctx launch codebuddy
沙箱层使用统一 MCP,片段在:
~/.hypercontext/state/clients/qoder-intl/mcp.json
~/.hypercontext/state/clients/qoder-cn/mcp.json
~/.hypercontext/state/clients/workbuddy-intl/mcp.json
~/.hypercontext/state/clients/workbuddy-cn/mcp.json
把对应片段加入客户端的 MCP 配置即可。首次使用证书 MITM 时,客户端/系统可能要求信任本地 CA;按 launcher 的提示操作。
Qoder 的 launcher 路径已接好,但当前版本尚未在真实 Qoder 安装上做端到端验证。WorkBuddy 需要手动把生成的 MCP 工件加入客户端配置,并把模型 base URL 指向本地代理。遇到问题请先运行
hctx doctor并附上~/.hypercontext/state/logs/proxy.log。
7. 其他客户端
- 有 launcher 的客户端:
hctx launch <client>。 - 只有 MCP 的客户端:把
~/.hypercontext/state/clients/<client>/mcp.json合并进客户端配置。 - 只能配置 base URL 的客户端:
hctx start后,把模型 API base URL 指向:
http://127.0.0.1:8787/bili/<上游完整 URL>
或使用客户端自己的代理设置指向 127.0.0.1:8787。
日常使用
启动 / 停止 / 状态
hctx start                # 后台启动压缩代理
hctx start --foreground   # 前台运行,便于调试
hctx start --restart      # 重启
hctx stop                 # 优雅停止(不杀外部代理)
hctx status               # 统一状态
hctx status --json        # 机器可读
索引内容
hctx index ./src                 # 索引目录
hctx index ./docs/a.md           # 索引单个文件
hctx index https://...           # 由 context-mode 的抓取工具处理
索引时注意项目根:
hctx index ./notes.md --project "$PWD"
--project 决定内容库属于哪个项目;MCP 会话默认使用当前工作目录作为项目根。两者一致时,ctx_search 和 hc_search 才能命中同一份内容。
搜索
hctx search "refresh token"
hctx search "retry race" --scope sandbox
hctx search "compression" --scope compression
hctx search "needle" --all-projects
hctx search "needle" --session <session-id>
hctx search "needle" --all-sessions
hctx search "needle" --json
默认只搜当前项目;--all-projects 放宽到所有项目库。默认还会按当前会话收窄:沙箱层和压缩层用的是同一个宿主 session id,hctx search 会自动只返回这一场对话的内容;--all-sessions 退出收窄,--session <id> 指定别的会话。
统计
hctx stats
hctx stats --json
输出包括沙箱返回/避免字节、估算节省 token、压缩块数、压缩 token、代理请求与缓存命中率。
净计量(压缩层真实盈亏)
hctx meter
hctx meter --json
hctx meter 报的是净额,不是“折叠省了多少”:
net        = gross saved − re-pay − summary output − summary input − injected overhead
break-even = ceil(overhead ÷ (gross saved ÷ post-fold requests))
injected overhead是每个请求真实多出来的 system+tools token(实测,不是估算配置);summary input/output/calls/latency来自真实摘要调用(token 是引擎 tokenizer 的估算,延迟是真实墙钟);break-even是折叠之后还要跑多少个请求才回本。
没有配置 pricing.* 时只报 token;配置后多一行折算金额。本地没有测过任何 provider 的真实账单。
预设(profile)
hctx profile                 # 查看当前预设
hctx profile lean            # 只用沙箱层 + 完整记忆 + lean MCP
hctx profile balanced         # 两层都开(有摘要模型则 autofold)+ auto MCP
hctx profile maximum         # 两层都开 + 最小记忆注入 + full MCP
预设是显式命令,加载配置时不会自动改写字段。
客户端启动
hctx launch claude-code
hctx launch codex
hctx launch qoder
hctx launch opencode
也可以直接运行生成的启动器:
~/.hypercontext/bin/claude-code.cmd
~/.hypercontext/bin/qoder.cmd
配置
hctx config path                       # 配置文件路径
hctx config show                       # 当前配置
hctx config set compression.port 9000
hctx config set compression.coldStartTokens 48000   # 冷启动门槛
hctx config set sandbox.routing advisory
hctx config set sandbox.memoryInjection auto
hctx config set mcp.toolset lean
hctx config set profile maximum        # 预设(等同 hctx profile maximum)
统一 MCP 工具
在 context-mode 的 ctx_* 工具之外,新增:
| 工具 | 作用 |
|---|---|
hc_search |
一次检索沙箱索引、会话事件、压缩摘要和原始消息 |
hc_status |
统一健康、策略、节省、代理账本、净计量 |
hc_doctor |
统一诊断 |
hc_search 参数:
{
  "query": "refresh token",
  "scope": "all",
  "limit": 10,
  "all_projects": false,
  "session_id": "",
  "all_sessions": false
}
不传 session_id 时会自动用当前项目正在进行的会话收窄(两层共用同一个宿主 session id);all_sessions: true 退出收窄。
结果会标注:
[sandbox/content]:FTS5 索引内容[sandbox/session-event]:会话事件/决策[compression/compression-summary]:压缩摘要(带ref,可用于decompress)[compression/compression-message]:压缩前原始消息
门面大小:full vs lean
context-mode 子进程带 14 个工具,schema + 描述是每个新窗口的固定成本(实测 28,502 B)。lean 门面只留 hc_search / hc_status / hc_doctor / ctx_execute / ctx_search,其余 ctx_* 收进一个调度器:
{ "tool": "ctx_index", "arguments": { "path": "./src" } }
实测 lean 门面 11,330 B(少 17,172 B,−60.2%),隐藏的工具一个也没丢(调度器原样转发)。切换方式:
hctx config set mcp.toolset lean     # 持久
hctx mcp --toolset full               # 仅本次
auto(默认)只在 maximum 预设下等于 full。
沙箱子进程不可用时,hc_* 仍然可用;ctx_* 会返回明确的修复提示,不会拖垮整个 MCP。
手动 MCP 配置(通用)
{
  "mcpServers": {
    "hypercontext": {
      "command": "node",
      "args": ["/absolute/path/to/hypercontext-mode/bin/hctx.mjs", "mcp", "--client", "your-client"],
      "env": { "HYPERCONTEXT_HOME": "/home/you/.hypercontext" }
    }
  }
}
配置
默认配置 ~/.hypercontext/config.json:
{
  "version": 1,
  "profile": "balanced",
  "sandbox": {
    "enabled": true,
    "routing": "balanced",
    "memoryInjection": "auto",
    "autoIndexSessionEvents": true
  },
  "compression": {
    "enabled": true,
    "host": "127.0.0.1",
    "port": 8787,
    "mode": "cooperative",
    "coldStartTokens": 32000,
    "autoUpdate": false,
    "advisoryCheck": false,
    "releaseNotesCheck": false
  },
  "mcp": { "toolset": "auto" },
  "pricing": {
    "currency": "USD",
    "inputPerMTok": 0,
    "cachedInputPerMTok": 0,
    "outputPerMTok": 0,
    "summaryInputPerMTok": 0,
    "summaryOutputPerMTok": 0
  },
  "memory": { "retentionDays": 30 },
  "clients": {},
  "update": { "auto": false },
  "telemetry": { "enabled": false }
}
字段说明
| 字段 | 取值 | 说明 |
|---|---|---|
profile |
balanced / lean / maximum |
预设档位;用 hctx profile <name> 显式应用 |
sandbox.enabled |
boolean | 是否启用沙箱层 |
sandbox.routing |
strict / balanced / advisory |
工具路由严格度 |
sandbox.memoryInjection |
auto / full / minimal |
压缩开启时 auto = minimal |
compression.enabled |
boolean | 是否启用压缩代理 |
compression.host / port |
string / number | 代理监听地址,默认仅 loopback |
compression.mode |
cooperative / autofold |
cooperative 由模型调用 compress;autofold 由代理自动折叠,需配 compression.summary |
compression.summary |
object | autoFold 的独立摘要模型:baseUrl、api、apiKeyEnv / credentialRef、model、autoFoldTargetTokens、concurrency |
compression.coldStartTokens |
number | 冷启动门槛:原始请求小于这个 token 数时不注入压缩 prompt/工具/nudge;跨过后该会话永久打开。0 = 每个请求都注入 |
mcp.toolset |
auto / full / lean |
MCP 门面大小;auto 只在 maximum 预设下等于 full |
pricing.* |
number | 净计量的单价(每百万 token);全 0 时只报 token |
compression.autoUpdate |
boolean | 在统一运行时被忽略,始终关闭 |
update.auto |
boolean | 同上 |
clients.<id>.sandbox |
boolean | 客户端级沙箱开关 |
clients.<id>.compression |
boolean | 客户端级压缩开关 |
路由模式
| 模式 | WebFetch | curl/wget | inline HTTP | build 日志 |
|---|---|---|---|---|
strict |
拒绝并重定向 | 重定向到沙箱 | 重定向到沙箱 | 重定向到沙箱 |
balanced |
放行 + 一次提示 | 重定向到沙箱 | 重定向到沙箱 | 重定向到沙箱 |
advisory |
放行 | 放行 | 放行 | 放行 |
环境变量
| 变量 | 作用 |
|---|---|
HYPERCONTEXT_HOME |
整体数据根,默认 ~/.hypercontext |
HYPERCONTEXT_ROUTING_MODE |
覆盖路由模式(hooks 使用) |
HYPERCONTEXT_MEMORY_INJECTION |
覆盖记忆注入模式 |
CONTEXT_MODE_DIR |
context-mode 存储根(由 hctx 自动设置) |
ACP_INJECT_AFTER_TOKENS |
冷启动门槛的 token 数(由 compression.coldStartTokens 托管下发) |
ACP_AUTO_UPDATE |
billion-context 自更新(hctx 固定为 0) |
BILI_ADVISORY_CHECK |
安全公告检查(hctx 固定为 0) |
BILI_RELEASE_NOTES_CHECK |
版本公告检查(hctx 固定为 0) |
一般不需要手动设置;hctx 会把统一环境传给两个引擎。
数据目录与隐私
~/.hypercontext/
  config.json
  data/
    context-mode/
      sessions/<projectHash>.db       # 会话事件/快照
      content/<projectHash>.db        # FTS5 知识库
    compression/
      config.json                     # 合并受管更新字段
      sessions/index.db               # 压缩摘要/消息/块
    xdg/billion-context/ca/           # 按需生成的 MITM CA
  state/
    daemon.json
    logs/proxy.log
    logs/mcp-child.log
    clients/<id>/mcp.json
  bin/<client>.cmd|.sh
- 默认不启用遥测。
- 代理默认绑定
127.0.0.1,管理端点仅 loopback。 - 若绑定非 loopback 地址,
hctx status/doctor会明确警告:代理没有认证。 - hooks / 客户端配置只在显式
--apply/--hooks/--plugin时修改,并在修改前备份。 - 会话数据保留期由 context-mode / billion-context 各自策略控制;彻底清理可删除
~/.hypercontext(会丢历史,先备份)。
故障排查
Engine build missing
npm run setup:engines
npm run build:engines
代理启动失败或端口被占用
hctx status
hctx doctor
换端口:
hctx config set compression.port 9000
hctx start --restart
若端口上已经有健康的 billion-context 代理,hctx 会把它识别为 external 并复用;hctx stop 不会杀外部代理。
hctx 命令找不到
- 使用
node bin/hctx.mjs ...或bin/hctx.cmd ...。 - 或执行
npm link并把 npm 全局 bin 加入 PATH。
Node 版本过低
本项目需要 Node >= 22.18。升级 Node 后重新执行 npm install 与控制面命令即可。
hooks 没生效
- 只有 Claude Code / Gemini / Qwen 支持自动 hooks。
- 检查
hctx setup <client> --hooks的输出与备份文件。 - 检查客户端设置里的 hook 命令是否指向
packages/runtime/src/hook-wrapper.ts。 - 运行一次 hook 命令,确认退出码为 0;wrapper 设计为 fail-open,不会阻塞宿主。
Qoder / 证书 MITM
- 首次使用 launcher 可能需要信任本地 CA。
- 如果客户端不认代理,先运行
hctx doctor,再查看~/.hypercontext/state/logs/proxy.log。 - 也可只使用统一 MCP(沙箱层),压缩层稍后再接。
搜索没有结果
- 确认索引时的
--project与 MCP 会话的当前工作目录一致。 - 先
hctx search ... --all-projects排除项目作用域问题。 - 中文/短词查询会走 trigram/LIKE 回退;极短查询可能无结果。
SQLite 相关错误
- 本项目优先使用 Node 内置
node:sqlite,不需要原生编译。 - 如果看到锁/损坏提示,
hctx doctor会列出无法读取的库;备份后移走对应.db文件即可重建。
架构
详见 docs/ARCHITECTURE.md。核心设计:
- 入站沙箱层:工具输出不进上下文,索引后可检索。
- 历史压缩层:代理在模型请求前折叠历史,模型可
decompress恢复。 - 控制面:统一配置/策略/存储/搜索/状态/安装器。
- 统一 MCP:本进程提供
hc_*,把ctx_*转发给 context-mode 子进程。 - 冲突解决:压缩开启时最小记忆注入、单一工具面、单一更新通道、单一存储根。
与上游的关系
engines/context-mode:vendored 源码 + 3 个最小补丁(路由模式、最小记忆注入、关闭版本检查)。engines/billion-context:vendored 源码 + 1 个新增桥接模块和 1 处输出追加(HYPERCONTEXT=1时启用)。- 上游 commit、补丁清单、同步流程见 docs/UPSTREAM.md。
- 许可证与归属见 NOTICE.md 和 LICENSE。
开发与测试
npm run typecheck      # 控制面类型检查
npm test               # 联邦搜索/策略/路由/CLI/桥接测试
npm run build:engines  # 重建两个引擎
端到端冒烟(需要先构建引擎):
export HYPERCONTEXT_HOME="$PWD/.tmp-home"
node bin/hctx.mjs init
node bin/hctx.mjs start
node tests/mcp-smoke.mjs
node bin/hctx.mjs stop
测试全部使用临时目录;不会修改真实客户端配置。
效果基准(README「效果实测」一节的所有数字都出自这几条命令,全部只用临时目录):
node tools/bench-effect.mjs        --json docs/bench/effect.json      # 注入/引导/检索字节数
node tools/bench-mcp-cost.mjs      --json docs/bench/mcp-cost.json    # 装完后新窗口的固定成本
node tools/bench-scale.mjs         --json docs/bench/scale.json       # 1→150 源的召回与延迟
node tools/bench-retrieval.mjs     --json docs/bench/retrieval.json   # 与 ripgrep 头对头
node tools/bench-identifier-recall.mjs                               # 单个标识符为什么命中/不命中
node tools/bench-runtime.mjs       --json docs/bench/runtime.json     # 大输出、并发写、杀进程恢复
node tools/bench-compression.mjs      --json docs/bench/compression.json      # side-request 泳道复现(旧负面结果)
node tools/bench-compression-coop.mjs --json docs/bench/compression-coop.json # 协作式压缩 A/B(当前结论)
node tools/bench-autofold.mjs         --json docs/bench/autofold.json         # autoFold + 关闭注入的端到端
卸载
用安装器(推荐)
打开 HyperContext-Setup.exe,第三步会显示「检测到本机已安装」,点 卸载 / 还原客户端配置:先在日志里打印卸载计划,确认后再执行。
用命令行
hctx uninstall                     # 只打印计划,不动任何文件
hctx uninstall --yes               # 执行卸载
hctx uninstall --keep-data --yes   # 保留 ~/.hypercontext 数据,只回滚配置
hctx uninstall --json              # 机器可读
它会做四件事:
- 按
state/daemon.json优雅停止本地压缩代理。 - 从 Claude Code / Gemini CLI / Qwen Code 的
settings.json里只摘掉 hypercontext 自己的 hook 条目(按命令特征识别,你手动加的 hooks 原样保留;事件被清空后整条删除),改前写settings.json.hypercontext-uninstall.bak。 - 删除 Codex
config.toml里的[mcp_servers.hypercontext]段,其余段落不动,同样先备份。 - 删除
~/.hypercontext(配置、会话记忆、压缩索引、启动器工件)和%LOCALAPPDATA%\HyperContext(安装器下载的便携 Node / 源码副本 / 日志)。
不会自动处理的两类:Qoder / WorkBuddy / DeepSeek Harness 里由你手动添加的 MCP 条目(要在各客户端自己的设置中删除),以及源码仓库目录本身(rm -rf 即可;npm link 过就先 npm unlink -g hypercontext-mode)。
卸载后想再用:直接重跑安装器,或 hctx setup --all --apply。
许可证
本项目是合并作品:
engines/context-mode:Elastic License 2.0(ELv2),Copyright 2026 Mert Koseoğlu。engines/billion-context:MIT + 上游“产品署名”附加条款,Copyright (c) 2026 ranxianglei。- 新增控制面代码:按 ELv2 分发,以匹配合并作品。
合并作品整体不是 MIT。ELv2 适用于本仓库的重要部分:不得把本软件作为托管/管理服务向第三方提供其大部分功能,必须保留版权与许可证声明。详见 LICENSE、NOTICE.md 与 LICENSES/。
本地和内部使用是当前版本的目标场景;对外发布、托管服务或商业分发前请做单独的许可证审查。
路线图
- 统一 session identity:host session id ↔ 沙箱事件 ↔ 压缩会话。
- 自动 hooks 扩展到 Cursor、Copilot 系、Zed、Kiro、Antigravity、Kimi、OpenClaw。
- 代理侧沙箱检索按项目过滤。
- 压缩摘要携带沙箱引用(summary →
ctx://句柄)。 - Qoder / TRAE / CodeBuddy 原生插件适配。
- MCP HTTP transport 与多客户端复用。
- 合并回归矩阵(双引擎测试集)。
致谢
如果这个项目帮你省下了上下文和 token,欢迎 Star、提 Issue 或 PR。
Yorumlar (0)
Yorum birakmak icin giris yap.
Yorum birakSonuc bulunamadi