Dojao
Health Uyari
- License — License: Apache-2.0
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 6 GitHub stars
Code Gecti
- Code scan — Scanned 12 files during light audit, no dangerous patterns found
Permissions Gecti
- Permissions — No dangerous permissions requested
Bu listing icin henuz AI raporu yok.
One SQL across every data silo. A distributed MPP engine featuring disk-spill stability, native Python UDF, and AI Agent.
Dojao
打破数据库之间的隔阂 —— 面向 AI 时代的数据科学计算引擎


简介
Dojao 不是一个数据库,也不只是一个查询引擎。它是一个面向数据科学家和分析师的分布式计算引擎:
一条 SQL 里同时完成 跨源联邦查询、Python 向量化计算 与 AI 调用,不需要搬迁数据。
设计初衷只有一句话:让分析师用一条 SQL 打通散落在 MySQL / TiDB / Doris / PostgreSQL / SQL Server / Oracle /
Hive / ClickHouse / Excel 里的数据,让数据科学家不写一行 JVM 语言就能把 Python 统计量 / 小模型直接当 SQL 函数用。
配套:单进程即可跑通(Master + Worker 同进程),也能独立组集群(Master / Worker,Arrow Flight 传输);
内存不足时自动溢写磁盘;算子自观测,内置 Web 控制台看每一次查询的进度、内存与溢写。
为什么是 Dojao(核心差异化)
- 确定性优先于峰值性能 —— 大表 Join 场景下,「能跑完」比「跑得快」重要。
- 磁盘辅助是一等公民 —— 统一的溢写管线(P1 攒 + 溢写 / P1.5 归并 / P2 输出),
GroupBy / Window / SortMergeJoin / HashJoin 四个算子共享;溢写是「减量」的:
窗口rn=1溢写时即按组裁到 N 行,高基数 GROUP BY 用 K 路归并(峰值内存与 key 总数无关)。 - 跨源向量计算 —— 向量列(如 pgvector)映射为 Arrow
FixedSizeList<Float32>,cosine_similarity / l2_distance / inner_product一条 SQL 完成,数据不动。 - Python UDF + Arrow 零拷贝 —— 数据科学家用 NumPy / Polars 直接向量化执行,无跨语言逐行序列化;
协议(DFP)语言中立,任何会说 Arrow 的语言都能作为函数运行时。 - AI 原生集成 —— 内置流式 ReAct Agent:一条自然语言完成跨源取数、SQL 执行与图表展示;
工具按角色授权,DDL 执行前必须人工确认。 - 单进程即用 + 可集群部署 —— 默认
system.role = both一个进程同时跑 Master 与 Worker,也能拆成多机集群。 - 算子自观测 ——
AbstractMeasurableOperator+ 零注入统计,为 Web 控制台与可解释排障提供数据。
设计理念
分区即并行
Hash 分区算子恒定并行,无串行回退路径。全链路并行:Scan → Partition → Join → Sort 一条线,端到端无瓶颈。
数据不动,索引动
Arrow 列存储在内存中不动,只有行号在 Map / Sort 中重排;溢写时一次性重排输出。传输与溢写路径天然零拷贝。
算子统一管线
溢写完全复用 AbstractSpillableOperator:新增算子只需实现 Slot 接口 + P2 输出逻辑,即自动获得溢写能力。
内存模型:堆外跑数据,堆内管索引,预算只写一个总量,全节点共享一个根
- 数据在堆外(Arrow
RootAllocator),索引在堆内,二者是同一笔预算(query.slot.memory); - 用户只声明一个键
system.<role>.memory(节点内存总量),
heap / direct /query.slot.memory/query.direct.limit全部派生、能算能打印; - 全节点一个共享根分配器
NodeMemory:算子 / 连接器 / transport 统一记账,超限只让查询失败,不让节点被内核杀掉; - 读端背压把「内存不够」变成「读得慢一点」,让溢写追上来而非 OOM。
推导要点:
slot.memory是一笔混合账(堆内索引 + 堆外数据);堆只装索引 / 批量暂存 / 控制面,query.direct.limit为堆外使用封顶。
核心特性
| 特性 | 说明 |
|---|---|
| 联邦查询 | 一条 SQL 跨 MySQL / TiDB / Doris / PostgreSQL / SQL Server / Oracle / Hive / ClickHouse / Excel 读取,三段名 catalog.schema.table |
| Python UDF / UDAF | Arrow 批处理 + Arrow Flight(gRPC)通信;装饰器注册;协议语言中立(见 UDF_PROTOCOL.md) |
| 磁盘溢写 | 窗口 / 排序 / 聚合 / 排序归并 Join 自动溢写;减量式溢写,多盘轮转,盘满保护 |
| 向量计算 | pgvector 等向量列映射 FixedSizeList<Float32>,内置 cosine_similarity / l2_distance / inner_product |
| 列裁剪 + 谓词下推 | 三层列裁剪(保险丝 / 需求传播 / analyzer 绑定);连接器自报谓词下推能力,杜绝静默多读 |
| 动态资源管理 | 查询级资源上限 + 准入排队 + 动态并行度(按数据量估算切片数)+ 资源回收 |
| 分布式执行 | Exchange 算子(Arrow Flight)+ Fragment 计划 + Coordinator 调度;数据永不回 Master |
| 轻量部署 | Java 21 + 虚拟线程;发行包解压即用,单进程即可跑通 Master + Worker |
| Web 控制台 | 查询监控 / 任务看板 / 内存与磁盘溢写观测 / 血缘 DAG / SQL 自动补全 / 函数与 Catalog 管理 |
| 客户端 | 自带 CLI 与 JDBC 驱动;支持查询取消 |
| AI Agent | 内置流式 ReAct 推理:思考 / 工具调用 / 观察过程逐字展示;13 个内置工具(只读 SQL、DDL 人工确认、目录与表/函数元数据、集群/查询/算子诊断、日志、以及 CSV / Excel / HTML / PNG / PDF 多格式导出);render_chart 支持 11 种图表与混合双 Y 轴,结果集缓存(rs3 / last)免重算免回传;多轮会话持久化、按账号隔离、Skill 可裁剪工具集 |
界面展示
Dojao 内置了一个现代化、暗黑风格的 Web 控制台,用于实时观测执行状态、监控底层资源以及进行 AI 智能问数。
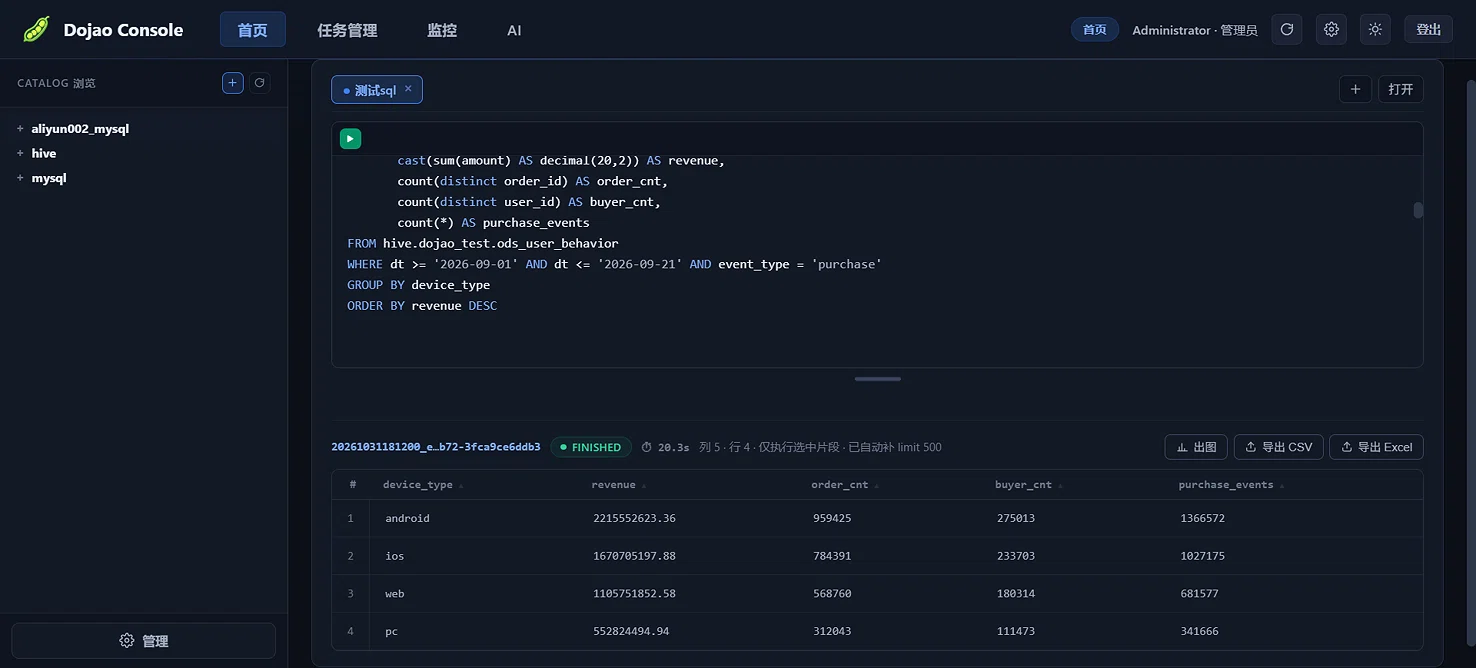
1. 交互式 SQL 编辑器
支持跨源查询(如左侧的 hive 与 mysql_catalog),自动补全、高亮语法、查询耗时与结果实时反馈,并支持一键导出 CSV / Excel / 绘制图表。
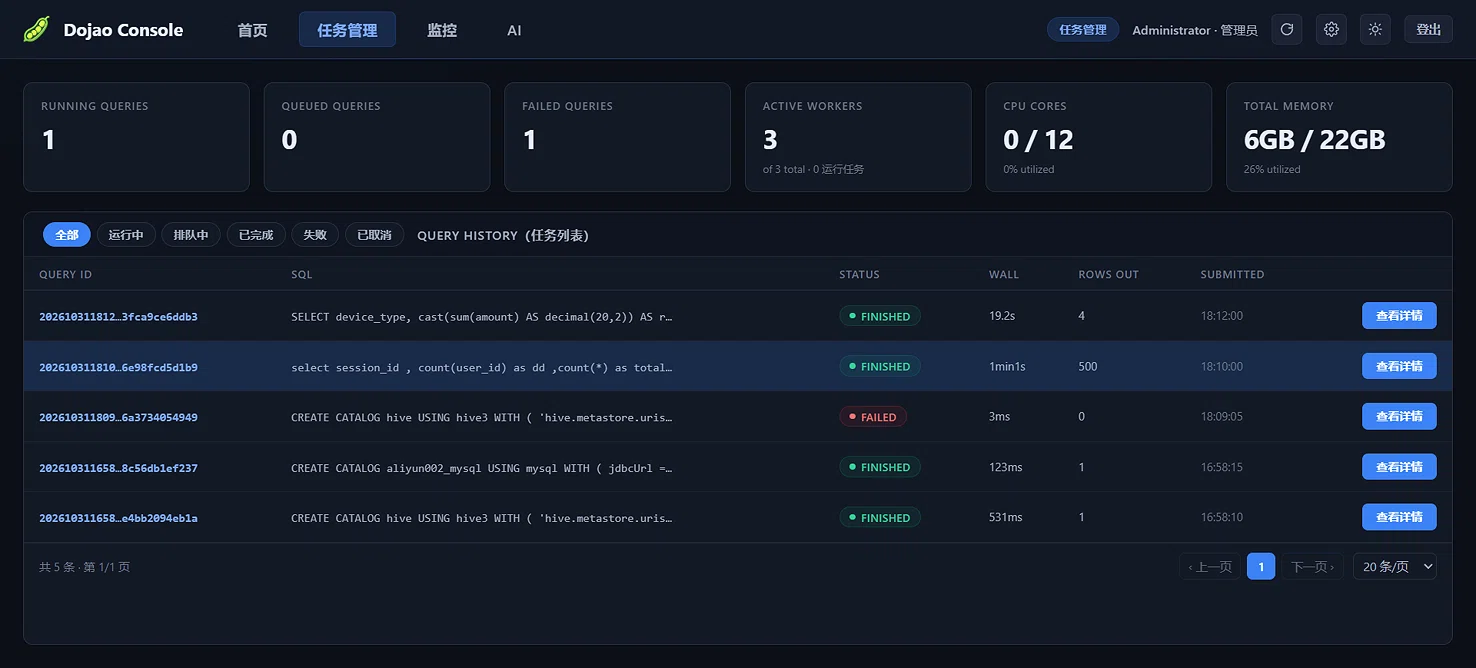
2. 任务管理与执行历史
实时查看集群运行状态,追踪每条 Query 的执行耗时、返回行数、状态(已完成 / 失败)以及执行详情。
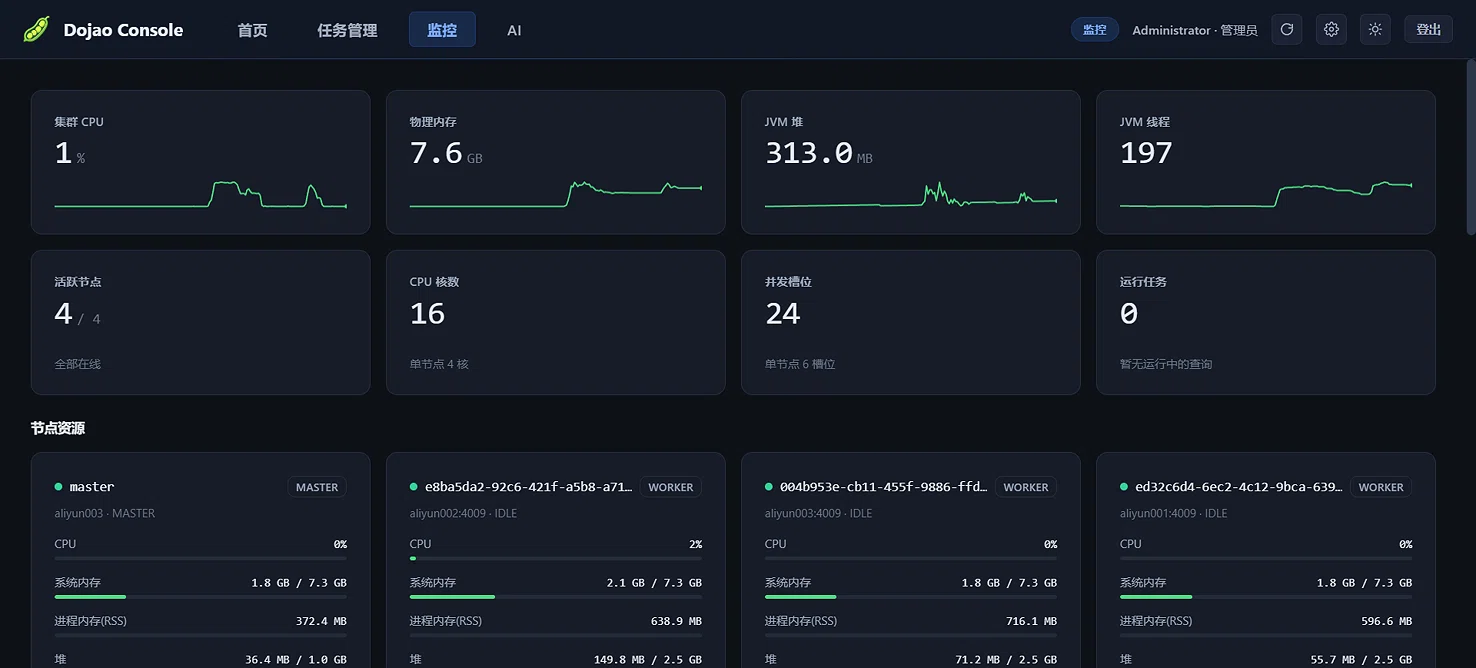
3. 集群与节点资源监控
直观展示集群的 CPU、物理内存、JVM 堆与线程。内存不足时的磁盘溢写过程全透明可见,彻底告别 OOM 黑盒。
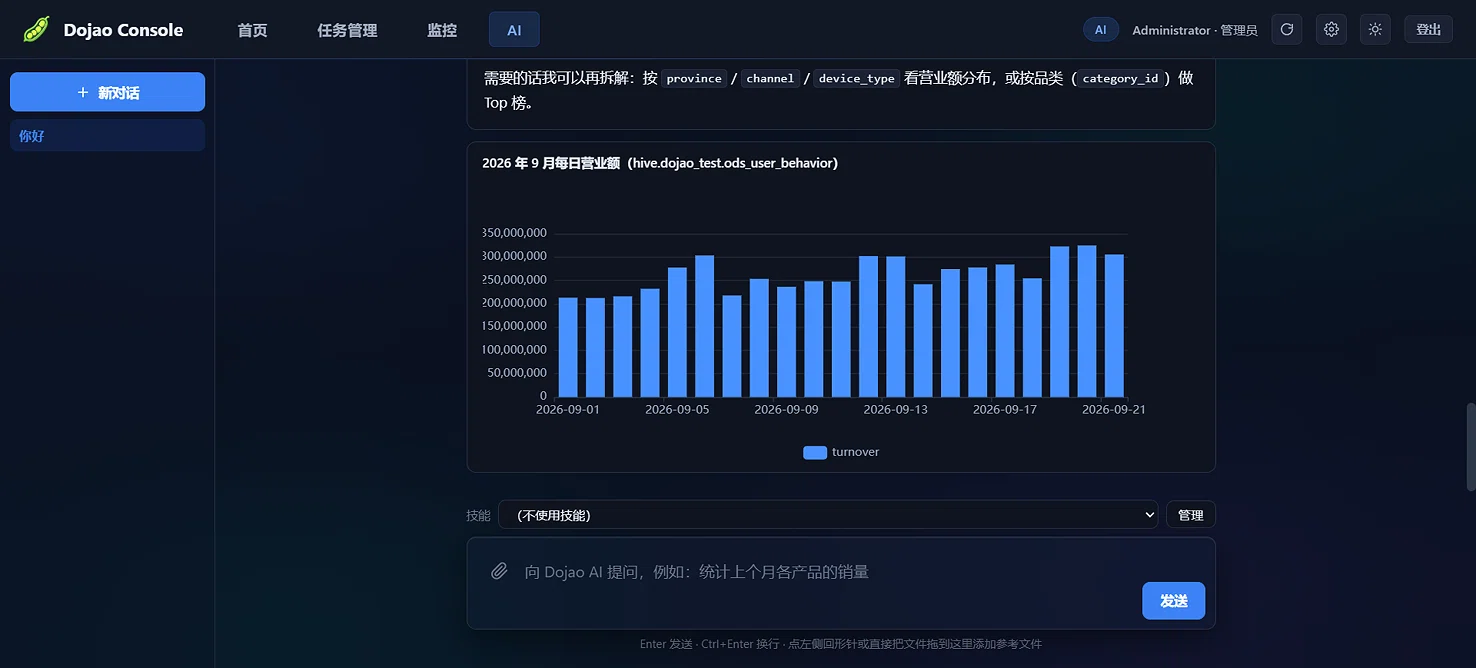
4. 原生 AI Agent(智能问数)
内置流式 ReAct Agent。你只需用自然语言提问(如“帮我分析每日营业额”),AI 将自动规划、生成并执行 SQL,最终直接渲染出可视化图表。
架构总览(模块)
| 模块 | 职责 |
|---|---|
dojao-grammar |
ANTLR 语法、语义分析(SemanticAnalyzer)、逻辑计划、优化器(列裁剪 / 谓词下推) |
dojao-core |
算子、表达式引擎、标量/聚合函数、执行、内存模型、溢写管线 |
dojao-spi |
连接器 SPI(ConnectorFactory / DojaoConnector / ScanReader / Split)+ 函数 SPI |
dojao-common |
Page 与 Arrow 公共类型 |
dojao-metastore |
SQLite 元数据(Catalog 注册 + 持久化函数) |
dojao-server |
Master / Worker / Arrow Flight 传输 / Exchange / 作业管理与调度 |
connector/* |
内置连接器:mysql / tidb / doris / postgresql / sqlserver / oracle / hive(Hive2·Hive3)/ clickhouse / excel |
dojao-ui |
Web 控制台(静态资源 + 监控 API) |
dojao-cli |
命令行客户端 |
dojao-jdbc |
JDBC 驱动 |
dojao-ai |
ReAct Agent 内核:流式推理、工具调用、多轮上下文(LangChain4j + OpenAI 兼容端点) |
python/ |
Python sidecar 参考实现(dojao_udf) |
快速开始
构建
git clone https://github.com/Jason1008Jia/Dojao.git
cd dojao
mvn clean package -DskipTests
需要 JDK 21 与 Maven 3.9+。
启动(单机 / 分布式通用)
从 GitHub Releases 下载自包含发行包 dojao-0.1.0.tar.gz,
解压即用,内含 bin/(启动脚本)、conf/dojao.conf(本机配置)、lib/(引擎 + 内置连接器)、python/(sidecar 参考实现)。默认 system.role = both(同机起 Master + Worker)。
tar -xzf dojao-0.1.0.tar.gz
cd dojao-0.1.0/dojao
./bin/dojao                 # 按 conf 里的 system.role 启动;也可 ./bin/dojao master|worker|both
分布式部署(A = Master,B / C = Worker):每台机器各自编辑本机 conf/dojao.conf ——
A 机写 system.role = both(或 master)与 system.master.host = 0.0.0.0;
B / C 机写 system.role = worker、system.master.host = <A 机 IP>、system.worker.host = <本机 IP>。
各机分别启动 ./bin/dojao,Worker 会主动注册到 Master,无需节点清单;扩容只需在新机写好角色与
Master 地址后启动。完整步骤见 docs/deploy-linux.md。
连接
# CLI(Arrow Flight,默认端口 6530)
./bin/dojao-cli
# Web 控制台(默认端口 2380)
open http://localhost:2380
第一条联邦查询
-- 注册数据源(一次)
CREATE CATALOG hive    USING hive       WITH ('catalog.hive.metastore.uris' = 'thrift://localhost:9083');
CREATE CATALOG mydb    USING mysql      WITH ('catalog.mysql.jdbcUrl' = 'jdbc:mysql://localhost:3306/dga',
                                              'catalog.mysql.username' = 'root', 'catalog.mysql.password' = '***');

-- Hive 埋点明细 ⋈ MySQL 用户维表,只读真正用到的列
SELECT u.city, COUNT(*) AS c, ROUND(SUM(b.amount), 2) AS gmv
FROM hive.dojao_test.ods_user_behavior b
JOIN mydb.dga.users u ON b.user_id = u.user_id
WHERE b.dt BETWEEN '2026-09-01' AND '2026-09-30' AND b.event_type = 'pay'
GROUP BY u.city
ORDER BY gmv DESC LIMIT 20;
联邦查询与连接器
内置连接器覆盖主流数据源,能力对齐(元数据探查 + 并行切片 + 列裁剪 + 可选谓词下推):
关系型 / OLTP(谓词型切片:主键或行范围,天然可并行)
| 连接器 | type() |
说明 |
|---|---|---|
| MySQL | mysql |
主键范围并行切片;支持写入 / CTAS / OVERWRITE |
| TiDB | tidb |
MySQL 线路协议与 information_schema;EXPLAIN estRows 行数估算;支持写入 / CTAS / OVERWRITE |
| PostgreSQL | postgresql |
ctid 范围切片;pgvector 向量列 → FixedSizeList<Float32> |
| SQL Server | sqlserver |
主键 / 数值列范围 / OFFSET-FETCH 三级切片;tinyint(0..255)读成 SMALLINT;支持写入 / CTAS / OVERWRITE |
| Oracle | oracle |
主键 / 整数 NUMBER 列范围 / OFFSET-FETCH 三级切片;双引号标识符(字典名大小写不敏感解析);无精度 NUMBER CAST 成 NUMBER(38,10)、FLOAT 提升为 BINARY_DOUBLE;支持写入 / CTAS / OVERWRITE |
分析型 / OLAP(载荷型切片:文件 / stripe / 分片)
| 连接器 | type() |
说明 |
|---|---|---|
| Hive | hive(Hive2 / Hive3) |
ORC / Parquet / Text / ACID;HDFS 文件分组切片 |
| ClickHouse | clickhouse |
列存 OLAP;MergeTree 建表与原子覆盖写 |
| Doris | doris |
MySQL 协议接入 FE(9030);DISTRIBUTED BY 建表、REPLACE WITH TABLE 原子覆盖 |
本地文件(单分区读取,零第三方依赖)
| 连接器 | type() |
说明 |
|---|---|---|
| Excel | excel |
目录下每个 .xlsx / .xlsm 是一个 schema、每张工作表是一个表;恒定单分区(ZIP + 一条 XML 流,切分只会重复解压);共享字符串 / 富文本、日期格式与 1904 日期系统、header=false |
后续迭代(非关系型 / 非 JDBC 式数据源)
| 连接器 | 说明 |
|---|---|
| Kafka | 消息流接入(topic / partition 即切片) |
| Elasticsearch | 搜索引擎 / 倒排索引 |
| MongoDB | 文档型数据库 |
| Iceberg | 表格式;元数据驱动的分区裁剪 |
连接器 SPI 不绑定 JDBC —— 契约只有
planSplits → openSplit → ScanReader(见开发指引),
所以消息流 / 搜索 / 文档型数据源与关系型走同一套接入方式;示例连接器csvdir(把本地目录当数据库读)
已经证明引擎不关心数据源底层是什么。
- 对接长尾数据源不改 Dojao 一行代码:依赖
dojao-spi(provided)实现接口,打成 jar 丢进
部署目录的lib/connectors/,每个 jar 独立类加载器。 - 开发指引:
docs/custom-connector.md;
可运行示例(约 400 行、零第三方依赖):examples/dojao-connector-example/(把本地目录当数据库读的csvdir)。
连接器契约里最该记住的一条:
columns为空 = 读所有列(不是零列);
谓词下推能力必须显式声明,宁可少一次优化,也不静默多读一行。详见开发指引 §4。
Python UDF(DFP 协议)
数据科学家把 Python 统计量 / 小模型注册成 SQL 函数,不写一行 JVM 语言、不打 jar:
CREATE FUNCTION stddev_py WITH (
    type        = 'python',
    code_path   = '/opt/dojao/python/dojao_udf/examples/my_fns.py',
    class_name  = 'my_fns.stddev');

SELECT product_id, stddev_py(amount) AS sd
FROM hive.dojao_test.ods_user_behavior
WHERE dt BETWEEN '2026-09-01' AND '2026-09-30'
GROUP BY product_id;
协议是语言中立的:函数逻辑跑在独立 sidecar 进程里,通过 Arrow Flight(数据面 doExchange /
控制面 doAction)与引擎通信,类型系统直接用 Arrow schema,不引入任何语言专属类型名。
Python 只是官方参考实现,Rust / Go / R / Julia / Node / C++ … 均可自行实现,引擎零改动。
- 权威协议规范:
UDF_PROTOCOL.md - Python sidecar:
python/README.md - 隔离性:sidecar 崩了只崩那一个进程,可限资源、超时、重启 —— 这是进程内 Java UDF 给不了的。
内存与溢写模型(一页速览)
# 只需声明一个总量,其余全派生
system.master.memory = 2g      # 堆 1g + 堆外 1g
system.worker.memory = 5g      # 堆 2.5g + 堆外 2.5g
query.spill.ratio    = 0.8     # 算子内存达 slot.memory × ratio 触发溢写
query.spill.dir      = /data1/dojao-spill,/data2/dojao-spill   # ★别放 /tmp(tmpfs = 内存盘)
- 不要配大堆:堆内只装索引 / 批量暂存 / 控制面,但高基数分组会把它吃到 GB 级 ——
堆大不会更快,只会 Full GC 更久、更容易占满物理内存不还。 - 溢写目录别指向
/tmp:很多 Linux 上/tmp是 tmpfs,会变成「一边溢写一边吃内存」。 - 盘使用率上限
query.spill.disk.maxUsage,写满换盘,全部候选盘超限则报错而非静默写爆节点。 - 无 LIMIT 的全局
ORDER BY默认拒绝(query.sort.topSpillPolicy = error),提示你加 LIMIT。
分布式执行
- Exchange 算子:基于 Arrow Flight 的 Worker↔Worker 数据交换,写入侧并行、数据永不回 Master。
- Fragment 计划:逻辑计划切成分片,Coordinator 按资源调度到 Worker。
- 动态并行度:按
getTableStats估算的字节数决定切片数,query.parallelism.bytesPerSlot可调。 - 闸门与背压:
query.memory.highWatermark / lowWatermark在堆外用量越线时对读端做有界等待,把 OOM 变成减速。 - 可观测:查询快照(
QuerySnapshot/OperatorSnapshot)、内存与溢写遥测、查询取消。
客户端与工具
| 入口 | 说明 |
|---|---|
| Web 控制台 | 端口 system.ui.port(默认 2380):SQL 编辑器(自动补全 / 高亮)、任务看板与分页历史、查询监控(进度 / 内存 / 磁盘 / 溢写)、血缘 DAG、函数与 Catalog 管理、深浅主题 |
| CLI | dojao-cli,多语句、结果格式化 |
| JDBC | dojao-jdbc,标准 Connection / Statement / PreparedStatement / ResultSet,可接 BI 工具 |
与 Trino / Spark 的定位
Dojao 的护城河是设计上的取舍,不是性能上的堆料。 它主动站在 Trino / Spark 最难受的区间
(小内存 + 跨源 + 溢写必发 + 不可失败)当正解:
- Trino 的溢写官方标注为 legacy,被迫溢写时可能 "orders of magnitude" 变慢、且不保证成功;
- Spark 的 shuffle spill 成熟稳健,但保量落盘(不改变数据规模);
- Dojao 的溢写是 减量 的 —— 6.8KW 行窗口去重会先在溢写期塌缩成「每分区 1 行」,内存线对它不是悬崖。
边界也很清楚:真要 20+ 节点、纯内存 PB 级、拼绝对吞吐,Trino / Spark 更合适。
本仓提供三引擎对等压测方法(同硬件、同数据、同 SQL)与「溢写线」判据:docs/benchmark-dojao-trino-spark.md。
扩展:自定义连接器
内置连接器只覆盖常用数据源;对接长尾数据源不需要改 Dojao 任何一行代码——
依赖 dojao-spi(provided)实现接口,打成 jar 丢进部署目录的 lib/connectors/ 即可。
- 开发指引:
docs/custom-connector.md - 可运行示例(约 400 行、零第三方依赖):
examples/dojao-connector-example/
文档索引
| 文档 | 内容 |
|---|---|
UDF_PROTOCOL.md |
DFP 外挂函数协议(语言中立,权威规范) |
docs/custom-connector.md |
自定义连接器开发指引 |
docs/deploy-linux.md |
Linux 部署与集群化 |
docs/benchmark-dojao-trino-spark.md |
三引擎对等压测方法、SQL 阶梯、定位边界 |
License
Yorumlar (0)
Yorum birakmak icin giris yap.
Yorum birakSonuc bulunamadi