claude-radar
Health Uyari
- License — License: NOASSERTION
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 8 GitHub stars
Code Basarisiz
- os.homedir — User home directory access in skills/analyze/scripts/compute-baselines.mjs
- process.env — Environment variable access in skills/analyze/scripts/compute-baselines.mjs
- os.homedir — User home directory access in skills/analyze/scripts/list-projects.mjs
- process.env — Environment variable access in skills/analyze/scripts/list-projects.mjs
- exec() — Shell command execution in skills/analyze/scripts/parse-project.mjs
- network request — Outbound network request in skills/analyze/scripts/parse-project.mjs
- execSync — Synchronous shell command execution in skills/analyze/scripts/render-report.mjs
- fs.rmSync — Destructive file system operation in skills/analyze/scripts/render-report.mjs
- os.homedir — User home directory access in skills/analyze/scripts/render-report.mjs
- process.env — Environment variable access in skills/analyze/scripts/render-report.mjs
- fs.rmSync — Destructive file system operation in test/run.mjs
- process.env — Environment variable access in test/run.mjs
Permissions Gecti
- Permissions — No dangerous permissions requested
Bu listing icin henuz AI raporu yok.
A Claude Code plugin that grades your collaboration with AI across 9 dimensions in 3 categories — with a free-form AI diagnosis and at-least-5 pastable prompt rewrites. 100% local single-file dashboard. · 一款评估你和 AI 协作质量的 Claude Code 插件 —— 9 维评分、AI 撰写诊断、可粘贴改进 prompt,全程本地。
Claude Radar(由 Fable 5.1 升级)
一款 Claude Code 插件,读取你的项目对话记录,评估你和 AI 协作的质量。 从「沟通力 / 工程力 / 成效」三个层面、9 个维度打分,输出 AI 自由撰写的诊断、至少 5 条可直接粘贴的 prompt 改写,以及一个专业可读的 HTML dashboard。v1.3 由 Claude Fable 5.1 为「长自主回合」时代重新校准 —— 它看得见你搭的验证闭环,也第一次量化你的放手力。全程本地。
🌏 English · 📖 方法论 · 🖥 在线预览 · ⚖️ 协议
English summary: A Claude Code plugin that reads your project conversation records and grades how you collaborate with AI across 9 dimensions in 3 categories. Returns an AI-written diagnosis, at-least-5 pastable improvement prompts, and a professional, readable HTML dashboard. v1.3 is recalibrated by Claude Fable 5.1 for the era of long autonomous turns — it sees the verification loop you built and measures your autonomy for the first time. 100% local. Full English docs → README_en.md
核心特性
🎯 评估你真实的项目对话记录,而且读得懂最新的 Claude Code。 大多数"AI 协作分析"工具用合成提示考你,Claude Radar 分析你这个月真的和 Claude 聊过的内容 —— 每条 directing / correcting / confirming 消息、每次工具调用,以及 2.1.2xx 这一代才开始写进记录的东西:回合时长、每回合的模型与 effort、权限模式、手动还是自动压缩、截图、/effort /model /compact。
🔁 看得见你搭的验证闭环,不用你开口。 测试与构建运行、reviewer subagent、浏览器与 UI 检查、hooks —— 只要闭环真的合上了,就计入鉴定术(Proof Check),哪怕你从没说过"测一下"。编辑完就散场的会话,才是负向证据。
🚀 第一次量化「放手力」。 长回合占比、打断率、排队引导、后台 agent、离开回顾。敢让一个回合自己跑上几个小时是这一代的能力,不是失控;把新指令排进队列而不是打断它,同样算数。
💬 AI 给你写诊断信,而不是只给分数。 9 个分数之外,你会拿到一份 150 字的协作画像(描述你具体的协作方式)、一段"强项 + 瓶颈"核心诊断、维度交叉解读,每条结论都引用真实证据。
📋 每条建议都带可粘贴 prompt,也不会讲你已经在做的事。 不讲"要多思考"这种空话。5–7 条改进建议每条都附一段下次会话可以直接复制粘贴的具体话术,外加预期分数影响和取舍说明;招式库还会先看你是不是已经在做 —— 已经跑了一百多次 review agent 的人,不会再被建议"雇一个 reviewer"。
⚖️ 按项目类型公平评分。 3 条消息修完的 bug 不会和 50 个 session 的功能开发用同一把尺子。Claude Radar 自动归类(一次性 / 功能开发 / 长期 / 学习),按类别套用不同的权重和 N/A 规则。密度驱动的 confidence 让短但信号密集的会话不会被无理由打折。
🛠 专门评估你怎么用平台,不只是怎么说话。 工程力类目衡量你对 Skill、MCP、Subagent、Workflow 编排、并行分发、后台任务、异步派发、effort 分级、自定义 agent 类型、CLAUDE.md、.mcp.json、hooks、Plan 模式、自定义命令的使用 —— 大多数用户都没用足的杠杆。不用高级工具不扣分,用了但用不好(retry loop、Plan 进了又抛)才扣分。
📦 建议不止是话术,还是可安装的资产。 setup 类建议直接附上文件内容 —— CLAUDE.md 章节、hook 配置、.mcp.json 条目、自定义命令 —— 出自一个开源的、按触发条件匹配的招式库(data/playbook.json),再用你的真实会话证据个性化。
📈 记录你的进步。 报告本地归档;每次重跑都会显示距上次体检的分数变化,并自动检测哪些历史建议真的被采纳了(CLAUDE.md 建了没、hooks 配了没、/effort 用起来没、验证闭环合上了没、手动压缩养成了没)。
🔒 全本地,零数据上传。 只读访问本地项目对话记录,不发任何网络请求、无 API key、无云端。原生中英双语报告。输出一个专业可读的 HTML dashboard。
English highlights:
- 🎯 Reads your real project conversation records — including everything the latest Claude Code writes
- 🔁 Credits the verification loop you built, even if you never asked for it out loud
- 🚀 Measures autonomy — long turns, queued steering, background agents
- 💬 AI writes a coaching note with evidence — not just scores
- 📋 Every suggestion is a pastable prompt + expected impact — and never suggests what you already do
- ⚖️ Project-aware fairness — a bugfix isn't compared to a big feature
- 🛠 Evaluates platform leverage (Skill / MCP / Subagent / effort control / async delegation / CLAUDE.md / Plan mode)
- 🔒 100% local, zero telemetry, bilingual, professional, readable HTML dashboard
Full English version → README_en.md
v1.3 更新了什么
v1.3 由 Claude Fable 5.1 为自己的时代重新校准 —— 长自主回合、后台 agent、几十万 token 的上下文。v1.2 的尺子量的是"对话式结对编程",v1.3 量的是你现在真实的用法。
看得见你搭的验证闭环。 以前你得开口说"测一下"才拿得到鉴定术的分。现在测试与构建运行、reviewer subagent、浏览器与 UI 检查、hooks 都算 —— 只要闭环真的合上了。作者自己的项目里,195 次 Agent 调用中 157 次是 review / verify 型,鉴定术基线却只有 59 分,旧招式库还在建议"雇一个 reviewer subagent"。这类误判没有了。
手动压缩是好习惯,不是扣分项。 到 ~39 万 token 先写一份交接记录再 /compact,是长上下文时代该有的节奏。v1.2 把每一次压缩都当成"上下文失控"扣分 —— 作者项目里 40 次压缩全部是手动的(整机抽样的 50 次也全部手动),节奏感还是为此丢了 12 分。现在手动压缩加分,只有自动压缩才扣分。
第一次量化「放手力」。 长回合占比、打断率、排队引导、后台 agent、离开回顾 —— 你敢不敢让一个回合自己跑上几个小时,以及你是打断它还是把下一条指令排进队列,现在都是可见信号。作者项目里约 10% 的消息是打断、17% 是排队引导,这些行为在 v1.2 的视野里根本不存在。
读懂最新的 Claude Code。 解析器跟上了 2.1.2xx 写进记录里的一切:回合时长、手动 / 自动压缩、每回合的模型与 effort、权限模式、排队消息、打断、离开回顾、截图、同伴 agent 消息,以及 /effort /model /compact 这些以前被当成内置命令直接丢掉的斜杠命令。大文件改成流式读取,几十 MB 的会话不再被跳过。
建议不再讲你已经在做的事。 招式库加上了"assistant 侧已经在做"的否定条件,同时新增 9 条 Fable 5.1 时代的招式:按任务分级 effort、带交接记录的手动压缩、异步派发、让长回合跑完、给原因而不是给步骤、把进度声明落到工具结果上、用截图当证据、给 CLAUDE.md 去处方化、里程碑级的 verifier subagent。
报告新增「运行环境与放手力」附录:主力模型、effort 分布、auto 模式占比、长回合占比、打断与排队引导次数、验证闭环统计。facts schema 升到 2.2、报告 JSON 升到 2.3,已归档的旧报告照常渲染。
v1.2 更新了什么
报告页面由 Claude (Fable 5) 从头重塑 —— 从指标仪表盘变成一份「体检报告」:
- 全新报告 UI —— 暖色编辑排版、首屏 9 维雷达图、明暗双主题、更讲究的字体层次。
- 重点内容前置 —— report schema 升级到 2.2,新增结构化的
highlights(最强项/最大瓶颈成为一等数据)和isKeyAction标记,重点评价和前 1-2 条重点建议直接领衔整页,不再淹没在等权重的卡片里。 - 完全向后兼容 —— 已归档的 2.1 报告在新模板下照常渲染。
评分管线(确定性基线、playbook 触发、纵向追踪)保持不变。
报告里有什么
运行 /claude-radar,你会得到一个单文件 HTML 报告,按「教练体检报告」的思路排布 —— 最重要的内容永远在最前面:
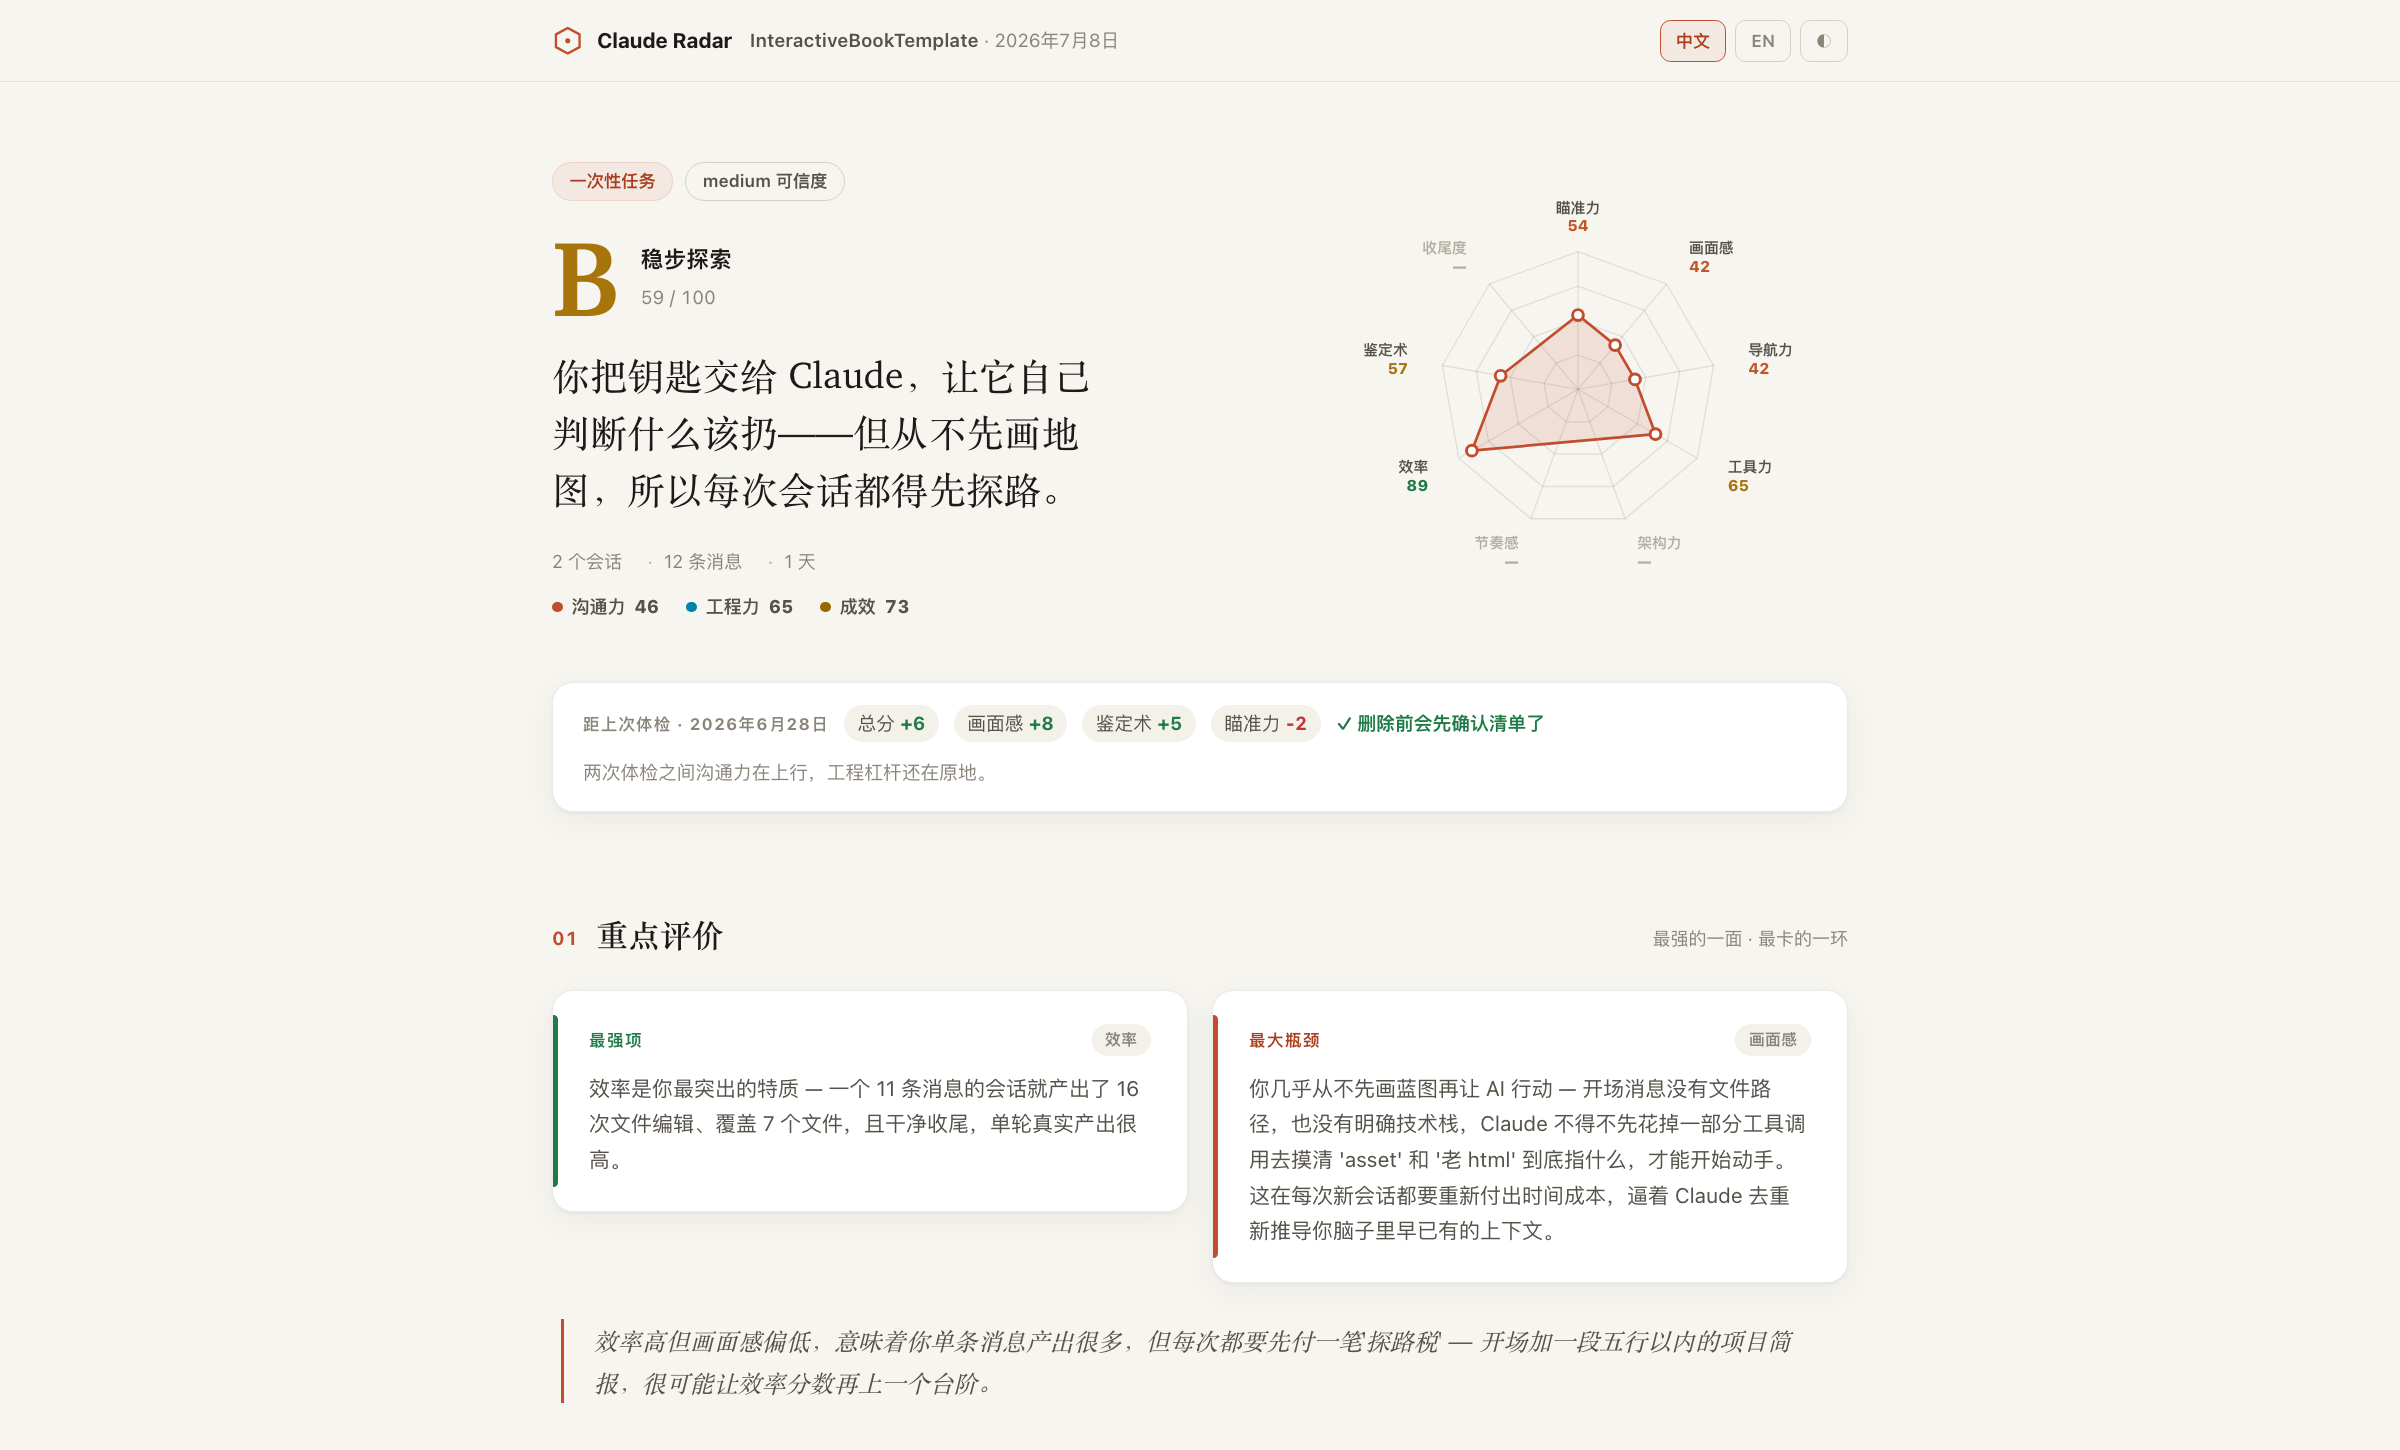
总评判定 —— S–D 等级、一句话点醒你的核心洞察、9 维雷达图并排呈现。项目画像类型永远标注在旁,让你知道自己是用什么尺子被量。做过体检的项目还会在下方直接显示分数变化和已落地的建议。
重点评价 —— 最强项和最大瓶颈做成两张高亮卡,各自锚定到对应维度,配一段维度交叉解读。这是用户最看重的部分。
重点建议 —— 杠杆最大的 1-2 条建议放大成编号大卡,可粘贴 prompt 前置;其余 3-5 条折叠成手风琴。每条都带真实证据、可复制的 prompt 改写、预期分数影响 —— setup 类建议还附带可直接安装的文件内容。高分用户拿到的是 "level-up" 进阶动作而非纠错。
九维得分 —— 按「沟通力 / 工程力 / 成效」分组的紧凑得分行,点开任意一行看完整评分依据和证据。
协作画像与附录 —— 一段专属于你的协作方式白描,外加默认折叠的附录:工具使用、编排统计、项目资产检测(CLAUDE.md、hooks、skills…),以及 v1.3 新增的**「运行环境与放手力」** —— 主力模型、effort 分布、auto 模式占比、长回合占比、打断与排队引导次数、验证闭环统计(多少编辑会话以验证收尾、跑了多少 reviewer agent 和测试/构建命令)。
明暗双主题、中英切换、打印友好。
安装
第一步 —— 添加插件市场:
/plugin marketplace add lemomo-ai/claude-radar
第二步 —— 安装插件:
/plugin install claude-radar@claude-radar-marketplace
本地安装:
git clone https://github.com/lemomo-ai/claude-radar.git ~/claude-radar
claude --plugin-dir ~/claude-radar
使用
/claude-radar
- Claude Radar 检测你的当前工作目录,问"是不是分析这个项目"
- 确认即用,或者从「最近 10 个项目」列表中选
- 等待解析 + 诊断完成(时长视项目大小而定)
- Dashboard 自动在浏览器打开
环境要求
- Claude Code —— 支持插件版本
- Node.js 18+ —— Claude Code 自带
- 不用
npm install、不用编译、不用服务
隐私
你的会话数据始终留在本地:
- 所有计算本地完成 —— 不发任何网络请求
- 无 API key、无遥测、无云端
~/.claude/projects/只读访问- 报告写入
~/.claude-radar/reports/ - CLAUDE.md / memory / agents 检测只读文件系统元数据,不读取文件内容(CLAUDE.md 只读取大小)
- v1.3 额外读取运行环境元数据 —— 模型名、effort 等级、权限模式、回合时长、压缩元数据、斜杠命令名(不含参数);Bash 命令字符串只做正则分类,用来识别测试 / 构建类运行。全部只在本地计算,一律不上传。
评分原理
两层模型:
- 评分层 —— 基线全部由脚本计算(
compute-baselines.mjs执行rubric.json里的结构化公式),零运行方差;Claude 只做 ±15 微调,且必须引用证据,否则保持 0。 - 诊断层 —— 独立的定性分析。150 字协作画像 + 核心诊断 + 交叉解读,全部锚定在解析器专门抽取的"维度证据瞬间"上。
公允性机制:
- 项目画像驱动分类权重和 N/A 维度
- 密度驱动的 confidence —— 5 条消息但信号密度高的项目不会被无理由打折
- 效率作为一等公民信号 —— "3 条消息 5 个文件编辑" 被识别为高效,不再被当作"消息少"扣分
- 验证是闭环,不是一句请求(v1.3)—— 测试 / 构建运行、reviewer subagent、UI 检查合上的闭环都计入鉴定术,不要求你开口
- 手动压缩加分,自动压缩才扣分(v1.3)—— 主动管理上下文是节奏,不是失控;效率维度也重新定标,重度用户不再顶在天花板上
👉 完整方法论
评分规则全公开
所有评分规则都在 data/rubric.json:
- 9 个维度的定义、基线公式、适用性规则
- 3 大类聚合 + 按 profile 的权重表
- 等级阈值(S/A/B/C/D)
- 诊断层和建议层的产出规范
- 密度驱动的 confidence 缩放
想让评分更贴合团队习惯?改这个文件就行,评分引擎每次运行都重新读。建议招式同理,都在 data/playbook.json:每条招式 = 触发条件 + 双语文案 + 可选的可安装资产模板。改完记得跑 node test/run.mjs。
项目结构
claude-radar/
├── .claude-plugin/plugin.json        # 插件清单
├── skills/analyze/
│   ├── SKILL.md                      # 流程:检测 → 解析 → 基线 → 微调/诊断 → 渲染
│   └── scripts/
│       ├── list-projects.mjs         # 扫项目 + cwd 匹配
│       ├── parse-project.mjs         # 信号提取(注入过滤、编排信号、斜杠命令、资产、维度证据、
│       │                             #   验证闭环、放手力、运行环境元数据)
│       ├── compute-baselines.mjs     # 确定性评分 + 招式触发匹配 + 上次报告对比
│       └── render-report.mjs         # JSON → HTML + 历史归档
├── viewer/template.html              # Dashboard 报告模板
├── data/
│   ├── rubric.json                   # 9 维结构化公式 + 画像权重 + 诊断规范
│   └── playbook.json                 # 30+ 条按条件触发的建议招式(含资产模板)
├── test/run.mjs                      # 回归测试(fixtures + 基线算术 + 触发器)
└── docs/
    ├── METHODOLOGY.md                # 方法论(英文)
    ├── METHODOLOGY_zh.md             # 方法论(中文)
    └── ITERATION_PLAN_v1.3.md        # v1.3 规格文档(Fable 5.1 时代适配)
约 300 KB,零运行时依赖。facts schema 2.2、报告 JSON 2.3 —— 已归档的 2.1 / 2.2 报告照常渲染。跑 node test/run.mjs 可验证确定性层。
协议
Claude Radar 采用 CC BY-NC 4.0 协议授权:
- ✅ 免费 用于个人、教育、研究等任何非商业场景
- ✅ 允许 fork、修改、分享 —— 请注明原作者和原仓库出处,并标注是否做了修改
- ❌ 商业用途(打包进付费产品、营利组织超出员工个人评估范围、付费 SaaS 托管、基于评分卖报告/分析等)需要单独的商业授权
商业授权咨询: [email protected]
完整协议条款(含英文版)请见 LICENSE。
为关心 AI 协作质量的人而做。
Yorumlar (0)
Yorum birakmak icin giris yap.
Yorum birakSonuc bulunamadi