one-prompt-video
Health Warn
- License — License: MIT
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 5 GitHub stars
Code Fail
- network request — Outbound network request in assets/pipelines/shader/film.js
- exec() — Shell command execution in assets/pipelines/shader/gl.js
Permissions Pass
- Permissions — No dangerous permissions requested
No AI report is available for this listing yet.
An Agent Skill that turns one prompt into a finished MP4. The LLM fills in a single video.json; one command renders it with music and captions. No video-generation model, no browser. Designed for Windows / macOS / Linux and small models. 一句话出片的 Agent Skill:大模型只填一份 video.json,一条命令生成带配乐和字幕的 MP4 短视频。不用视频生成模型,不用浏览器;为 Windows / macOS / Linux 设计,小模型也能跑。


带旁白和配乐的完整版,42 秒。GitHub 的播放器默认静音,播放后点右下角的喇叭图标打开声音,本页所有视频都一样:
https://github.com/user-attachments/assets/bbe739b1-32a2-4042-b0e6-c4116cb0daa9
画面由本技能的引擎逐帧渲染:自己写的三场画面加现成版式,源文件在 docs/demos/trailer。配乐用库乐队(GarageBand)的乐器采样制作,旁白是豆包语音合成的 AI 配音,做法在技能的 external-tools.md 里。
再看一支不是版式片的:展示短片《沿线剪下》,45 秒,没有旁白。
https://github.com/user-attachments/assets/4a6eb480-7430-4076-b320-c1aea5d31f0c
整支片子的每一帧都是代码画的,没有用视频生成模型,也没有用图片素材:模型按技能里 自由画面的短片 那条路线写画面代码,脚本管镜头、配乐和出片。配乐用库乐队(GarageBand)的乐器采样制作。
这是什么
一个 Agent Skill。装进 Claude Code、Codex 或任何支持技能的 agent 以后,你说一句话,它就交给你一支 20 到 90 秒的短视频:讲解、科普、产品介绍、数据播报、知识卡片,横屏竖屏都行。
- 不用视频生成模型。 每一帧都是代码画出来的:字不会错,数字不会变形,同一份输入永远出同一支片,哪里不满意改一个词重出。
- 模型先做设计。 定风格,定每一场画面上看到什么。题材里看得见的东西由它写代码画出来,其余用现成版式;排时间、配乐、字幕、编码、自检都由脚本做。
- 风格不设上限。 内置主题只是起点:颜色、字体随你换,每一场的画面可以自己写;能力强的模型还能接 Blender、真实乐器的配乐和 AI 旁白。
- 小模型也能跑。 表填错了,脚本逐条说明错在第几场、哪个字段、正确的写法是什么。
- 很轻。 只要 Node.js 和 ffmpeg,不要显卡,不要浏览器。实测一支 30 多秒的 1080p 片子十几秒出完(Apple Silicon 笔记本)。
看效果
下面四支片子的画面各由一份 video.json 出。配音是豆包语音,每支换一个音色、语气和语速;配乐是库乐队的乐器采样,每支一种编曲。这两样用的是技能里「借助外部工具」的做法:配音要自己的密钥,采样配乐只能在 macOS 上做。为了让播放器的封面有画面,每支开头加了一帧封面。播放器默认静音,记得点喇叭图标。
只填表出的片
「一句话,出一支片」:七场全是现成版式,grid 主题。女声,轻快;木吉他、钢琴、原声贝斯。本页后面的示例 video.json、主题预览和总览图用的都是它。
https://github.com/user-attachments/assets/b36dd503-4017-4324-a4ee-bb70dc505c53
「从一句话到 MP4」:八场全是现成版式,blueprint 主题。男声,沉稳;合成器铺底、拨弦音色、电子鼓。
https://github.com/user-attachments/assets/5a296a94-050b-4096-bbd9-c021417efa9e
「小模型也能出片」:竖屏,pop 主题,内容是本仓库的实测数据。女声,语速快;马林巴、电贝斯、颤音琴。
https://github.com/user-attachments/assets/1bec9149-21b1-4973-81be-457f3c279f72
加一场自己写的画面
「one-prompt-video 是什么」:七场里有一场是自己写的画面代码(一句话变成 video.json 再变成 MP4 的那一场),其余是现成版式。男声,从容;钢琴、圆号、合唱、竖琴。
https://github.com/user-attachments/assets/d89fea91-f7cd-4c06-b54d-4c51cbde7e3f
风格不设上限
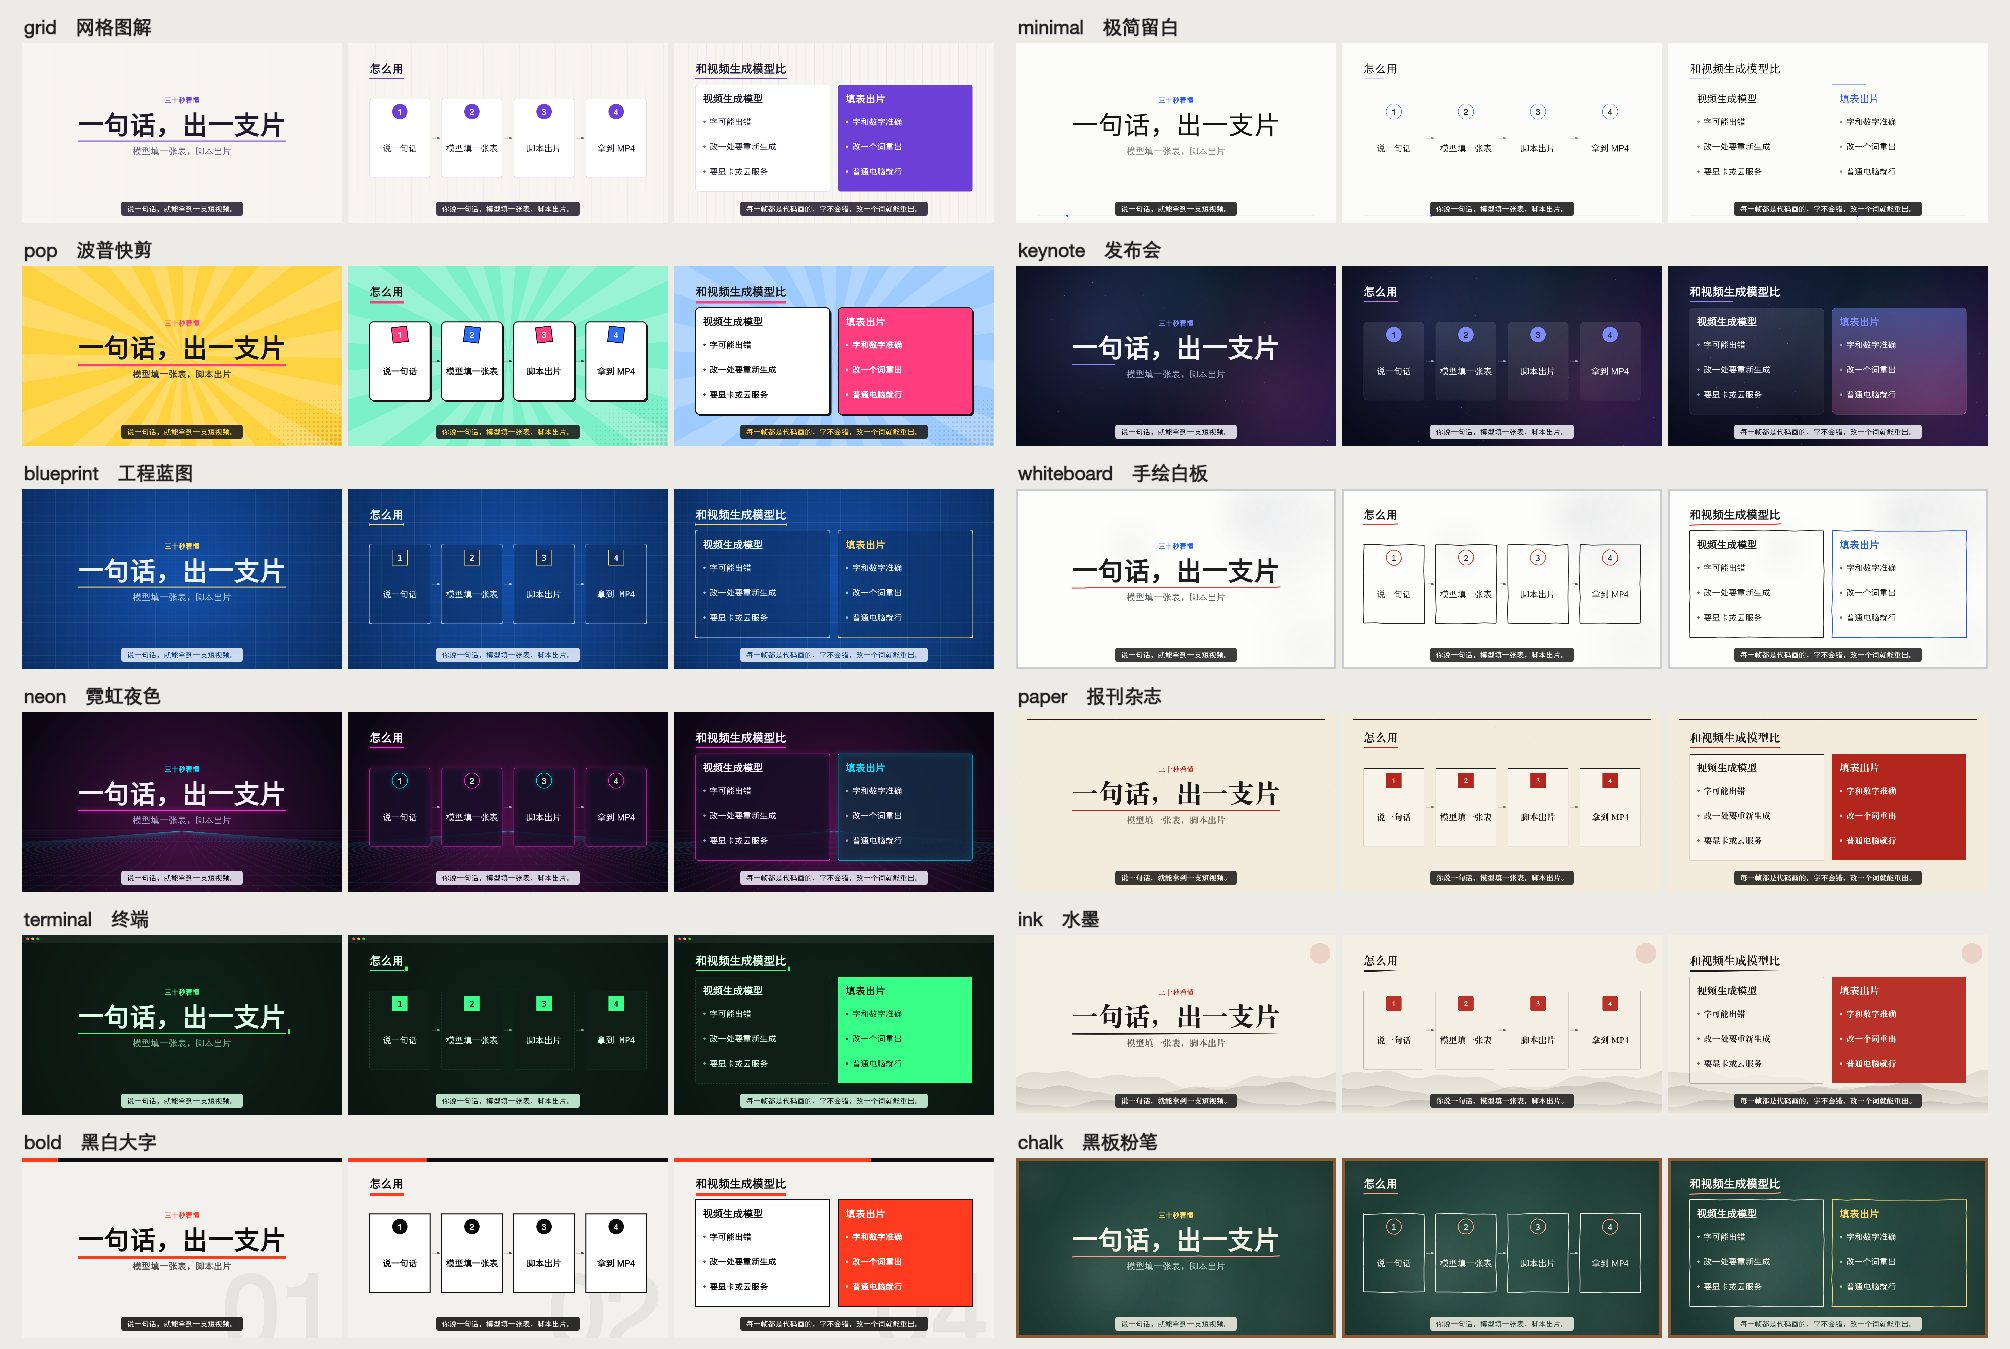
同一场内容轮换十八套风格。前十二套是内置主题,换一个词就行;后六套是在内置主题上用 colors 换了几个颜色配出来的,这样的想配多少套都可以。
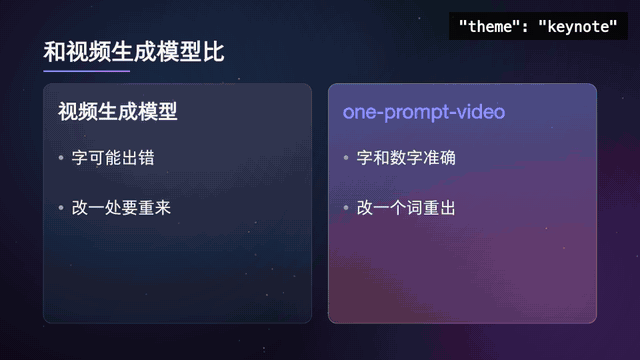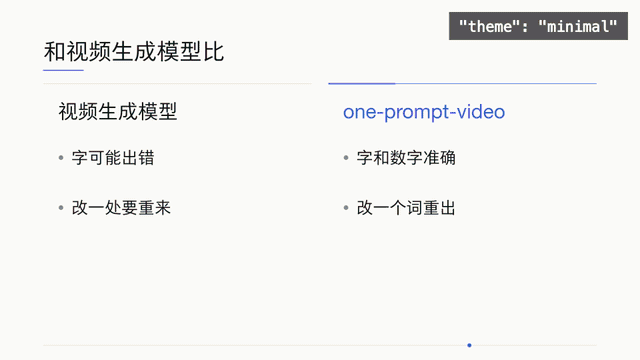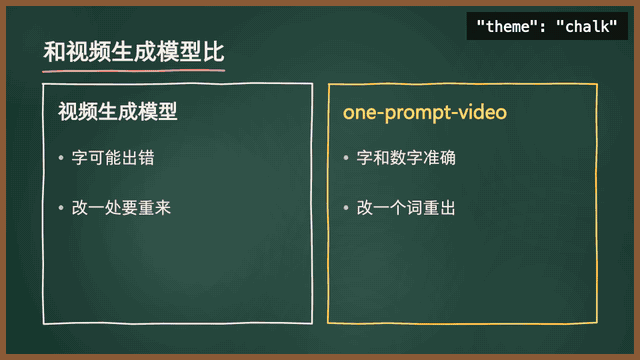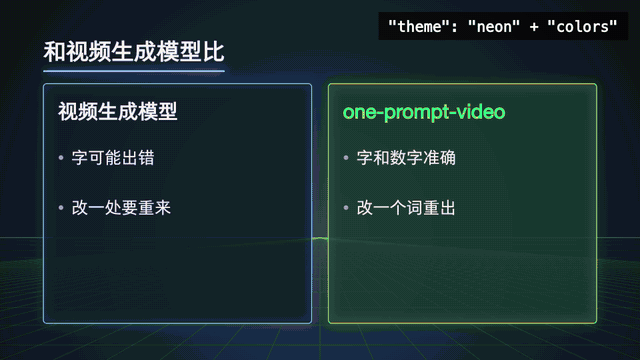
还不够的话,可以自己写某一场的画面,走三条参考生产线,或者借助外部工具,见后面的「进阶」。
内置主题各取三场:
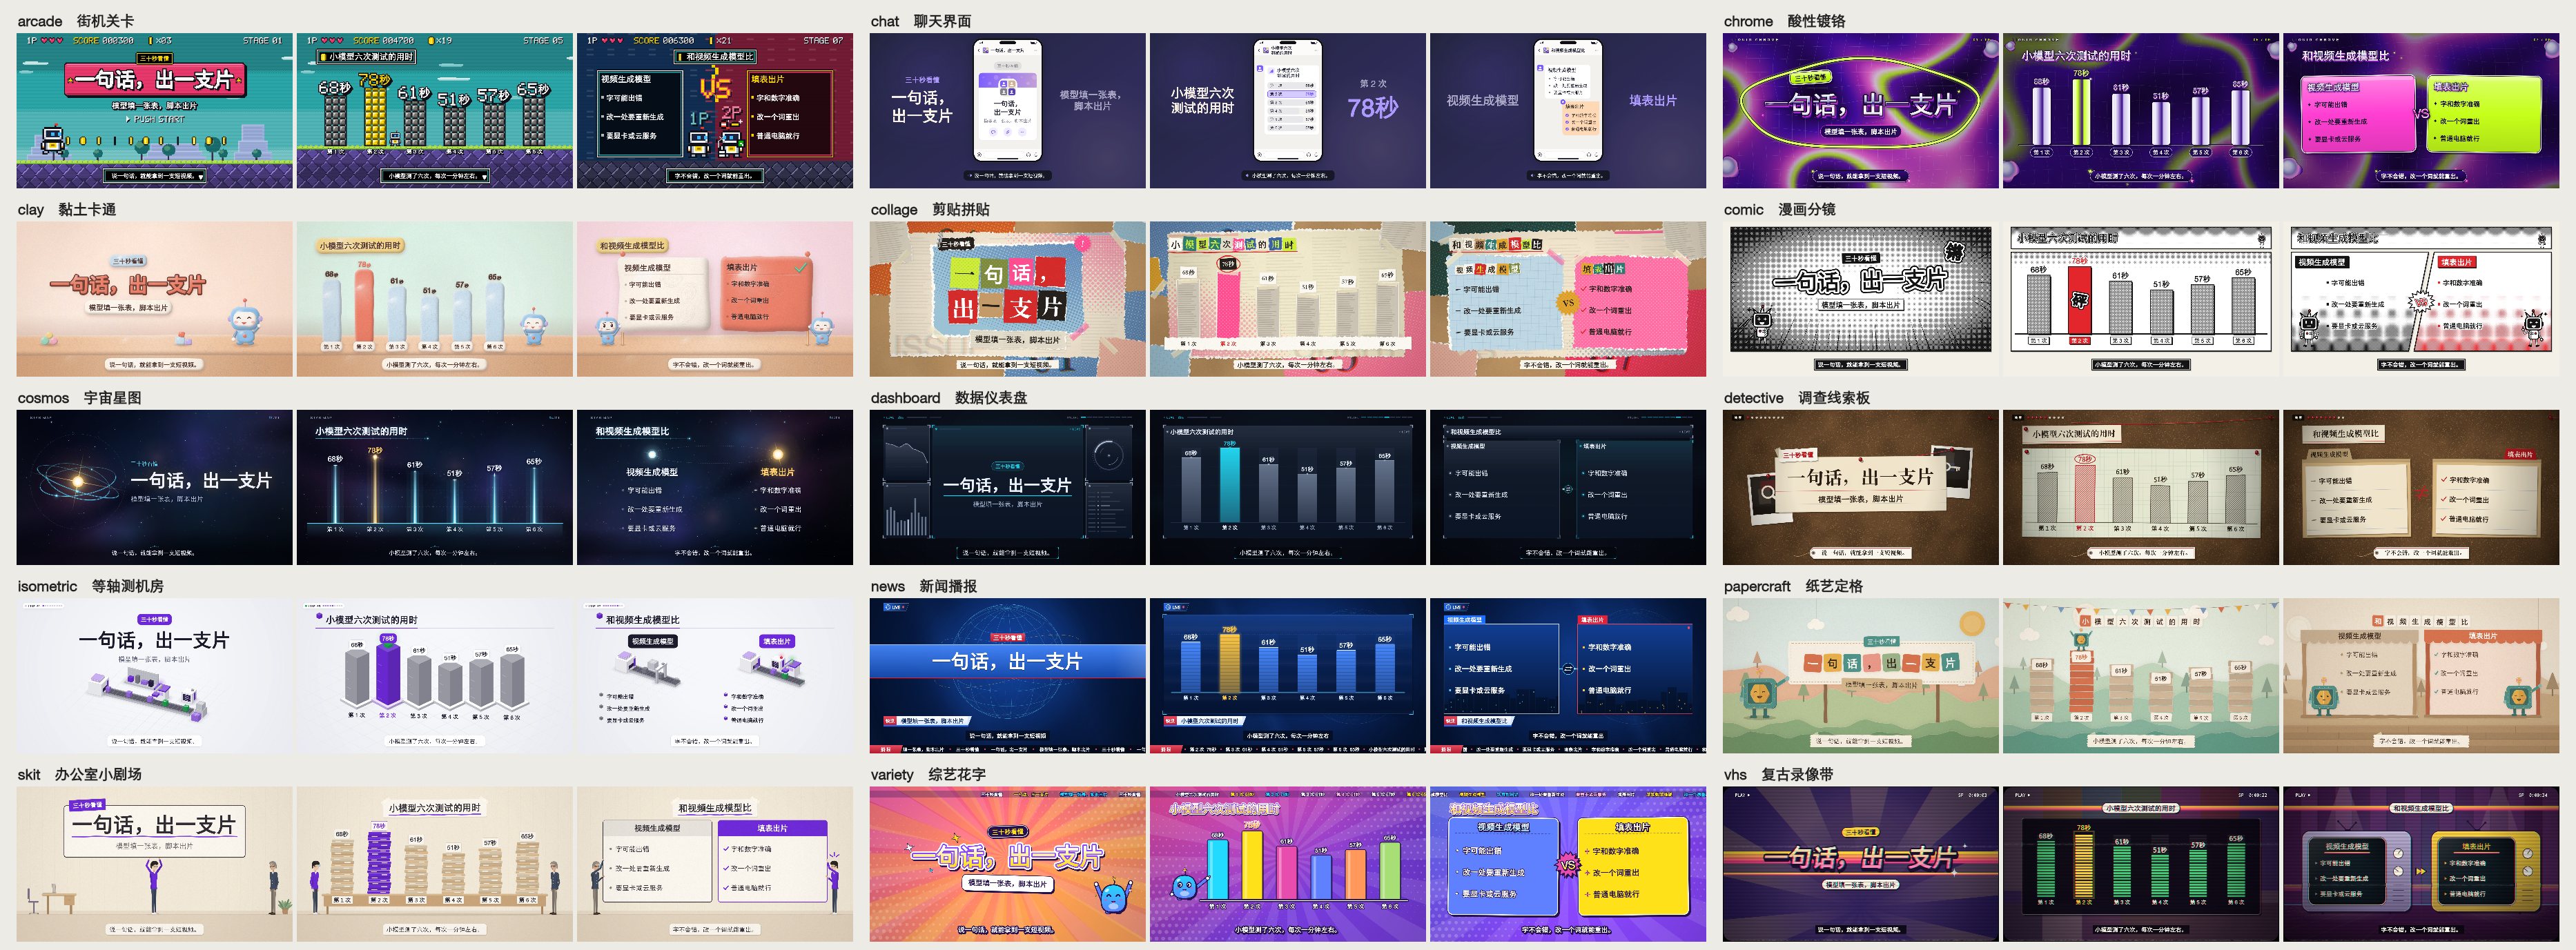
风格包:一整套自己的画面
主题换的是颜色和线条,风格包把九种版式各按自己的样子重画:聊天界面里每条要点是一个气泡,街机关卡里柱状图是一摞砖块,线索板上的步骤用红线连起来。用法一样,"theme" 换一个词。现成的有十五个,也可以让模型按 references/style-packs.md 现写一个新的。
剪进实拍素材,导出工程接着剪
video.json里加一场clip,写素材文件和起止秒数,实拍片段就和生成的画面排在同一条时间线上;全是clip就是剪辑已有的视频。- 出片命令加
--project,同时导出 Final Cut Pro 的.fcpxml、剪映草稿和.srt字幕:每一场是一个片段,配乐、音效、人声各一轨,字幕是能改的文字。 - Final Cut Pro 的工程实测能导入。剪映的草稿格式没有公开说明,这一版生成的草稿还没有在剪映里实测,剪映升级后也可能失效。
自由画面的短片
要有场景、有角色、有故事的短片,模型按 references/film.md 直接写每一帧怎么画,脚本管镜头表、配乐、分段续跑和自检。只要 Node.js 和 ffmpeg,不要浏览器。
它怎么做到的
flowchart LR
    A["你说一句话"] --> B["大模型写<br/>video.json"]
    B --> C{"校验"}
    C -- "有错:哪一场<br/>哪个字段、怎么改" --> B
    C -- 通过 --> D["排时间线<br/>画画面、合成配乐"]
    D --> E["MP4<br/>自检报告、总览图"]
时间线按主题的拍子排:每一场的长度是整数拍,换场和音效都落在拍点上,画面和配乐因此对得上。
模型写的是这样一份文件,加上其中自己画的那几场的画面代码(scenes/ 里):
{
  "title": "一句话,出一支片",
  "theme": "papercraft",
  "aspect": "16:9",
  "seconds": 30,
  "scenes": [
    { "layout": "title", "title": "一句话,出一支片", "say": "说一句话,就能拿到一支短视频。" },
    { "layout": "custom", "module": "scenes/pipeline.mjs", "seconds": 7, "cues": 3, "say": "你说一句话,模型做设计、填表,脚本把它变成片子。" },
    { "layout": "bars", "unit": "秒", "items": [{ "label": "第 1 次", "value": 68 }, { "label": "第 2 次", "value": 51 }, { "label": "第 3 次", "value": 57 }], "say": "小模型测了三次,每次一分钟左右。" },
    { "layout": "end", "title": "现在试试", "say": "现在就试一次吧。" }
  ]
}
写错了会得到这样的反馈,照着改就行:
[出错] video.json 有 2 处要改:
  1. 第 2 场(bars)的 "items" 要是 2 到 6 项,每项有 "label"(文字)和 "value"(不带引号、不小于 0 的数字)。正确的写法:{ "layout": "bars", "title": "场标题", "unit": "%", "items": [{ "label": "甲", "value": 40 }, { "label": "乙", "value": 75 }] }
  2. 第 3 场(bullets)缺 "items"。正确的写法:{ "layout": "bullets", "title": "场标题", "items": ["第一条", "第二条", "第三条"] }
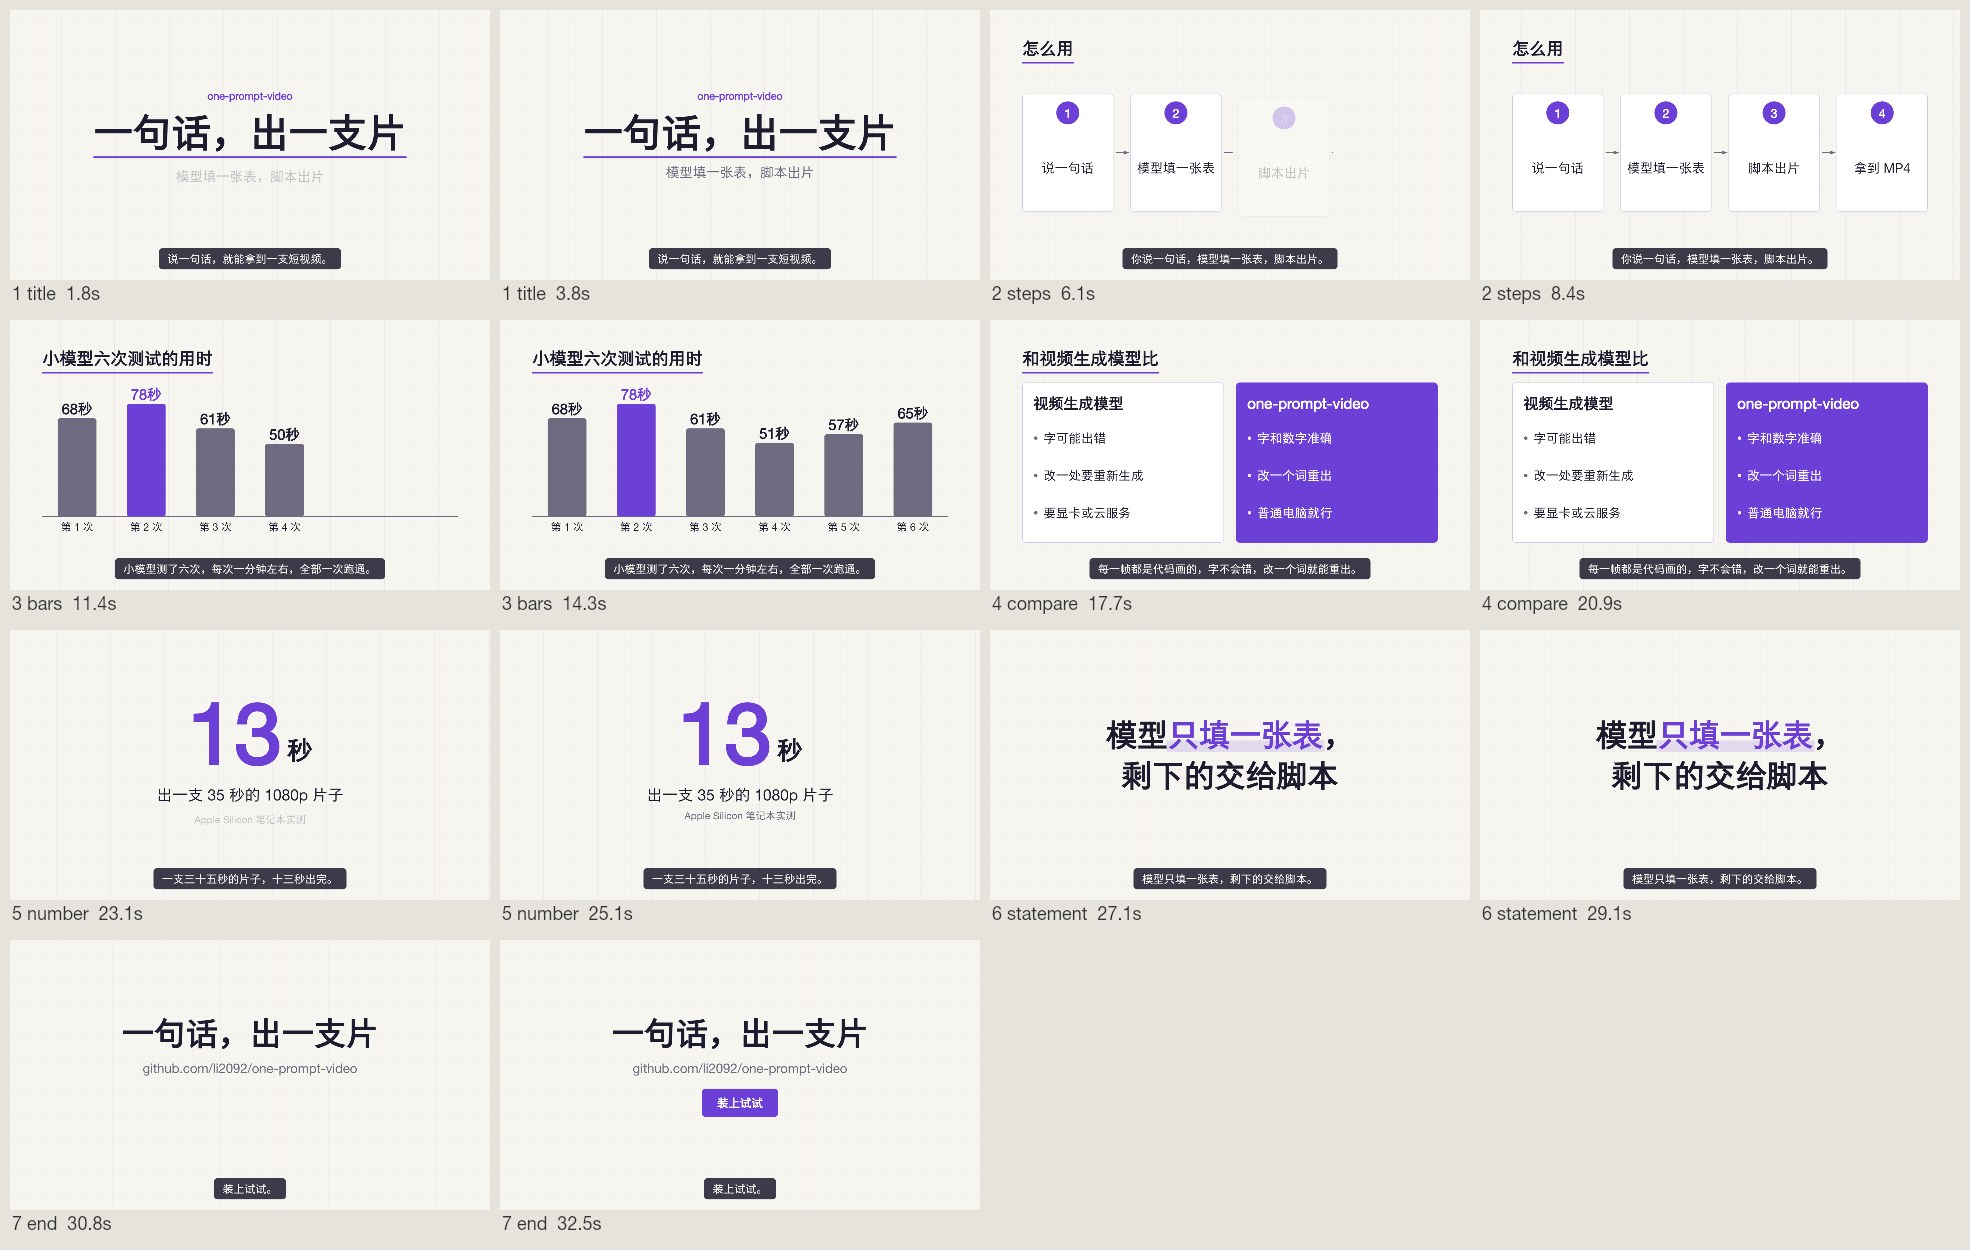
出片以后脚本自己查一遍分辨率、时长、响度、真峰值、有没有字放不下,并出一张每场两格的总览图,方便人和模型扫一眼:
快速开始
1. 装技能
# Claude Code
git clone --depth 1 https://github.com/li2092/one-prompt-video.git ~/.claude/skills/one-prompt-video

# Codex
git clone --depth 1 https://github.com/li2092/one-prompt-video.git ~/.codex/skills/one-prompt-video
Windows(PowerShell):
git clone --depth 1 https://github.com/li2092/one-prompt-video.git "$HOME\.claude\skills\one-prompt-video"
本页的视频和动图存在 GitHub 的附件服务上,不在仓库里,下载下来的仓库只有一两兆。
别的 agent 按它自己的文档放技能目录。不支持技能的模型,把 SKILL.md 的内容贴进对话,把里面的 SKILL 换成这个目录的绝对路径。
2. 说一句话
做一个 30 秒的视频,介绍 one-prompt-video 这个技能
把这组数据做成短视频:小模型六次测试的用时是 68、78、61、51、57、65 秒,突出全部一次跑通
帮我做个竖屏短视频:一句话就能出片,不用显卡,不用视频生成模型
第一次用时,agent 会跑一遍环境检查,缺画图库或 ffmpeg 会自动装或告诉你怎么装。
不经过 agent,直接用脚本
mkdir my-videos && cd my-videos
node /path/to/one-prompt-video/scripts/setup.mjs
mkdir demo && cp /path/to/one-prompt-video/assets/example.video.json demo/video.json
node /path/to/one-prompt-video/scripts/make.mjs demo/video.json     # 成片在 demo/out/
九种版式
| 版式 | 用来 | 版式 | 用来 |
|---|---|---|---|
title |
开头 | steps |
先后步骤、流程 |
statement |
一句要让人记住的话 | compare |
两样东西对比 |
bullets |
并列的几个要点 | quote |
引用别人的话 |
number |
一个关键数字,从 0 滚到目标值 | end |
结尾,可带一个按钮 |
bars |
柱状图,比大小 | custom |
自己写这一场的画面代码 |
每一场都可以加一句 say 作字幕。全部字段见 references/video-json.md。
实测
- 只填表的旧版本:用 Claude 的小模型 Haiku 测了三道题(讲清一个概念、竖屏带货、把一组数据做成片),每道两轮,六次都一次跑通,每次约一分钟。
- 先设计再出片的现版本:用 deepseek-v4.1-flash 测了五道题。科普、产品介绍、数据播报、竖屏知识卡片四道各用 3 到 8 分钟出片,每支有三到四场是模型自己画的。氛围短片那道走自由画面路线,一小时没有做完,这条路线目前要能力更强的模型。
让小模型跑得通的几个设计:
- 模型不算时间,不调参数;画面代码只写题材里看得见的那几场。
- 校验一次报出全部问题,每条带正确写法的例子。
- 多余的逗号、外面包了代码围栏这类小毛病,脚本自己容错。
- 字太多时自动缩小字号,并在报告里提醒缩短。
- 中文按词折行,不会把「满意」折成两行。
进阶
从近到远,一层层往外走:
| 想要 | 怎么做 |
|---|---|
| 换颜色、换字体、固定某一场的秒数 | references/video-json.md |
| 加人声 | 技能不带配音服务,配音要自己找:放自己的录音,或接一个自己的 TTS:references/voice.md |
| 某一场要特别的画面 | 这一场自己写画面代码,其余照常用版式:references/custom-scenes.md |
| 卡通短片、3D 场景、自然风景 | 三条参考生产线:references/pipelines.md |
| 写实渲染、真实乐器的配乐、AI 旁白 | 借助外部工具:references/external-tools.md |
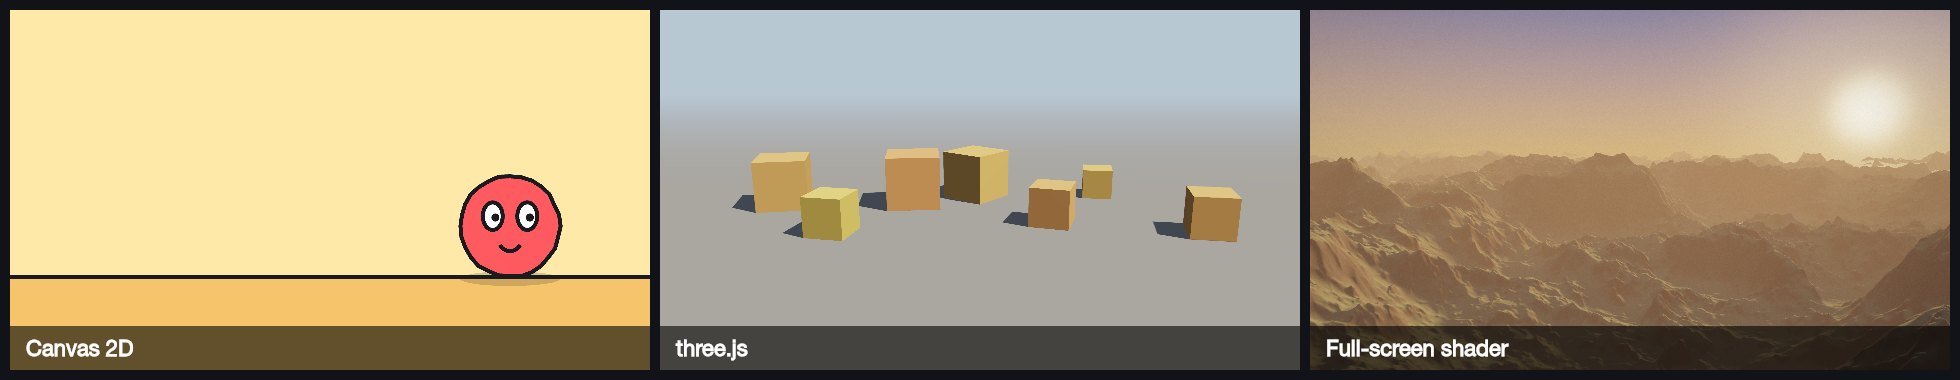
三条参考生产线各带一个能跑的最小工程,给能力强的模型用:
借助外部工具
用户的机器上有相应的软件或账号时,能力强的模型可以用这三种做法,说明和最小工程在 references/external-tools.md:
- Blender 渲染:全局光照、真实材质、反射、景深。要装好的 Blender。
- 乐器采样配乐:铜管、合唱、竖琴、定音鼓的真实音色。要 macOS 上的库乐队或 Logic。
- 豆包语音旁白:自然的中文人声,也能念英文、日文。要自己的火山引擎密钥。
本页顶上的宣传片用了后两种。下面这支 8 秒的小样是作者用 Blender 这条路线做的。它的工程比技能里带的最小工程复杂得多(自己建的建筑和山体,加 CC0 的树和岩石素材),1080p 渲了 5 小时 37 分,放在这里是为了说明这条路线的画面上限,装上技能不等于一句话就能出这样的片子。
https://github.com/user-attachments/assets/225be1e4-821d-4b5b-9432-e9ffde8ccc12
本页演示片的源文件在 docs/demos/,可以照着重出。
它不是什么
| 本技能 | 视频生成模型 | |
|---|---|---|
| 画面来源 | 代码逐帧画 | 模型生成像素 |
| 文字和数字 | 准确,和输入一致 | 可能出错 |
| 改一处 | 改一个词重出,其余不变 | 重新生成,整体会变 |
| 实拍感、真人、镜头语言 | 没有 | 有 |
| 硬件 | 普通电脑 | 要显卡或云服务 |
它做的是讲清楚一件事的短片:风格包和版式,加上模型自己画的几场。用户给的实拍和录屏素材可以剪进去,也可以导出 Final Cut Pro 和剪映的工程接着剪。凭空生成真人或实拍画面做不了;有场景、有角色的故事片走自由画面路线,要能力强的模型。
现状
- 版本 0.6.1。只在 macOS(Apple Silicon)上实测过;Windows 和 Linux 的代码路径按文档写了,还没有实测,欢迎反馈。
- 不接外部工具时的默认输出是程序合成的配乐、没有人声,比上面的演示片简单。同一支「一句话,出一支片」的默认输出可以对比着看。
- 配乐(自带的和采样的)只量过响度和峰值,好不好听要你自己听。
- 方形(1:1)画幅:15 个风格包里有 11 个放不下版式表上限的字,各包
NOTES.md的「容量」一节写了量出来的上限。横屏、竖屏都放得下。 - 技能的说明文件和脚本的提示信息目前是中文;片子的内容可以是任何语言,英文排版已支持。
目录
SKILL.md                     模型读的主说明;仓库根目录就是技能本体
scripts/                     setup.mjs、make.mjs、browser-render.mjs、engine/
references/                  按需读的说明
assets/                      示例 video.json、主题预览、参考生产线的最小工程
docs/                        本页用的图,演示片的源文件在 docs/demos/
作者和许可
作者:JiMiL、vivhuang。MIT 许可。依赖和做法的出处见 references/sources.md。
Reviews (0)
Sign in to leave a review.
Leave a reviewNo results found