vividpaper
Health Warn
- License — License: NOASSERTION
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 5 GitHub stars
Code Pass
- Code scan — Scanned 12 files during light audit, no dangerous patterns found
Permissions Pass
- Permissions — No dangerous permissions requested
No AI report is available for this listing yet.
VividPaper 视觉化读论文 · Claude Code / Codex skill: turn any paper (arXiv or PDF) into an animated, voiced explainer page · 把一篇论文做成带配音的动效解读页 · 在线示例:Transformer / ResNet / ViT / DDPM / CLIP / RoPE / Flow Matching · 张指导出品
VividPaper · 视觉化读论文
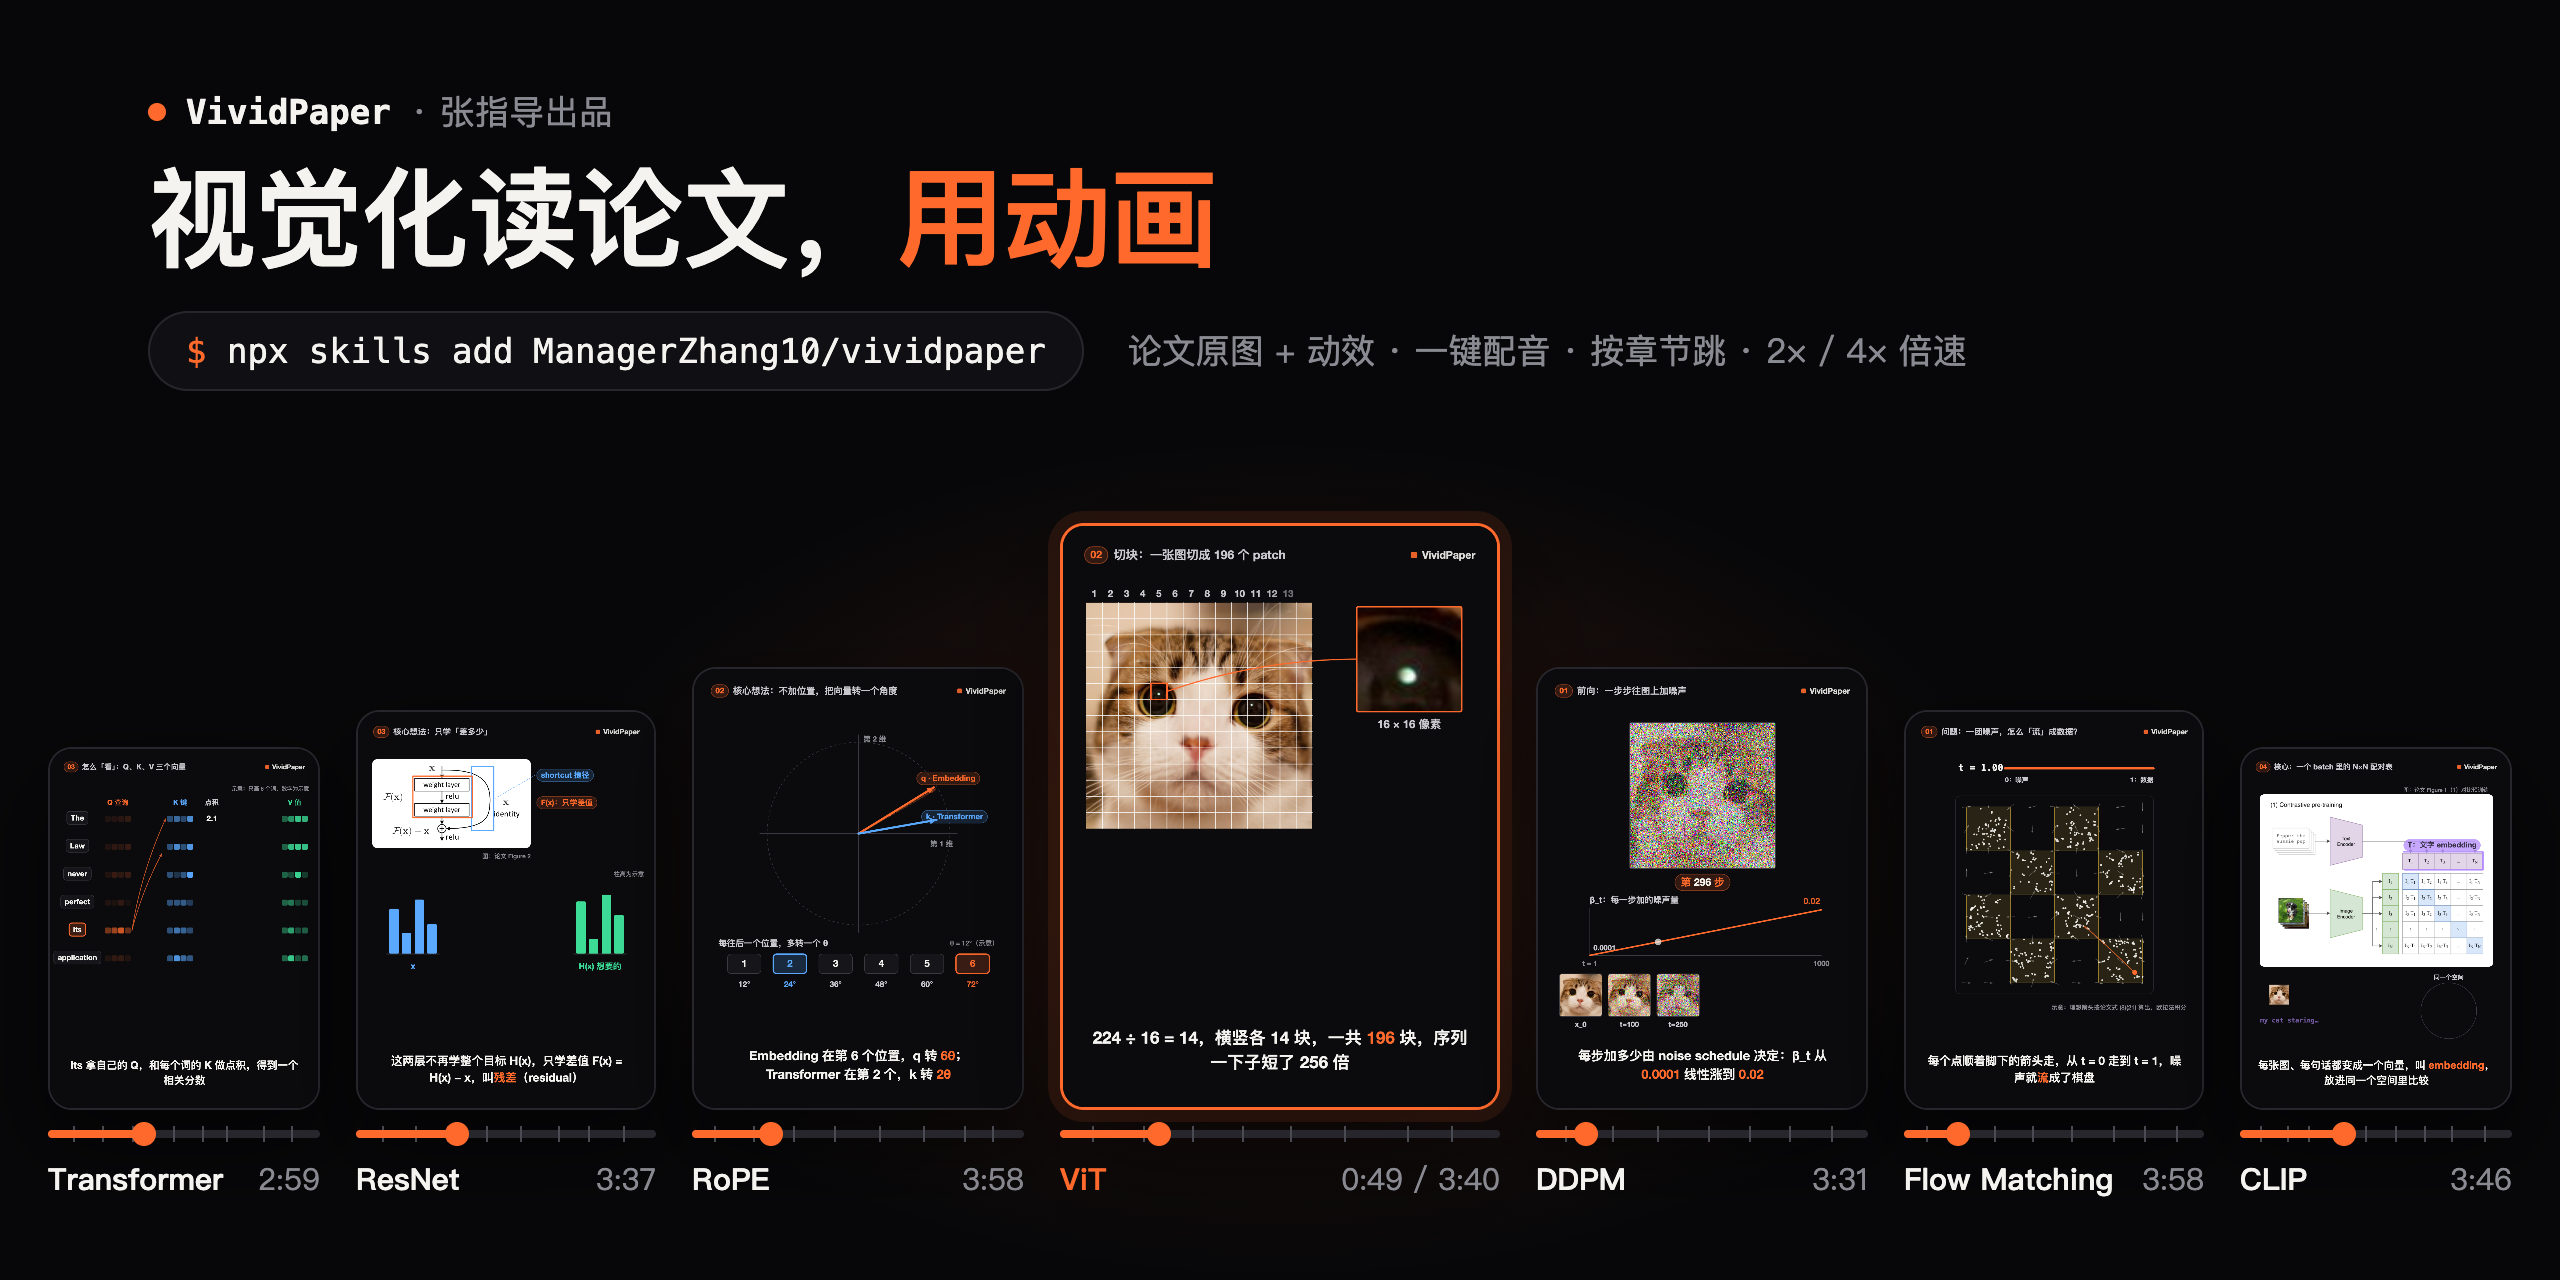
张指导出品。 给你的 AI 编程助手(Claude Code、Codex 等)装上这个 skill,丢给它一篇论文,它会做出一个动效解读页:一个双击就能在浏览器里打开的 HTML 文件,用论文自己的图加上动画,一幕一幕讲清这篇论文解决什么问题、核心做法是什么、为什么有效、效果多好。
还能一键配音:免费的中文男声把字幕念出来,画面和动作跟着声音走。
不是文字总结,也不是 PPT。看完你能用自己的话把这篇论文讲出来。
▶ 在线看全部示例:https://managerzhang10.github.io/vividpaper/(点开即播,带配音,不用下载)
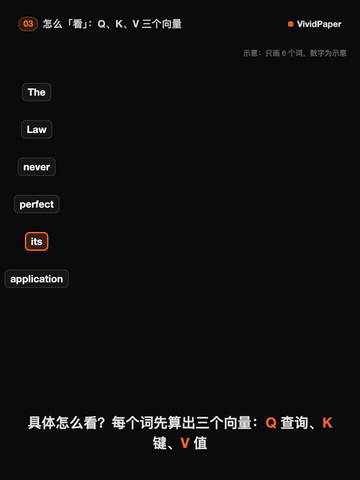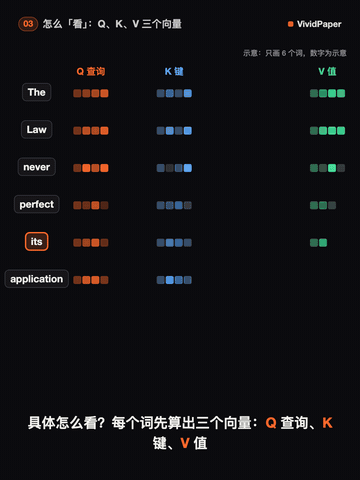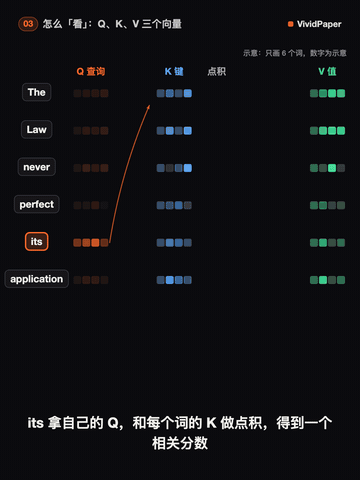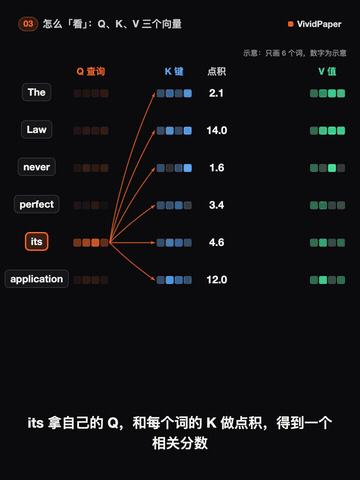 Transformer |
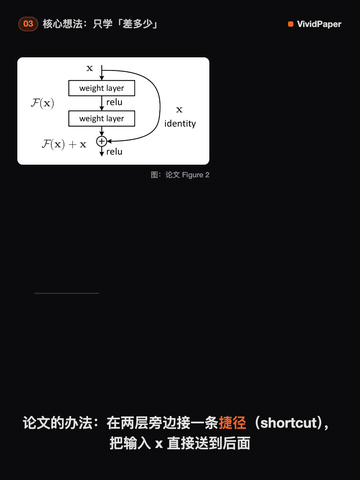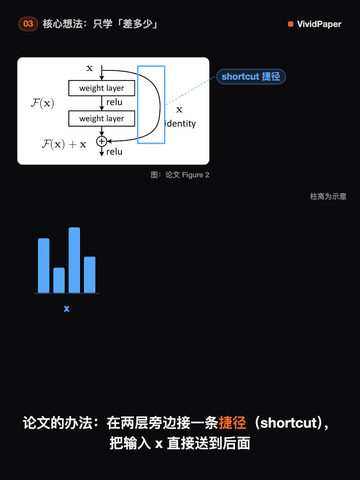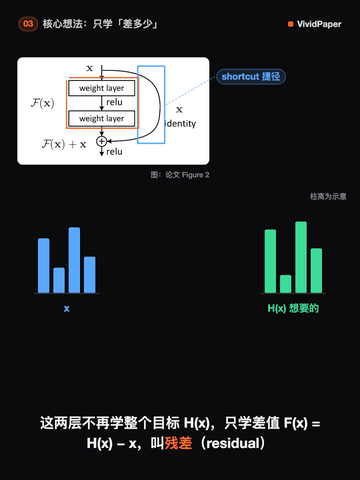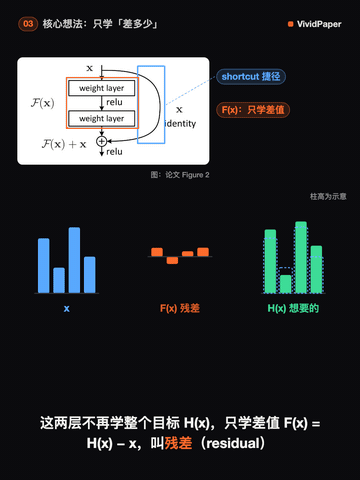 ResNet |
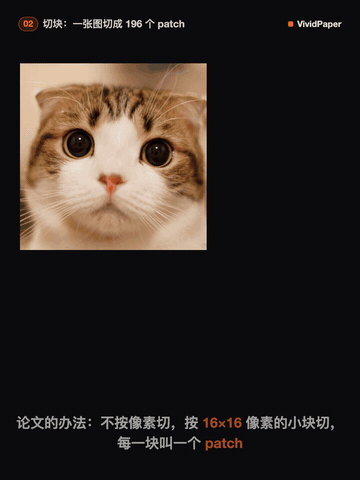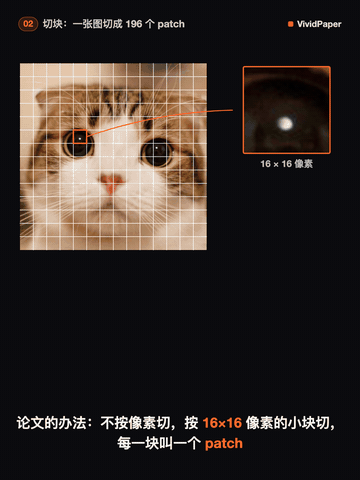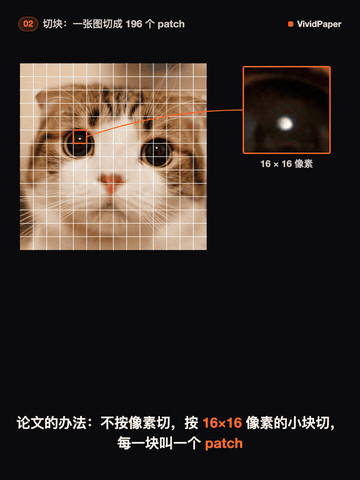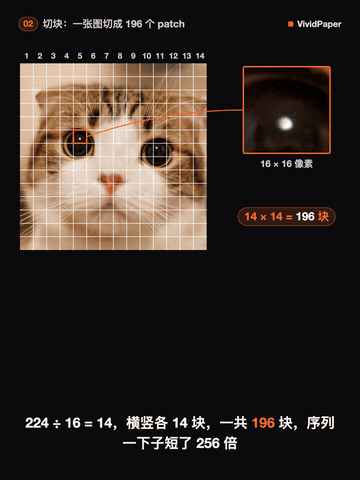 ViT |
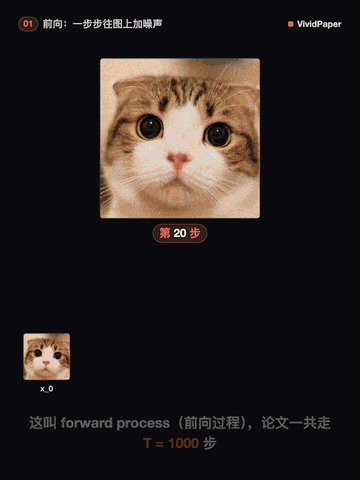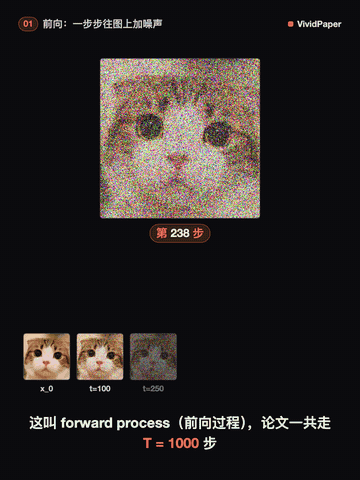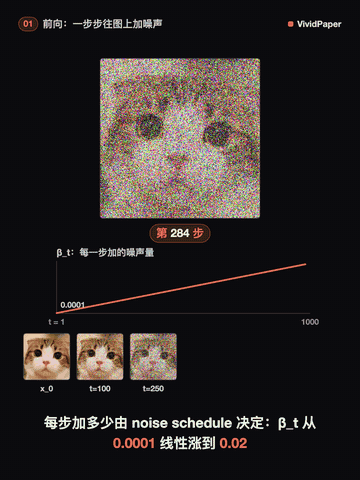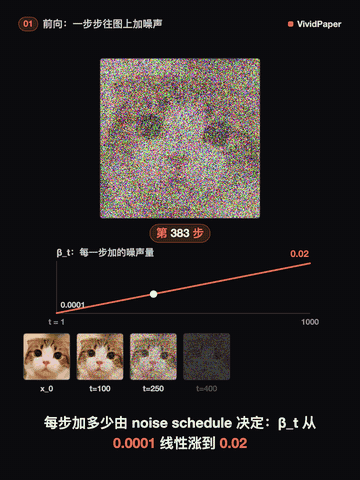 DDPM |
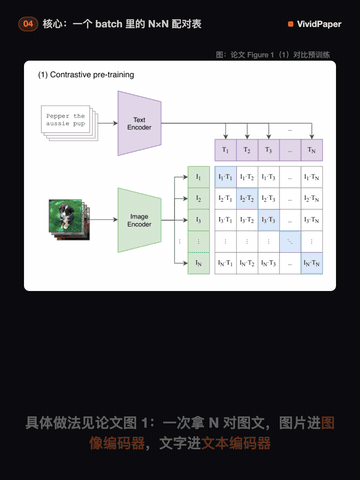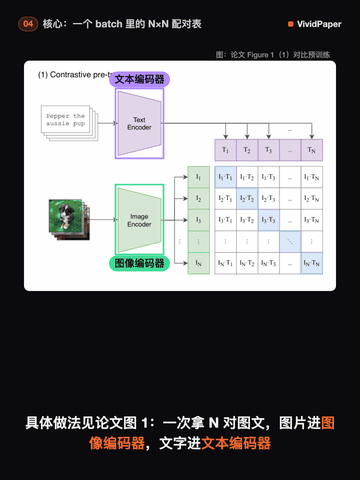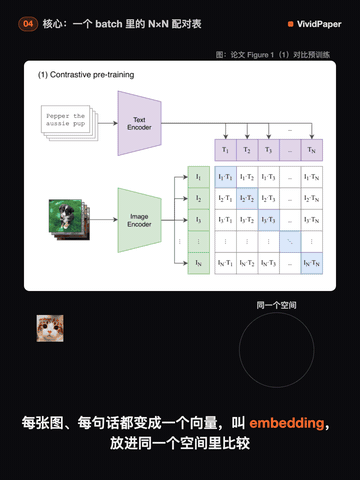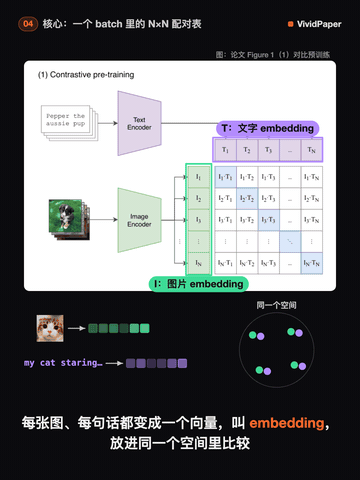 CLIP |
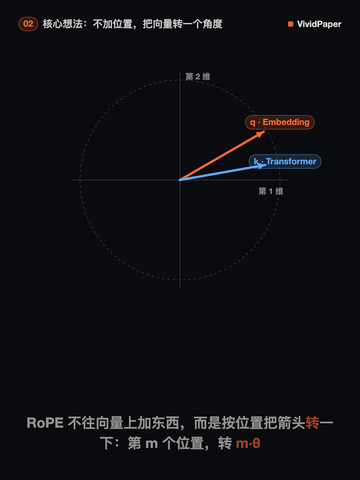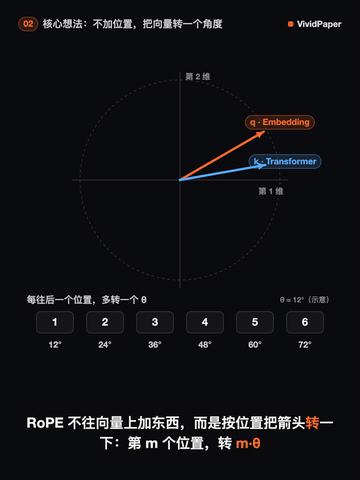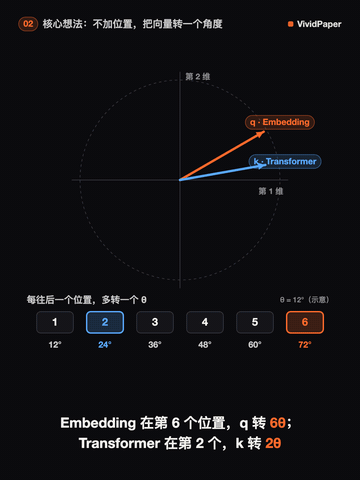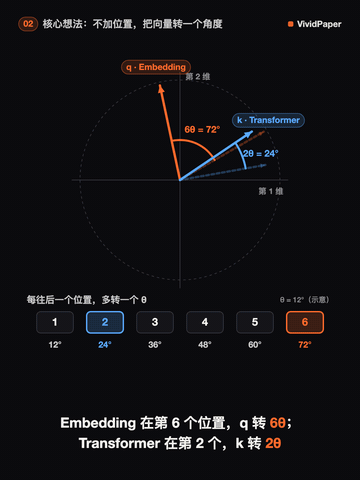 RoPE |
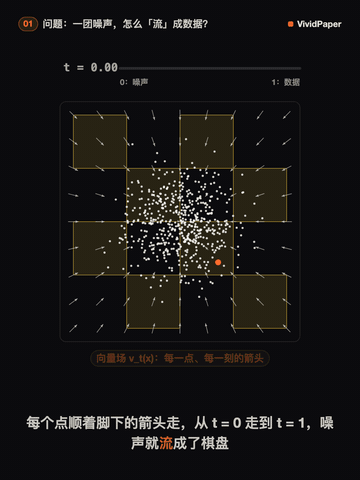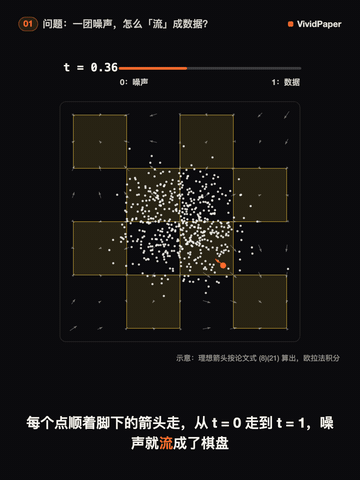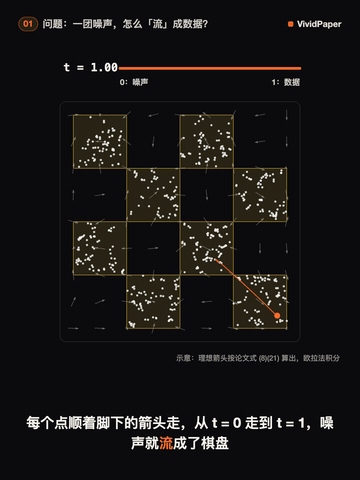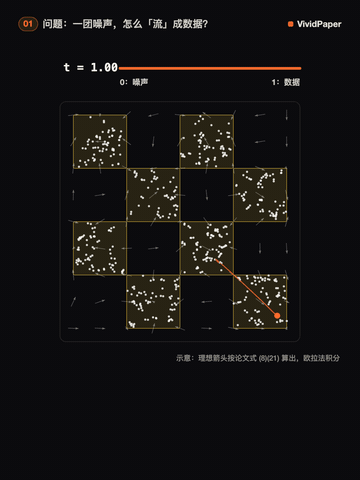 Flow Matching |
示例
| 论文 | 一句话主线 | 在线看 | 时长 |
|---|---|---|---|
| Attention Is All You Need(2017) | 翻译模型能不能完全不用 RNN,只靠注意力? | ▶ Transformer | 2:48 |
| Deep Residual Learning(2015) | 网络越堆越深,为什么反而越训越差? | ▶ ResNet | 3:23 |
| An Image is Worth 16x16 Words(2020) | 图像能不能像句子一样,直接交给 Transformer? | ▶ ViT | 3:30 |
| Denoising Diffusion Probabilistic Models(2020) | 怎么从纯噪声一步步「洗」出一张图? | ▶ DDPM | 3:17 |
| Learning Transferable Visual Models(2021) | 不给人工标签,模型能不能光靠网上的图文配对学会认图? | ▶ CLIP | 3:36 |
| RoFormer: Rotary Position Embedding(2021) | 注意力分不清词序,怎样让分数只看两个词隔多远? | ▶ RoPE | 3:48 |
| Flow Matching for Generative Modeling(2022) | 一团噪声要流成数据,每一点该往哪走,怎么教给模型? | ▶ Flow Matching | 3:47 |
动图是每部片子核心一幕的 8–10 秒片段(动图没有声音)。打开后:空格播放/暂停,←/→ 跳 5 秒,1/2/4 切倍速,M 开关声音,右侧章节可以直接跳。想离线看就下载 examples/<名字>/<名字>.html 双击打开,单文件、配音也在里面,不联网也能放。
安装
npx skills add ManagerZhang10/vividpaper
或者手动:把 skills/vividpaper/ 复制(或软链)到你的 agent 的 skills 目录,例如 ~/.claude/skills/vividpaper、~/.codex/skills/vividpaper。
依赖:Python 3、pip install pymupdf、本机装有 Google Chrome(自查要用,路径不标准时设环境变量 CHROME)。配音另需 pip install -U edge-tts,不配音可以不装。
用法
对你的 agent 说:
用 vividpaper 把 arxiv.org/abs/1706.03762 做成动效解读
它会按 SKILL.md 的流程走:拉原文和原图 → 定一个主线问题和一个贯穿全片的例子 → 拆成 5–8 幕 → 裁论文原图、写动效 → 打包成单文件 HTML → 无头 Chrome 自查(出界、字太小、压字幕、画面不动),没问题才交给你。
可选一键配音:再说一句「给它配个音」,或者自己跑 voice.py <短名>。用的是免费的 edge-tts 中文男声,不用 API key;字幕和动作跟着声音走,看的人随时可以点 🔊 或按 M 关掉声音。
python3 skills/vividpaper/scripts/voice.py <短名>    # 默认云希男声;--voice zh-CN-YunyangNeural 换声音
python3 skills/vividpaper/scripts/build.py <短名>    # 有 voice/ 就把配音打包进 HTML
它是怎么做的
- 每一帧都是时间 t 的纯函数:同一个 t 永远画出同一帧,所以可以随意拖进度、4 倍速看,也能在无头浏览器里逐帧自查。
- 画面讲机制,字幕讲句子:每句字幕都配一个画面动作(出现、连线、标框),论文原图上讲到哪框到哪。
- 声音当时钟:配了音以后,每句字幕念完才切下一句,挂在字幕上的动作自动跟着声音走;拖进度、跳章节、2× 都同步。公式会先改成能念的说法(
x_t念「x t」),念不好的句子可以单独写念法。 - 真图真数:架构图、可视化直接裁论文原图并标出处;结果画成条形图,数字只从原文取,示意数字标「示意」。
许可
代码 MIT。examples/ 里的论文插图版权归原作者,仅用于解读并在画面上注明出处。
Reviews (0)
Sign in to leave a review.
Leave a reviewNo results found