talking-objects
Health Warn
- License — License: MIT
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 6 GitHub stars
Code Pass
- Code scan — Scanned 12 files during light audit, no dangerous patterns found
Permissions Pass
- Permissions — No dangerous permissions requested
No AI report is available for this listing yet.
Objetos que conversan: Raspberry Pi, Vidiv + ElevenLabs, luces y MCP
English · Raspberry · Agentes · Experiencias · MCP · Luces · Operación
Un kit para construir objetos que conversan: una cabina telefónica, una lámpara, una escultura o una sala que escucha a quien se acerca, le responde con voz y reacciona con luz y gestos. Corre en una Raspberry Pi 5, habla con agentes de Vidiv y de ElevenLabs con relevo automático entre los dos, y abre sus luces y pantallas a cualquier agente mediante MCP.
Sale de TeleTUP, la cabina con la que GAIA 2147 conversa con el público en ferias y festivales. Este repo no incluye el personaje de GAIA, sus prompts ni datos de llamadas: solo la técnica, para que puedas construir el tuyo.
Qué hay dentro
| Pieza | Qué hace | |
|---|---|---|
| 01 | device/ |
El programa de la Raspberry: audio, interruptor, Vidiv, ElevenLabs, relevo, luces, pantalla, reglas y página de estado. Python 3.11+. |
| 02 | worker/ |
Un Worker de Cloudflare con un servidor MCP y un relé: los agentes llaman a las tools y las órdenes bajan hasta la Pi, aunque esté detrás del NAT de un recinto. TypeScript. |
| 03 | docs/ |
Seis guías: hardware, agentes, diseño de experiencias, MCP, luces y operación en campo. |
| 04 | examples/ |
Tres experiencias de partida: cabina, objeto que escucha y sala. |
Cómo funciona
flowchart LR
    V((Visitante)) -- descuelga --> T[Interruptor<br/>GPIO17]
    T --> A[App en la Pi]
    A <--> AU[Audio<br/>un hilo dueño de la tarjeta]
    A --> F{Relevo}
    F -- primero --> VI[Vidiv<br/>LiveKit]
    F -- reserva --> EL[ElevenLabs<br/>Agents]
    VI & EL -- transcripción --> R[Reactor<br/>rules.toml]
    R --> ACT[Acciones<br/>con cupos]
    ACT --> L[Luz WS2812]
    ACT --> D[Pantalla LCD]
    AG[Cualquier agente MCP] -- tools/call --> W[Worker<br/>MCP + relé]
    W -- websocket saliente --> ACT
Tres ideas sostienen el diseño:
- La voz nunca depende de un solo proveedor. Vidiv va primero; si no conecta, ElevenLabs entra mientras suenan los tonos de espera y el visitante no se entera. Un cortacircuitos evita que el siguiente visitante pague el mismo fallo.
- El objeto reacciona solo a la conversación. El reactor lee la transcripción y enciende luces o escribe en la pantalla según reglas sencillas, sin que el agente gaste turnos ni añada latencia. El agente también puede pedir gestos por MCP o por RPC cuando quiera.
- Una sola puerta al hardware. Agente, reglas y MCP pasan por el mismo registro de acciones, que valida, limita (por llamada, por día, con espera) y registra. Una luz que falla nunca corta una conversación.
Empezar en cinco minutos, sin hardware
git clone https://github.com/olmedcr-cmyk/talking-objects.git && cd talking-objects/device
python3 -m venv .venv && .venv/bin/pip install -r requirements.txt
cp config.example.env config.env && cp rules.example.toml rules.toml
FAKE_AUDIO=1 TRIGGER_MODE=keyboard .venv/bin/python -m talking_objects -v
Con s + Enter empieza una conversación y con e + Enter termina. La página de estado queda en http://localhost:8081. Para que hable de verdad, rellena en config.env las credenciales de Vidiv o de ElevenLabs (guía de agentes).
En una Raspberry Pi 5
scp -r device [email protected]:~/talking-objects
ssh [email protected]
cd ~/talking-objects && ./deploy/install.sh
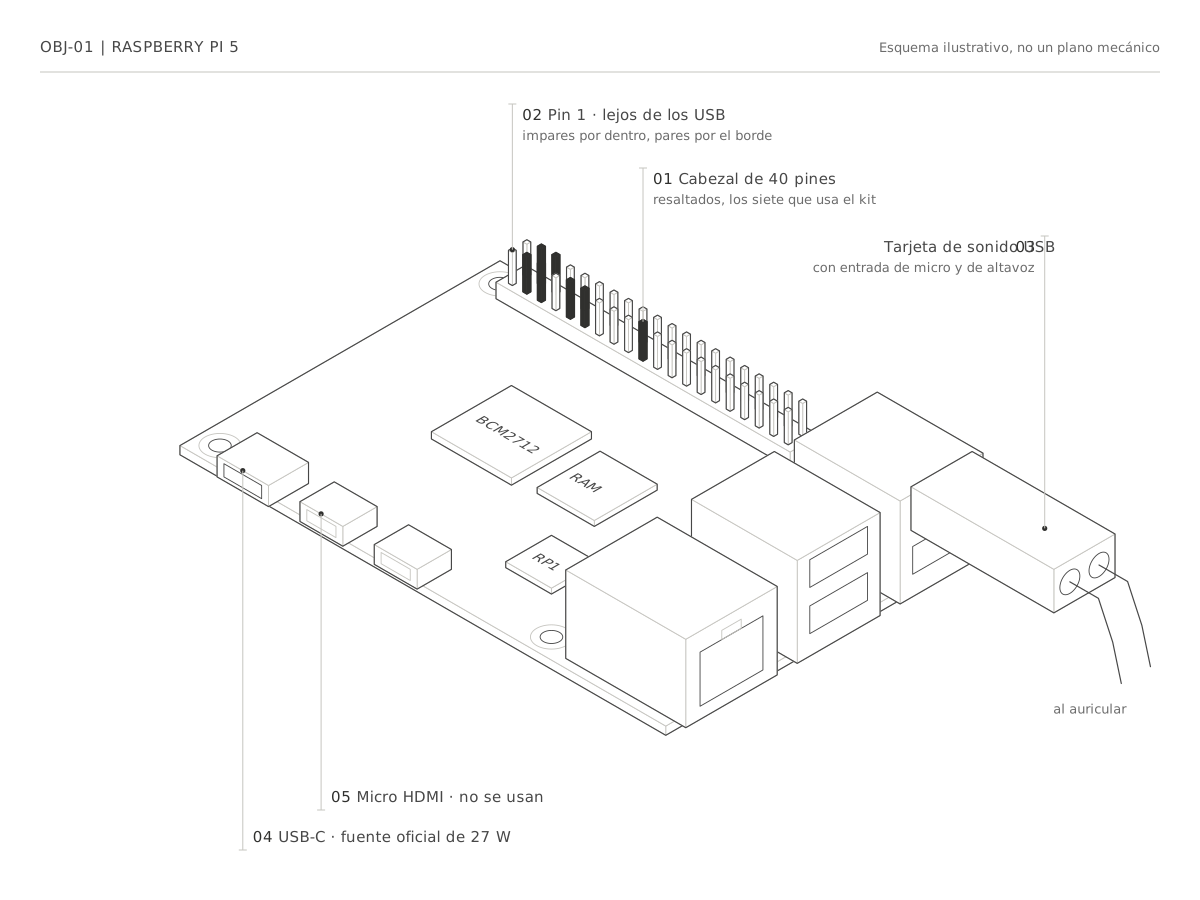
El instalador es idempotente: activa I2C y SPI, crea el entorno, configura ALSA para la tarjeta USB y deja un servicio de systemd. Lista de materiales, cableado y primeros pasos en la guía de la Raspberry.
El MCP
cd worker && npm install
npx wrangler secret put DEVICE_KEY && npx wrangler secret put MCP_KEY
npx wrangler deploy
Luego pon LINK_URL=wss://<tu-worker>/device/connect?key=<DEVICE_KEY> en la Pi y apunta tu agente a https://<tu-worker>/mcp. Las tools que verá son las acciones que la Pi anuncia: si añades una acción en el dispositivo, aparece sola como tool. Detalles en la guía del MCP.
Probado
- 26 tests del dispositivo y 4 del servidor MCP, en CI con cada cambio. Dos de ellos pasan una llamada entera por el SDK real de ElevenLabs contra un servidor falso.
- Prueba de punta a punta en local: el Worker en
wrangler dev, el dispositivo con audio nulo conectado por el túnel,tools/listytools/calldesde fuera. La orden llega a la Pi y el rechazo de un color inválido vuelve al agente. - Montado en una Raspberry Pi 5 (Raspberry Pi OS trixie, Python 3.13) con un auricular USB y un agente de ElevenLabs: se descuelga y el agente contesta. De ahí salieron tres arreglos: los paquetes de plataforma de Blinka, el colchón de audio contra los cortes de wifi y el micro bajado un momento más tras cada frase.
- Sin probar en hardware todavía: el camino de Vidiv, el relevo entre proveedores, la tira de LED, la pantalla y el Worker desplegado. Ese código viene de TeleTUP, que funciona en ferias, pero esta versión más ligera aún no lo ha demostrado.
Privacidad
Por defecto el objeto no guarda transcripciones (STORE_TRANSCRIPTS=0) y la página de estado es de solo lectura. En un espacio público la gente no ha aceptado que la recuerden; si cambias eso, que sea a propósito y con aviso visible. Hay más en diseño de experiencias.
Estructura
talking-objects/
├── device/                    # Raspberry Pi
│   ├── talking_objects/       # app, audio, providers, devices, reactor, link, status
│   ├── tests/
│   ├── deploy/                # install.sh, servicio systemd, asound.conf
│   ├── config.example.env
│   └── rules.example.toml
├── worker/                    # Cloudflare Worker: MCP + relé
│   ├── src/                   # index.ts, mcp.ts, relay.ts
│   └── test/
├── examples/                  # cabina, objeto, sala
└── docs/                      # guías y figuras
Créditos
Diseñado y mantenido por Divina Machina by Qs Ventures (Cris Olmedo y Kurt Sommer). La voz llega con Vidiv y ElevenLabs; el transporte de Vidiv es LiveKit. Licencia MIT.
La máquina siempre estuvo ahí; la ponemos en conversación con lo humano.
Reviews (0)
Sign in to leave a review.
Leave a reviewNo results found