avoid-ai-writing-russian
Health Warn
- License — License: MIT
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 5 GitHub stars
Code Fail
- exec() — Shell command execution in evals/grade.ts
Permissions Pass
- Permissions — No dangerous permissions requested
No AI report is available for this listing yet.
Скилл для ИИ-агентов и CLI на TypeScript/Bun: находит и убирает ИИ-стиль в русских текстах (канцелярит, кальки, штампы), проверяет сохранность правки и оценивает текст по фрагментам в духе «Антиплагиата» с калибровкой по вашим отчётам. Русская адаптация avoid-ai-writing.
avoid-ai-writing-russian


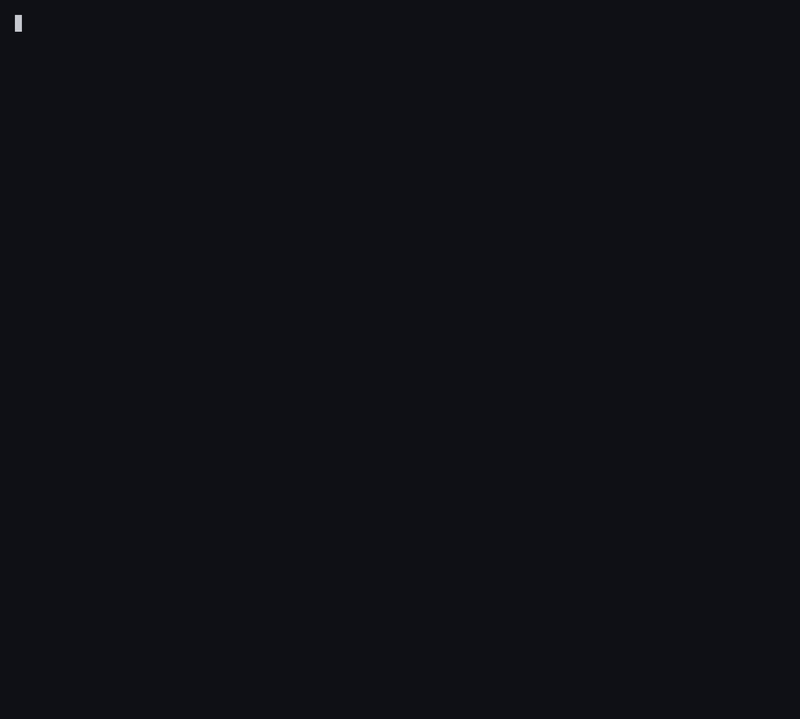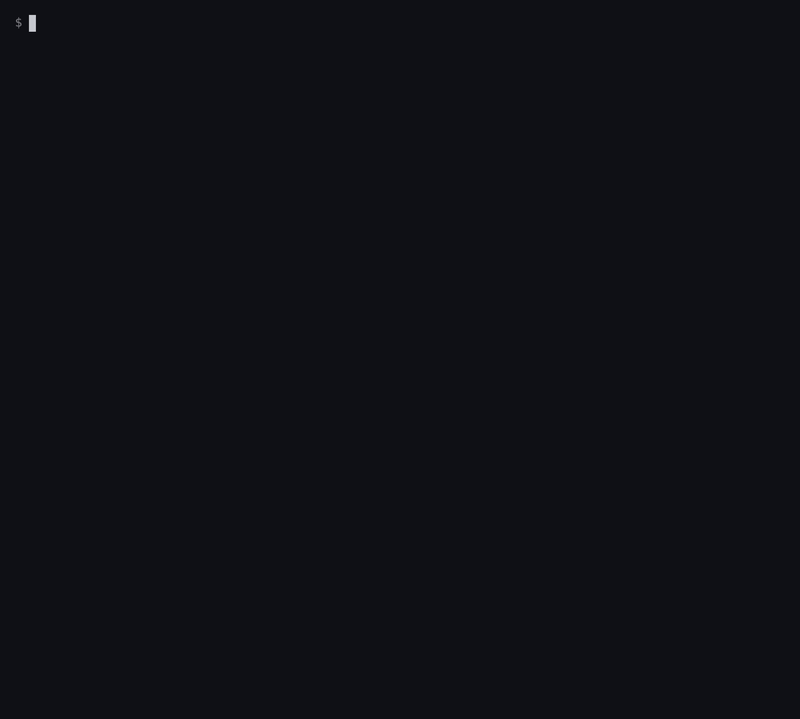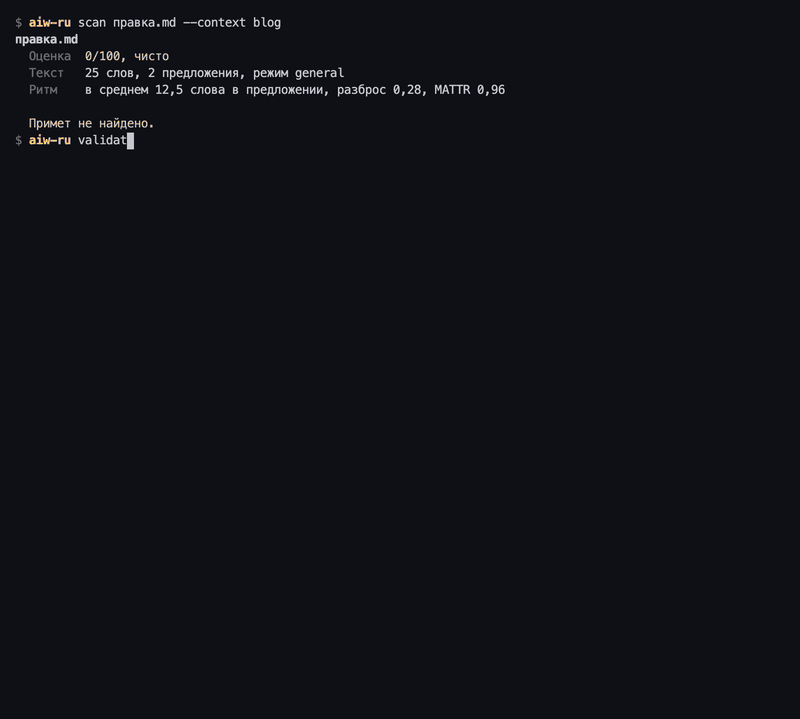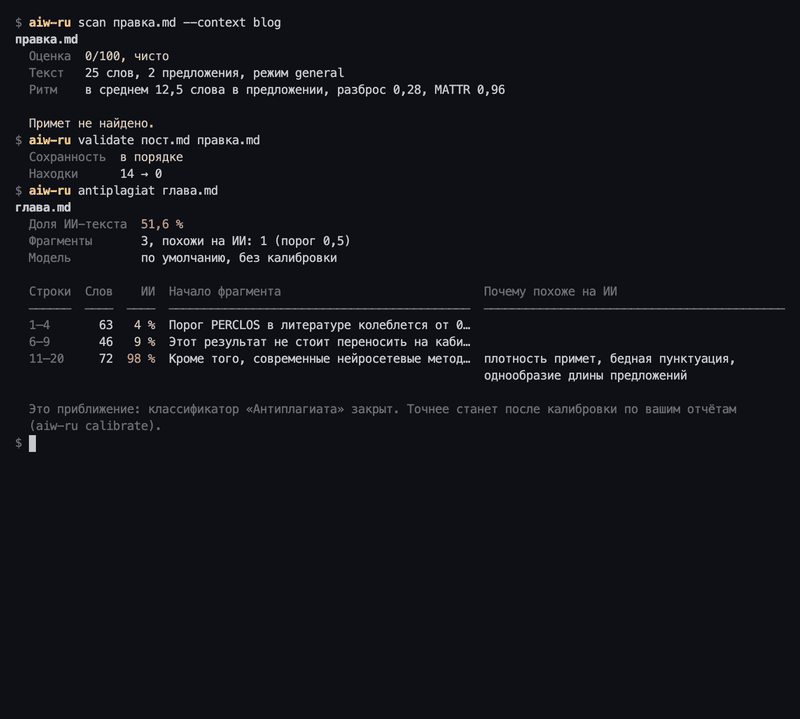
Скилл для ИИ-агентов (Claude Code, Codex, Cursor и других), который находит и убирает из русских текстов приметы машинной генерации: канцелярит, кальки с английского, «не просто X, а Y», тире-связки, одинаковый ритм предложений. К нему прилагается детектор на TypeScript для Bun и под-скилл antiplagiat, который оценивает текст по фрагментам в духе модуля ИИ-детекции системы «Антиплагиат».
Это русская адаптация avoid-ai-writing Конора Бронсдона. Устройство скилла взято оттуда, каталог примет переписан под русский язык, детектор написан заново. Подробности в разделе «Благодарности».
Содержание
- Зачем
- Пример
- Установка
- Как пользоваться
- Под-скилл antiplagiat
- Детектор
- Что ловит каталог
- Ограничения
- Разработка
- Выпуски
- Как сослаться
- Благодарности
- Лицензия
Зачем
Английские «очеловечиватели» на русском почти бесполезны. Они ищут delve и tapestry, а русский текст модели выдаёт себя другим: «является», «осуществляется», «в рамках данной работы», «играет ключевую роль», «на ежедневной основе», цепочками вроде «обеспечение повышения эффективности проведения мониторинга» и прямыми кавычками там, где нужны «ёлочки». Половина этого — канцелярит, которым люди писали задолго до нейросетей; модели выучили его из госдокументов и рефератов и воспроизводят с удвоенной частотой. Другая половина — синтаксис, протащенный из английского черновика, на котором модель «думала».
Скилл помогает двум группам:
- тем, кто хочет меньше ИИ-стиля в своих текстах: статьях, документации, постах, письмах;
- тем, чей текст пойдёт на проверку в «Антиплагиат» и кому не нужны ложные срабатывания модуля ИИ-детекции на собственном тексте.
Пример
До (типичный ответ модели на просьбу написать абзац про ИИ в медицине):
В современном мире искусственный интеллект играет ключевую роль в развитии здравоохранения. Данная технология открывает новые возможности для диагностики и лечения заболеваний. Стоит отметить, что внедрение ИИ осуществляется в рамках комплексного подхода к цифровой трансформации отрасли. Кроме того, нейросетевые модели позволяют значительно повысить точность диагностики. Исследования показывают, что такие системы обеспечивают высокую эффективность при анализе медицинских изображений.
Детектор: 98/100, «сильный ИИ-стиль». В пяти предложениях он нашёл размытую ссылку на авторитет («Исследования показывают»), пять слов-маркеров, две оценки без чисел, пять случаев канцелярита, шаблонный переход и скопление слов второго уровня.
После правки скиллом:
ИИ в медицине пока применяют в основном для анализа изображений и помощи в диагностике. Насколько такие системы точнее врача, в исходном тексте не сказано. Нужны цифры и ссылка на исследование, иначе утверждение не проверить.
Проверка: один проход. Скилл убрал разбег, штампы и пустые оценки. Число и источник он не выдумал, а пометил как пробел: исходник их не давал. Это правило «никогда не добавляй» из исходного проекта. Для научного текста оно важнее всего остального.
Установка
Claude Code: плагин
claude plugin marketplace add ormeilu/avoid-ai-writing-russian
claude plugin install avoid-ai-writing-russian@avoid-ai-writing-russian
Плагин ставит оба скилла, avoid-ai-writing-russian и antiplagiat, вместе с детектором.
Claude Code, Codex и другие агенты: папка скилла
Клонируйте репозиторий и скопируйте папки скиллов туда, где агент их ищет. Детектор лежит в корне репозитория, поэтому для команд bun ../../src/cli.ts … удобнее ссылка, а не копия:
git clone https://github.com/ormeilu/avoid-ai-writing-russian.git ~/src/avoid-ai-writing-russian
ln -s ~/src/avoid-ai-writing-russian/skills/avoid-ai-writing-russian ~/.claude/skills/avoid-ai-writing-russian
ln -s ~/src/avoid-ai-writing-russian/skills/antiplagiat ~/.claude/skills/antiplagiat
Для Codex используйте ~/.codex/skills/ или ~/.agents/skills/, для Cursor — правила проекта. Агентам без поддержки SKILL.md можно передать текст SKILL.md и references/patterns.md как инструкцию.
Детектор
Нужен Bun 1.1 или новее. Зависимостей во время работы у детектора нет, bun install нужен только для разработки. Без Bun скилл работает, но проверки будут только модельными, и он об этом скажет.
Собрать один исполняемый файл без зависимостей:
bun run build
Как пользоваться
Обычной фразой агенту:
- «убери ИИ-стиль из этого абзаца»;
- «просканируй
glava2.md, ничего не правь»; - «почисти
README.mdна месте, профиль docs»; - «перепиши прямее для Telegram-канала»;
- «подготовь главу к антиплагиату» (включается под-скилл).
Режимы: rewrite (по умолчанию, вернуть исправленный текст), detect (только найти), edit (править файл на месте точечными правками).
Профили контекста меняют строгость правил:
| Профиль | Для чего |
|---|---|
vak |
диссертация, автореферат, статьи ВАК/РИНЦ, отчёты по НИР |
docs |
документация, README, инструкции |
blog |
статьи, эссе, Хабр (по умолчанию) |
telegram |
посты в каналах и соцсетях |
business-email |
деловые письма, КП, письма инвесторам |
chat |
переписка и комментарии: только грубые приметы |
Профили голоса (casual, professional, technical, warm, blunt) задают звучание правки. Голос проявляет то, что уже есть в тексте, но не придумывает автору мнений и опыта.
Скилл сохраняет цитаты, код, формулы, таблицы, ссылки на литературу и числа. Правку он заканчивает отчётом: сколько было проходов, какие проверки запускались, какие находки оставлены и почему.
Под-скилл antiplagiat
Включается, когда текст идёт на проверку. Порядок работы:
- Замер: оценка доли «ИИ-текста» по фрагментам и список рискованных абзацев с причинами.
- Чистка технических артефактов: невидимые символы и латинские буквы внутри русских слов. Из-за них система помечает документ как подозрительный, и это хуже любого процента.
- Правка подсвеченных фрагментов по правилам основного скилла, в первую очередь ритма и пунктуации: классификаторы смотрят на структуру сильнее, чем на слова.
- Повторный замер и проверка сохранности формул, чисел и ссылок.
- Калибровка детектора по вашим реальным отчётам. Если модель ещё не откалибрована, агент сам попросит прошлые отчёты «Антиплагиата»: с ними оценка ближе к тому, что система скажет именно о ваших текстах. Всё считается локально.
Скилл работает с вашим собственным текстом. Заимствования он помогает оформить как цитирования (кавычки и ссылка на источник), чтобы система засчитала их законно. Маскировать чужой текст перефразированием, синонимайзером или подменой символов он не будет: это выдача чужой работы за свою, а не спор с плохим детектором.
Детектор
bun src/cli.ts scan статья.md --context vak
bun src/cli.ts antiplagiat глава1.md
bun src/cli.ts validate исходник.md правка.md
bun src/cli.ts calibrate --doc глава1.md --marked глава1-подсвечено.txt
bun src/cli.ts calibrate --doc глава2.md --share 34
scan печатает оценку 0–100, статистику ритма и таблицу находок: уровень P0–P2, строка и столбец, примета, фрагмент и подсказка. Таблица подстраивается под ширину терминала, длинный текст переносится внутри ячейки. Цвет включается только в терминале; NO_COLOR=1 его выключает, FORCE_COLOR=1 включает принудительно. Параметр --json даёт машиночитаемый вывод, --fail-above N возвращает код 1, если оценка выше N (удобно в CI для документации).
antiplagiat делит текст на фрагменты (абзацы, короткие склеиваются), описывает каждый семью признаками и переводит их в вероятность логистической моделью. Признаки: плотность примет, однообразие длины предложений, типичная для моделей длина предложения, канцелярит, бедная пунктуация, однообразные начала предложений, бедный словарь. Доля ИИ-текста считается по знакам, как в отчёте системы.
validate сравнивает исходник и правку. Код, формулы, URL, числа, ссылки [12] и [@key], таблицы, цитаты и структура заголовков должны остаться на месте, а находок должно стать не больше. Разрешённые правки нарушением не считаются: «ёлочки» вместо прямых кавычек, запятая вместо десятичной точки, удалённый utm_source=chatgpt.com.
calibrate дообучает модель antiplagiat на ваших отчётах. Лучше всего работает разметка фрагментов: текстовый файл с кусками, которые система подсветила как сгенерированные, по одному на абзац через пустую строку. Собирать его руками не обязательно: агент выпишет фрагменты сам из PDF отчёта или скриншотов. Если под рукой только итоговая цифра, передайте её через --share: так подстраивается общая строгость модели, но не веса признаков. Образцы накапливаются в .aiw-ru.json, и с каждым отчётом оценка точнее отражает поведение системы на ваших текстах. Отчёты, где система ничего не пометила, тоже пригодятся: это примеры человеческого текста. В файле калибровки только модель и числовые признаки фрагментов, самого текста там нет. В общий репозиторий его всё равно не коммитьте: antiplagiat читает .aiw-ru.json из текущей папки, и ваша калибровка исказит оценку соавторам (в этом репозитории файл уже в .gitignore). Текст есть в файлах с фрагментами из отчётов, их держите вне публичных репозиториев.
Из TypeScript:
// bun add github:ormeilu/avoid-ai-writing-russian
import { analyze, antiplagiat, validate } from "avoid-ai-writing-russian";

const result = analyze(text, { context: "academic" });
console.log(result.score, result.issues.length);
Что ловит каталог
Полный каталог — в skills/avoid-ai-writing-russian/references/patterns.md. Коротко:
| Группа | Примеры |
|---|---|
| Следы чат-бота | «Надеюсь, это поможет», «Отличный вопрос!», «как языковая модель» |
| Словарь уровня 1 | «является», «играет ключевую роль», «уникальный», «открывает новые возможности», «в современном мире» |
| Канцелярит (1Б) | «осуществляется», «данный», «в рамках», «в целях», «посредством» — совет по стилю, не довод об авторстве |
| Кальки | «адресовать проблему», «это про», «на ежедневной основе», «имеет смысл», «в моменте» |
| Синтаксис | «не просто X, а Y», цепочки родительного падежа, пассив без деятеля, навязчивые тройки |
| Авторитет и значимость | «исследования показывают», «эксперты считают», «знаменует новую эру», оценки без чисел |
| Соцсети | «И вот тут начинается самое интересное», «Сохраняйте, пригодится», «Встречайте:» |
| Типографика | тире-связки, дефис вместо тире, прямые и английские кавычки, десятичная точка, Title Case |
| Ритм | одинаковая длина предложений и абзацев, бедный словарь, одинаковые начала |
| Технические отпечатки | невидимые символы, подмена букв, [Вставьте источник], oaicite, utm_source=chatgpt.com |
Ограничения
- Приметы — это сигналы, а не доказательство авторства. Их выдают и люди, особенно в научном и канцелярском регистре. Не используйте детектор как единственное основание для решений об академической нечестности, найме или публикации.
- Как классификатор детектор слабый, и это видно по цифрам. На русской части тестового набора LLMTrace оценку «много примет» и выше получили 5,9 % из 21 417 человеческих текстов (у новостей 13 %) и 16,7 % из 14 064 сгенерированных. Больше половины сгенерированных текстов детектор счёл чистыми. Он показывает, что править в тексте, а не кто его написал.
- Модель
antiplagiat— приближение. Классификатор системы «Антиплагиат» закрыт. Веса по умолчанию подобраны вручную на небольших примерах, а не обучены на корпусе. Калибровка подстраивает веса под то, как система ведёт себя на ваших текстах, но точную цифру отчёта не гарантирует. - Морфология упрощена: основы со звёздочкой вместо полноценного морфологического анализатора. Редкие формы могут проскочить, омонимы могут дать ложное срабатывание.
- Регулярные выражения не видят смысла. Правила, которые требуют суждения (ложный деятель, бег на месте, выдуманный контраст), есть только в скилле, детектор их не ищет.
Разработка
bun install
prek install --hook-type pre-commit --hook-type commit-msg --hook-type pre-push
bun run check
bun run check прогоняет линтер и форматтер (Biome), проверку типов, тесты, самопроверку документации детектором и синхронность версий. Тесты покрывают разбор текста, каждое правило детектора, корпус живых и шаблонных текстов шести жанров, CLI, скрипты выпуска и сами скиллы: шапки SKILL.md, ссылки, связь разделов каталога с типами находок детектора, примеры из каталога.
Поведение скилла на живом агенте проверяет bun run eval: двенадцать случаев (защищённые цитаты, попытка внедрить инструкцию в текст, ловушка на выдуманные числа, режим только поиска и другие) с автоматической оценкой ответа. В CI этот прогон не входит.
Хуки prek перед коммитом проверяют гигиену файлов, секреты, формат, типы, невидимые символы и сообщение коммита (на русском); перед отправкой запускают тесты. Правила участия — в CONTRIBUTING.md, история изменений — в CHANGELOG.md.
Выпуски
bun run release patch
git push --follow-tags
Скрипт переносит раздел «Не выпущено» из CHANGELOG в новую версию, обновляет версию во всех манифестах, скиллах и CITATION.cff, делает коммит и тег. По тегу GitHub Actions собирает бинарники aiw-ru под Linux, macOS и Windows, архив скиллов с контрольными суммами и публикует выпуск с заметками из CHANGELOG.
Как сослаться
Если проект пригодился в исследовании, данные для ссылки лежат в CITATION.cff; GitHub показывает их кнопкой «Cite this repository».
Благодарности
Огромное спасибо Конору Бронсдону за avoid-ai-writing. Без этого проекта русской версии не было бы. Оттуда взяты режимы работы, договор о правке, уровни серьёзности, трёхуровневый словарь, профили контекста и голоса, самоисключение для текстов о приметах и правило «никогда не добавляй». Отдельно спасибо за то, что исходный проект честно называет свои находки сигналами, а не доказательствами, и держит это правило во всех решениях.
Спасибо авторам и участникам, на чьи находки опирается исходный проект и, через него, этот: blader/humanizer, brandonwise/humanizer, Aboudjem/humanizer-skill, isatimur/de-slop, welttowelt/stop-slop-refined, LLM cliché highlighter Саймона Уиллисона и tropes.fyi.
Русская часть многим обязана традиции борьбы с канцеляритом, которая старше нейросетей на полвека: Корнею Чуковскому, придумавшему само слово «канцелярит» в книге «Живой как жизнь», Норе Галь с её «Словом живым и мёртвым» и Максиму Ильяхову и Людмиле Сарычевой с книгой «Пиши, сокращай».
Лицензия
MIT. Copyright (c) 2026 Conor Bronsdon — исходный проект; Copyright (c) 2026 Ilya Lubenets — русская адаптация. Подробности о происхождении частей — в NOTICE.md.
Reviews (0)
Sign in to leave a review.
Leave a reviewNo results found