china-law-search
Health Uyari
- License — License: MIT
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 7 GitHub stars
Code Basarisiz
- rm -rf — Recursive force deletion command in .github/workflows/check.yml
Permissions Gecti
- Permissions — No dangerous permissions requested
Bu listing icin henuz AI raporu yok.
国家法律法规数据库全量条文落到本地:26,796 部法规、104 万条现行条文,SQLite + FastAPI + MCP,离线检索与引文核验。缺法规或条文有误请提 issue。
壹律法条 · China Law Search
把国家法律法规数据库(flk.npc.gov.cn)的条文落到本地,做成一个 SQLite 文件加一个 FastAPI 服务。
律师和法务可以用它检索法条、按条号定位、批量核验引文真假与时效,全程离线,也能自建和增量更新。
仓库里只有代码。数据包放不进 git(解压后 4.0 GB),改从 Release 分发,tools/fetch_data.py 一条命令下载完。
不想碰命令行的话,把
INSTALL.md第一节那段话整段复制给你的 AI
(WorkBuddy、Claude、ChatGPT、Trae 都行),它会自己检查环境、下载、装好、跑通验证,
最后把本地页面打开。你只在最后点一次「信任」。
用起来有四种方式,按习惯挑一种就行:
- 本地查询界面:双击启动脚本,浏览器里搜法条、按条号定位、批量核引文,完全离线。
这是最贴近律师日常办案的用法。 - 接进 agent(MCP):让 WorkBuddy、Trae、ZCode、Claude Code 自己查法条,
用条文支撑结论之前自动核一遍真假和时效。只依赖 Python 标准库,不装任何包。 - HTTP API:接进自己的办案系统、文书工具或其他工作流。
- 自建数据库:用内置流水线把官方 Markdown 解析入库,之后照增量包往下更。
现在能做什么
检索是关键词匹配,不是问答。底层用 FTS5 trigram 索引加 bm25 排序,装了向量库还能切到语义检索;
没装也能用,服务发现没有向量库会自动退回全文检索,三项功能都不受影响。
条文定位按「法律名称 + 条号」直取,82 和 第八十二条 都认,第八十二条之一 这类增补条也认。
引文核验可以一次贴一串,逐条回答库里有没有这条、是不是现行有效、有没有被修订过、
是不是原则性条款,省得一条条去翻。
被修订的旧条文不会删掉,标成失效留着,默认不返回,需要比对时打开开关才看得到。
另有一个 stdio 的 MCP 服务器,四个只读工具,WorkBuddy、Trae、Claude Code 等客户端接上即可使用。
这些功能都不碰外部接口,内网、断网机器上照样跑。
快速开始
下文命令写作 python3。Windows 上如果提示找不到该命令,换成 python。
Python 版本要求:3.10 或更高(整个仓库统一按这个口径)。
macOS 自带的 3.9 不够用,另建一个独立虚拟环境即可,不动系统 Python ——
完整命令见INSTALL.md3.1。
一、接进 agent(不需装任何依赖)
git clone https://github.com/tlgzs/china-law-search.git
cd china-law-search
python3 tools/fetch_data.py            # 下载数据包并校验
python3 mcp/install.py --all --yes     # 写入本机 agent 配置
MCP 服务器只用 Python 标准库,不需要 pip install 任何东西;Python 需要 3.10 以上。
装完在 WorkBuddy 的连接器页点「信任」,Trae 和 Cursor 重启客户端即生效。
四个工具怎么用见 mcp/README.md。
跑通验证:
python3 mcp/server.py --selftest
二、本地查询界面
要 Python 3.10 以上和三个 Web 依赖(fastapi、uvicorn、pydantic)。装好数据后直接双击:
启动.command     # macOS
启动.bat         # Windows
脚本会自己建虚拟环境、装依赖、等服务就绪再打开 http://127.0.0.1:8001,
端口被占用就顺延,最远到 8010。命令行里 ./start.sh 效果一样。
首次启动前会检查 Python 版本。系统自带的 3.9 不够用时,它会给出装独立 3.12 的完整命令,
不会抛栈,也不会去改系统 Python。项目自己建的虚拟环境在 .venv/,删掉它是安全的。
也可以手动起:python3 -m uvicorn server.law_search_service:app --port 8001。
打开后三个页签,对应三种场景:只记得关键词、已经知道条号、手里有引文要核。
检索框可以用 ⌘K 或 Ctrl+K 聚焦,首屏放了八个常用查询,点了就搜,底部一直显示当前数据版本。
服务默认只听 127.0.0.1,同一局域网的其他机器连不上。
详细用法见 INSTALL.md 第五节。
语义检索是可选的,要另装 requirements-vector.txt(会连带 torch,2 GB 往上),
不装就保持全文检索,功能上不缺什么。
三、Docker
docker compose up -d
数据目录 ./data 挂进容器。先跑一次 python3 tools/fetch_data.py,或者把下载好的库直接放进去。
数据不在仓库里
全量库解压后 4.0 GB,早就超过 git 的单文件上限,所以仓库只放代码,数据走 Release。tools/fetch_data.py 一条命令包办下载、校验、解压、就位:
python3 tools/fetch_data.py            # 没库就下全量;有库则比对版本,有新才下
python3 tools/fetch_data.py --check    # 只看版本,不下载
python3 tools/fetch_data.py --full     # 强制重下全量
下载的东西不会被盲目覆盖。先解压到临时文件,校验 sha256 和数据库完整性,都通过了才替换,
旧库留一份 .bak。
网络下不动 GitHub 时,用浏览器把 Release 附件下回来,再走本地安装:
python3 tools/fetch_data.py --from-file 下载到的 law_data-xxx.db.zst
--from-file 也认 .gz。两种格式内容一致,.gz 稍大,但解压不需要额外装任何东西。
如果你是直接下 ZIP 包、没用 git clone,解压出来的目录里没有 .git,fetch_data.py 猜不到该从哪个仓库下载,会直接报错退出。显式指定一下就行:
python3 tools/fetch_data.py --repo tlgzs/china-law-search
自己 fork 过、想从上游取数据时,也用这个参数。
国内下载慢或连不上 GitHub
可以配置国内镜像。把多个源写进 LAW_DATA_MIRRORS(空格、逗号、分号都行),
脚本按顺序尝试,任一源失败自动换下一个,每个文件都按 manifest 里的 sha256 校验,
校验不过视为该源失败,最后仍回落 GitHub:
export LAW_DATA_MIRRORS="https://gitee.com/你的账号/china-law-search-data/raw/master"
python3 tools/fetch_data.py
镜像目录里放 manifest.json 和全部资产文件,文件名与 manifest 的 artifacts[].name 一致。
所有源都失败时,脚本会打印已尝试的源、官方 Release 地址和手动下载后的本地安装命令,
不会只抛一段栈(LAW_DATA_MIRROR 单数形式也认)。
将来想加源,只需把这个地址追加进 LAW_DATA_MIRRORS,无需改代码;
不设置该变量时脚本只走 GitHub,不做额外的镜像探测,行为和没有镜像机制时完全一样。
数据从哪来
法规文本来自国家法律法规数据库(flk.npc.gov.cn)公开下载的 Markdown 文件。
这属于官方文件,可以自由使用与再分发。
需要说清楚的是,这个仓库不提供任何自动采集代码,也不建议有人去对那个站点做批量抓取,
站方的 robots.txt 明确禁止自动化采集。数据包由维护者线下更新后发布,
使用者只从本项目的 Release 下成品。
覆盖范围
按现行有效版本统计,共 26,796 部法规、1,037,162 条条文:
| 分类 | 部数 | 说明 |
|---|---|---|
| 地方性法规 | 15,346 | 省级、设区的市、自治州、自治县、经济特区 |
| 地方政府规章 | 7,599 | 省、市政府令 |
| 部门规章 | 2,360 | 国务院各部委令 |
| 行政法规 | 585 | — |
| 司法解释 | 362 | — |
| 法律 | 302 | 按库内现行有效版本计,不含已废止的历史文本 |
| 修改决定 | 227 | 「关于修改《X》的决定」按修改项单独收录,与母法分开,免得混进母法检索结果 |
| 法律解释 / 监察法规 / 宪法 | 12 / 2 / 1 | — |
此外还有 344,052 条被修订或废止的历史条文,标着 repealed 和失效日期,默认不返回。
加上前面那 1,037,162 条和下面要说的 5,114 条待生效,库内一共 1,386,336 条,
用 --selftest 自检时看到的也是这个数。
待生效的有 5,114 条,分属 130 部法规,都是已经公布、施行日还没到的。其中 19 部属于「旧版仍然有效、
新版等着施行」,《商标法》就是:2019-11-01 施行的现行版照用,2026-06-26 公布的新版要到
2027-01-01 才生效。另外 111 部是全新的法,库里还没有现行版,《医疗保障法》
《事业单位登记管理条例》《四川省养老服务条例》都在其中,这 111 部占 4,177 条。
这也是为什么上面那张表合计 26,796 部,而库里实际有 26,951 部。差的 155 部里,111 部是这类
待生效的新法,另外 44 部已经被废止决定终止了(条文仍留在库里,标着 repealed,查得到
历史文本,但不再计入现行)。
条文都已经入库,检索查得到,只是不能当现行依据引用:结果会带琥珀色的
「尚未生效 · 某日施行」标签,引文核验也会直接拦一句「不得作为现行有效依据引用」。
状态靠施行日期和当天比较得出,到日子自动转成现行,不需要谁去改。
一部法改了、新版还没施行的时候,新旧两版在库里是并存的。旧版仍然是 effective,
是此刻该引的文本;新版是 pending。到施行日当天,旧版才转 superseded,条文标 repealed。
查条文和检索都按「现行 > 已公布未生效 > 历史」取版,同一条文不会返回两次。
条文收录截至 2026-11-06,也就是库内最新一部法规的公布日期。这个日期记在 data_cutoff 里,
和 corpus_version 是两回事:版本号说的是哪天打的包,截止日说的是条文收到哪一天。
有几类内容不在库里,官方数据库本身也不收录:
- 军事法规、党内法规、国际条约
判断某条引用能不能在这里核验,先看它是不是上面这几类。
增量补丁的来源与核对
2026-07 以后公布的法规,通过第三方镜像 lawtext/legal-data-docx 取原件
(它的上游还是国家法律法规数据库),个别「重新公布」的文本以中国人大网转载稿作核对基准。
每一部入选的法规都要过四关:提取公布与施行日期、切分条文、和库内同名现行版本逐条比对、
生成变更报告人工过一遍,然后才写库。镜像里比库内更旧的历史文本一律不采用,
在报告里单列成 stale,否则会出现用 2014 版顶掉 2018 版这种静默倒退。
版本与校验
数据以 GitHub Release 附件发布,tag 和版本号一致,形如 data-2026.11.20.1:
law_data-<版本>.db.zst/.gz:全量库,两种压缩格式内容一致delta-<版本>.json.zst/.gz:增量变更集,只装变过的那几部法,外加整部废止的法规清单manifest.json:版本号、条数、db_sha256,以及各资产的 sha256 与适用版本
发布新数据版本时,Release 里保留上一版一个,更早的退役,不追求留存全部历史版本。
退役只影响下载入口,已经装到本地的库不受影响,仍可照常使用。
每个响应都带 data_snapshot.corpus_version,标明这批数据截至哪一版。
数据是快照,不是实时库,涉及时效敏感的案件请以官方发布文本再复核一次。
本地查询界面
服务起来后打开 http://127.0.0.1:8001,三个页签。
「法条检索」输入关键词即可,勾上「含已被修订的旧版本条文」能一并看到历史条文,
失效版本带红标、排在现行条文后面,检索完会告诉你命中多少条、花了多久。
「条文定位」填法律名称和条号,增补条在第三栏填 之一。
「引文核验」一行一条引文,比如 《劳动合同法》第八十二条,一次核完;
一行里写并列引文(第八十二条、第八十七条)会自动拆成两条分别核,不会只核第一条。
界面完全离线,不加载任何外部资源。底部常驻显示数据版本,写进意见书之前扫一眼,
心里有数自己引的是哪一版。
三张图依次对应上面三个页签(截图时数据版本 2026.10.31.1):
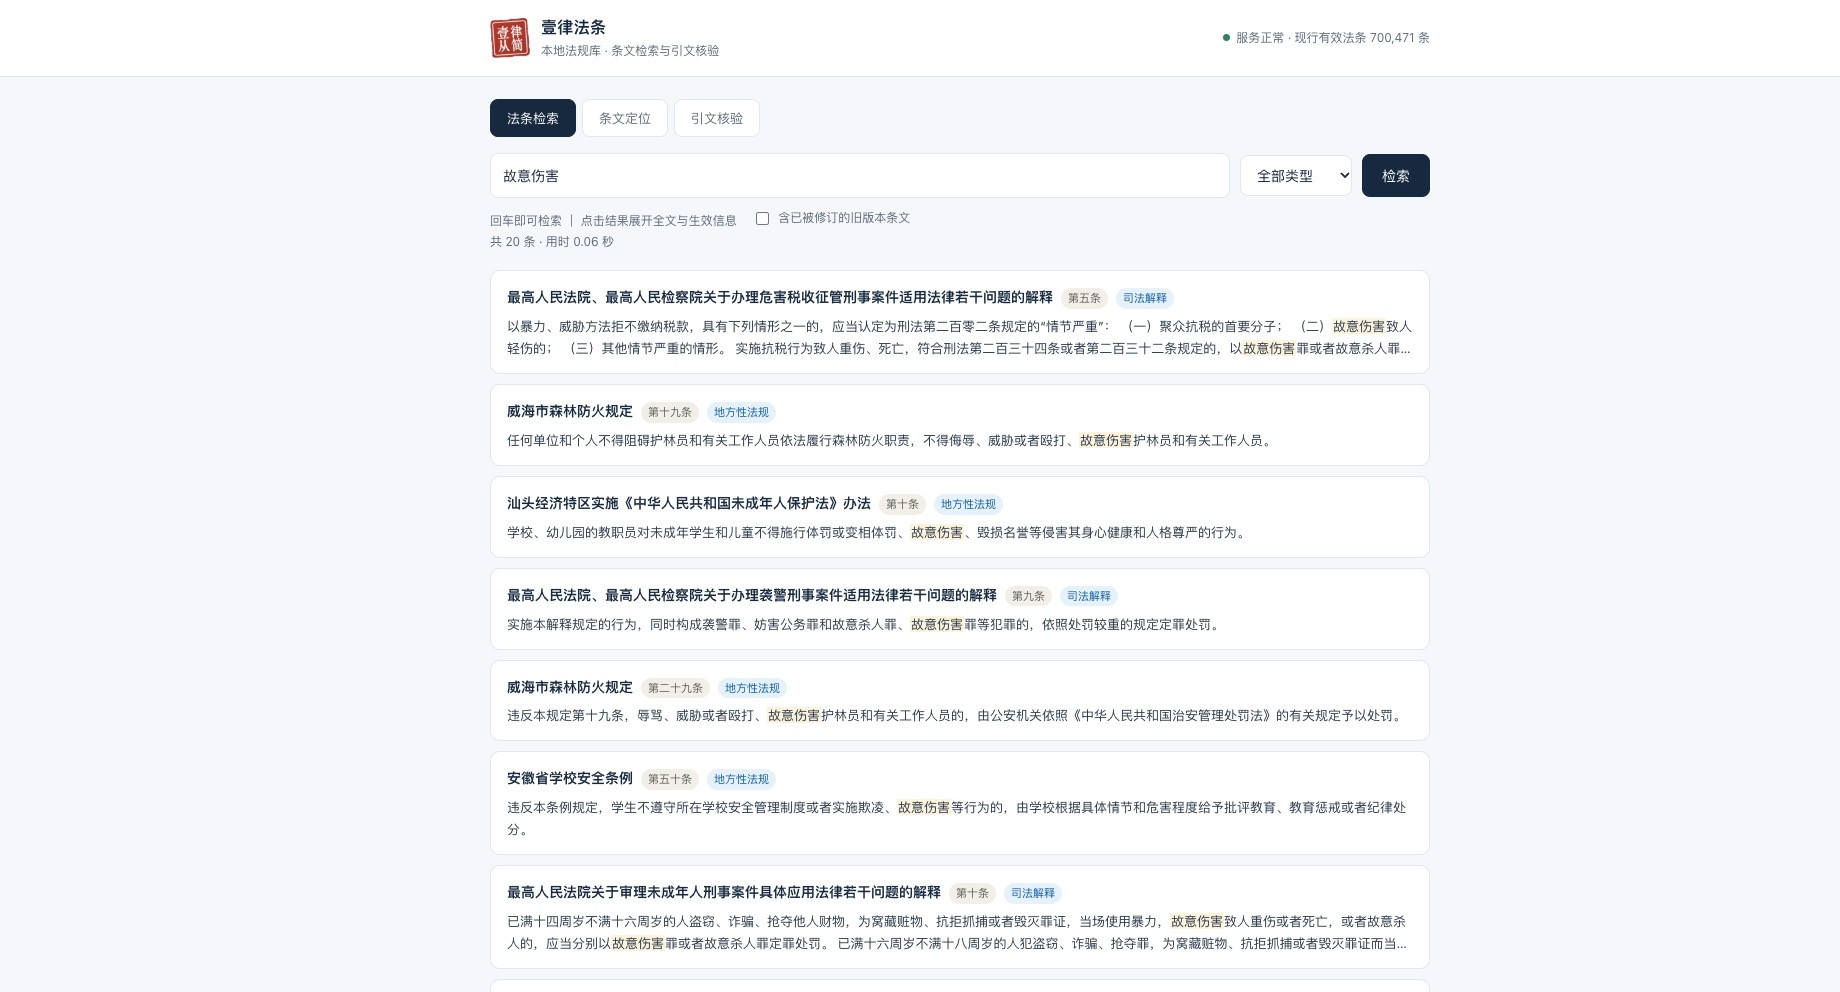
法条检索:命中条数与耗时直接显示,旧版条文可一并调出,带红标排在现行条文之后
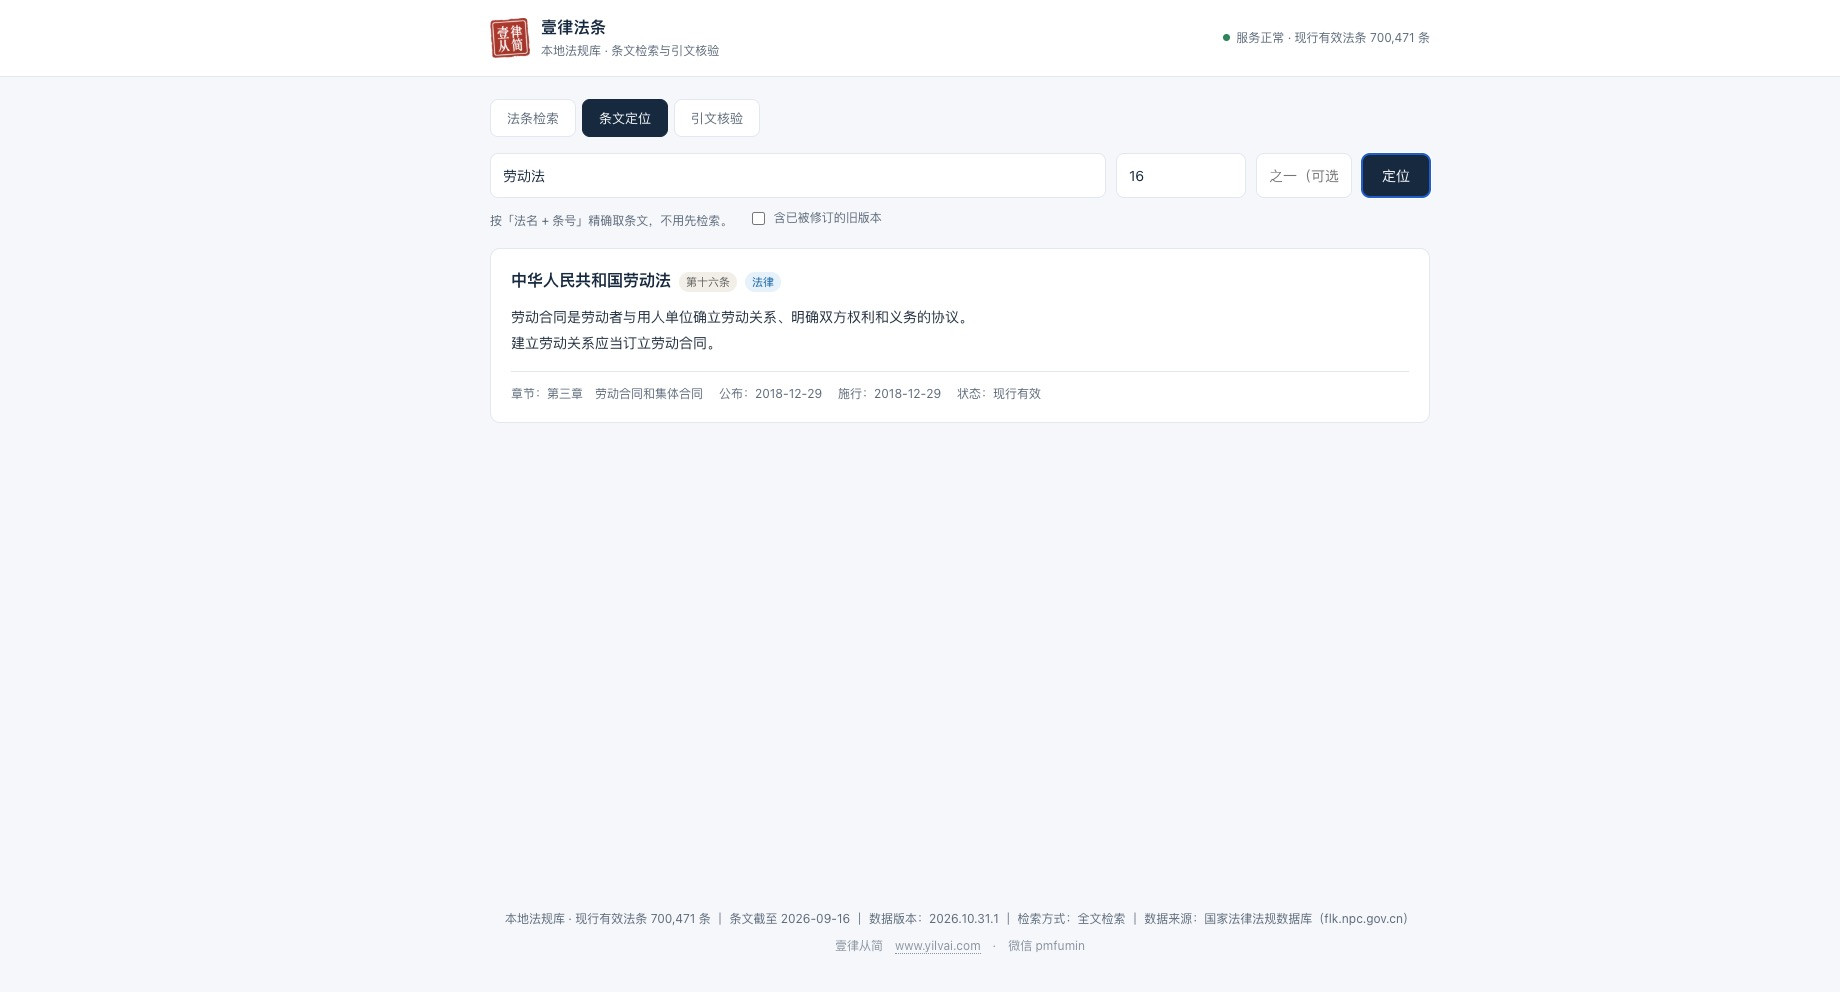
条文定位:法名 + 条号即可,下方给出章节归属、公布与施行日期、现行状态
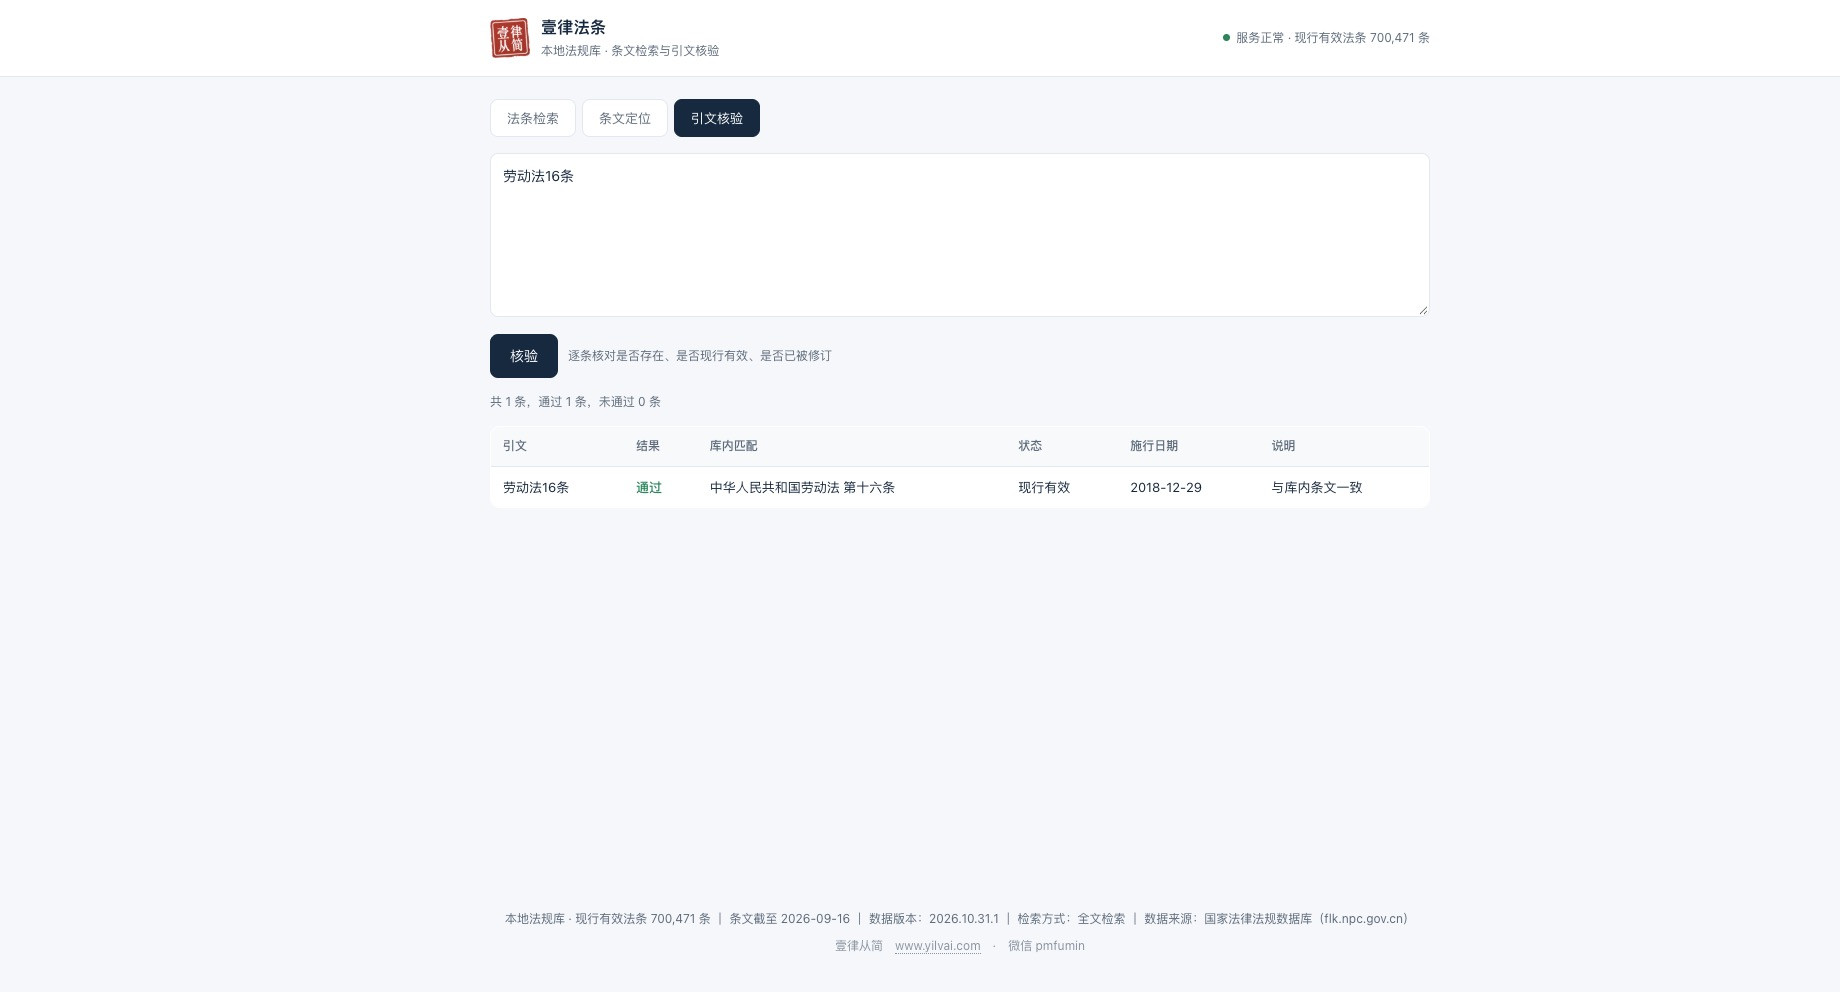
引文核验:逐条列出是否命中、命中哪一条、现行是否有效、是否与库内条文一致
接入 agent(MCP)
不想复制粘贴,就让 agent 自己查。内置的 MCP 服务器提供四个只读工具:
| 工具 | 作用 |
|---|---|
get_article |
法名 + 条号 → 逐字原文(支持「之一」增补条) |
get_law |
法名 → 章节目录 + 版本沿革 + 条文 |
search_articles |
多关键词 → 候选条文(字面匹配,不做语义理解) |
verify_citation |
一段引文 → 是否逐字命中、命中的是否现行版本 |
python3 mcp/install.py --list              # 看本机装了哪些客户端
python3 mcp/install.py --all --yes         # 写入(默认只预览,加 --yes 才落盘)
python3 mcp/server.py --selftest           # 装完自检
安装器认得 WorkBuddy、Trae、ZCode、Claude Code、Codex、Cursor、Cline、Windsurf,
会自己探测配置位置、备份原文件、合并写入,不动别人已有的 MCP 条目。
有两件事得先知道,否则会以为没装上。一是写进配置文件不等于生效,WorkBuddy 要去连接器页
点「信任」,Trae 和 Cursor 要重启,这些脚本做不到,逐步说明在 mcp/README.md。
二是 MCP 直连 SQLite,不需要先把服务起起来,agent 自己拉起子进程,用完即退;
这也是它只要标准库、不装 mcp SDK 的原因。
API
认证不在本项目范围:服务不校验任何凭据,本地自用直接调用即可。
如需公网暴露,请在自己前置的反向代理或网关做认证与限流。
如需托管版(账号与 API Key 管理),见 https://www.yilvai.com
GET /health
返回服务状态、法条总数、现行有效条数、向量库是否启用。
GET /api/law/search
| 参数 | 必填 | 说明 |
|---|---|---|
q |
是 | 查询词 |
k |
否 | 返回条数,默认 10,上限 50 |
type |
否 | 法规类型过滤,如 law、administrative_regulation |
include_history |
否 | true 时包含已失效的旧版本条文 |
curl -G http://127.0.0.1:8001/api/law/search \
  --data-urlencode "q=未签书面劳动合同" \
  --data-urlencode "k=5"
检索走三级策略,一级不通就退到下一级:先走 FTS5 trigram 索引按 bm25 排序,
不中再按字面包含匹配,还不行就把查询拆成两字片段,命中多数片段即召回。
中文不靠分词也能兜住改写。返回的 engine 字段说明实际走了哪条路,items[].score 是 0 到 1 的相关度。
GET /api/law/article
| 参数 | 必填 | 说明 |
|---|---|---|
law_name |
是 | 法律名称,支持简称模糊匹配 |
article_num |
是 | 条号数字 |
article_suffix |
否 | 增补条后缀,如 之一 |
include_history |
否 | 是否返回已失效版本 |
curl -G http://127.0.0.1:8001/api/law/article \
  --data-urlencode "law_name=劳动合同法" \
  --data-urlencode "article_num=82"
POST /api/law/verify
curl -X POST http://127.0.0.1:8001/api/law/verify \
  -H "Content-Type: application/json" \
  -d '{"citations": ["《劳动合同法》第八十二条", "刑法第一百三十三条之一"]}'
每条结果带 verified、status、effective_date、repeal_date、replaced_by、is_principle_clause、has_multiple_versions。最后一个只在同一部法规确实存在多个版本时为真,
不会因为法规名相近就误报。
status 为 pending 或 repealed 时 warning 会给出一句直接可用的提示:前者是
「已公布但尚未生效」,后者是「该法规已于某日废止,依据是某决定」。两种情况都是verified=false 或带警示,别当现行依据引用。
查已废止的法规时,/api/law/article 返回 error=law_repealed 并带上 repeal_date、repeal_reason,不给正文。要读历史文本加 include_history=true。
GET /api/law/stats
返回按法规类型分组的条数统计、现行有效条数、向量库状态。
GET /api/law/update-status
查数据和程序版本,带缓存(默认一小时),?force=true 强制联网。
返回 data(local、remote、has_update、mode、size_text)和app(local、remote、has_update、url)两组字段。
curl http://127.0.0.1:8001/api/law/update-status
POST /api/law/update-data
下载并安装数据更新,增量优先,失败回落全量。这个接口只允许本机调用:
更新会改用户本地的库,网页要是被反向代理到公网,不能让谁都能触发。
经代理转发的请求 client.host 是代理地址,正好被 403 挡在外面。
同一时刻只允许一个更新在跑,并发请求返回 409。
自己建库
ingest/ 是一条完整流水线。解析和建库只用标准库,不需要装任何包,
只有第三步建向量索引才要 pip install -r requirements-ingest.txt。
# 1) 把官方下载的 doc/docx 转成 Markdown(需要系统装 pandoc 与 libreoffice)
python3 ingest/convert_docx_batch.py --input-dir ./raw --output-dir ./md

# 2) 解析条号与章节,写入 SQLite(唯一真源),同时建 FTS 索引
#    默认每部法规只取最新版本;要连历史版本一起入库加 --keep-history
python3 ingest/build_sqlite_from_markdown.py --markdown-dir ./md --output-path ./data/law_data.db

# 3) 可选:构建向量索引,启用语义检索
python3 ingest/ingest_to_vectordb.py --markdown-dir ./md --db-path ./data/legal_vector_db
SQLite 是唯一真源,向量库只是可以随时重建的索引,坏了不影响数据。
增量更新
这一节讲的是维护者怎么把新法规弄进库。如果你只是想让自己的库跟上最新,
不用看这里,翻到下面的「用户侧升级」,一条命令的事。
法规会修订,库得跟着走。把下到的新版文件丢进 inbox/:
# 第一步:扫描 → 转换 → 解析 → 比对 → 出报告(只出报告,不写库)
python3 tools/update.py --inbox inbox/

# 打开 reports/changes-<时间>.html 逐条看:新增条、修改条(左右对照)、删除条、元数据变更

# 第二步:确认无误后写库
python3 tools/update.py --apply reports/changes-<时间>.plan.json --approve
这里刻意留了一道人工闸门:没有 --approve 绝不写库。法条改动直接影响律师引用,
不能自动生效。
写库是单事务完成的:新版本插入,旧版本标为已失效并记下失效日期与被替代关系,
同时写一条 ingest_batches 审计记录。同一个文件重复投放不会重复入库,按文件 sha256 去重。
流水线的完整设计,包括比对口径、版本模型和校验项,见 docs/UPDATE-PIPELINE.md。
提交新法规 / 条文纠错
缺法规、条文有错、版本不是最新,都可以提,不用会写代码。
只报缺的话,用提交新法规
表单提个 issue,写清法规全名和官方页面链接就够了。手上有原件更好,把官方下载的.docx 或 .md 直接拖进 issue,原件比任何描述都管用——维护者会用自己的管线重新解析、比对、出报告,
不采用外部生成的数据库或补丁包。想连比对结论一起交,本地跑一遍python3 tools/update.py --inbox inbox/,把生成的 plan.json 附上,它只作参考,不会被直接写进库。
两条要求:原件得来自国家法律法规数据库或其原始镜像,不从门户网站的转载稿里取;
法条文字一律不改写、不补标点。完整流程和会被拒的情形见CONTRIBUTING.md。
另外别交整库 .db,也别接受别人私下发的 delta-*.json 包。apply_delta.py
只校验格式、不认来源,包里的内容没有人替你核过。
发版
# 1) 把本次变更并入账本,并打出累积增量包(一次发版可传多份 --plan,按顺序并账)
#    --base-db 指上一版全量库快照,只导出相对它有变化的版本;
#    不给这个参数会把账本里一万多部法的全文都打进包,体积从几 MB 变成数百 MB。
python3 tools/make_delta.py --plan reports/changes-2026xxxxxxxx.plan.json \
    --base-db data/law_data.db.bak-<上一版> --out dist/delta-<版本>.json

# 2) 打包全量库 + 增量包 + manifest(同时产出 .zst 与 .gz)
python3 tools/make_release.py --db data/law_data.db \
    --delta dist/delta-<版本>.json --out-dir dist/

# 3) 上传为 Release(需已安装 gh 并登录)
gh release create data-<版本> dist/* --title "数据 <版本>" --notes "法规 N 部 / 法条 N 条"
make_delta.py 会顺带扫一遍全库,把「一条现行版都不剩」的法规作为废止清单写进包,
不用另外跑什么。输出里会单列一行,如「另含 44 部整部废止」。
增量包是累积的,不是每版配一个。state/change-ledger.json 记着自首个 Release 起
所有改过的法规;发版时以上一版全量库为基线(--base-db)导出真正变过的那几部,
把每部法的最终态全文打进包。所以用户的库停在哪一版都只下这几 MB,
不用逐版追。同一部法改过多次,包里也只存最终那一份,体积随「本轮改过多少部法」涨,
不随发版次数叠加。
包里会带两类版本,缺一类用户就补不全。一类是现行版(effective),另一类是已公布待生效版
(pending)。后者必须带:全新法在施行日之前没有现行版,漏掉它这部法就永远补不到
(《医疗保障法》2027-01-01 才施行);旧版仍生效、新版待施行的(《商标法》),两版都得带,
否则用户看不到已经公布的修订。到施行日由 refresh_pending_status 自动翻成现行,用户不用再下一次。
还有第三类,前两类装不下:整部废止。一部法被废止决定终止后,一条现行版都不剩,按「取现行版」
的逻辑它就成了「库里没有这部法」,简单地跳过;结果走增量的用户会一直留着一部已废止的「现行法」,
比不更新更糟。所以包里有独立的 repealed 数组,一部法一条记录,只写名称、废止日期和依据决定,
不带正文——接收端要做的是把本地那部法降级、条文标 repealed,一个字的正文都用不上。
这 44 部合计 2,551 条正文,塞进去会把包撑到 5 MB 以上,而实际只多了几 KB。
本地根本没装这部法的人,这条记录直接跳过,不会凭空多出一部废法。
拿 2026.11.20.1 这版做参考:相对上一版真正变过的 85 条版本、3,333 条正文,
再加 44 条废止标记,未压缩 5.1 MB,gz 0.6 MB,zst 0.4 MB。同期的全量库是
gz 1,345 MB、zst 1,080 MB。装过 2026.11.11.1 这版库的用户,这次只需要下 0.4 MB。
废止标记几乎不占体积:44 条记录几十 KB,而它们的 2,551 条正文如果要传,得多出 5 MB 以上。
发版机磁盘紧张也不怕。make_release.py 用硬链接指向原库再压缩,不会真复制一份 4.0 GB
出来;跨文件系统时自动退回复制,并提示预留空间。
顺序不能颠倒,得先跑 make_delta.py 再跑 make_release.py。前者顺带更新账本,
跳过它直接打包,增量包内容会和账本对不上。make_release.py 会核对增量包的 to_version
和本次全量库版本,不一致直接拒绝——那说明增量包是用旧库打的。
两种压缩格式都要发,不是冗余。用户机器上可能既没有 zstandard 库也没有 zstd 命令,
那时只能退回 .gz,而 gzip 是 Python 内置的。只发 .zst 会让这类人装不上数据。
没装 gh 时怎么发
gh 不是必装的,网页上操作等价:
- 仓库右侧 Releases → Create a new release
- Choose a tag 填
data-2026.11.20.1,Target 选main(点「Create new tag on publish」) - Release title 填
数据 2026.11.20.1,正文写变更摘要 - 把
dist/里五个文件全部拖进附件框:manifest.json、law_data-*.db.gz、law_data-*.db.zst、delta-*.json.gz、delta-*.json.zst - Release label 保持
None - 点 Publish release
有两处特别容易出错。文件名一个字都不能改,必须和 manifest.json 里 artifacts[].name
逐字一致,否则用户端挑不到资产;漏传增量包不会报错,但所有人都被推去下几百 MB 全量,
这版等于白发。另外不要勾 Pre-release,fetch_data.py 走的是 /releases/latest,
GitHub 会跳过预发布,勾了之后所有用户下载都会报「这个 Release 里没有 manifest.json」。
还有个小地方:首个 Release 没有「Set as the latest release」这个勾选项,发布后自动成为 latest;
从第二个 Release 起才出现,那时候必须勾上。
浏览器传大文件失败的话,用 token 补传,只要 repo 权限的 classic PAT:
RID=$(curl -s -H "Authorization: Bearer $TOKEN" \
  https://api.github.com/repos/tlgzs/china-law-search/releases/tags/data-2026.11.20.1 \
  | python3 -c "import json,sys;print(json.load(sys.stdin)['id'])")

for f in manifest.json law_data-2026.11.20.1.db.gz law_data-2026.11.20.1.db.zst \
         delta-2026.11.20.1.json.gz delta-2026.11.20.1.json.zst; do
  curl -X POST -H "Authorization: Bearer $TOKEN" \
    -H "Content-Type: application/octet-stream" \
    --data-binary @"dist/$f" \
    "https://uploads.github.com/repos/tlgzs/china-law-search/releases/$RID/assets?name=$f"
done
发布后核对 python3 tools/fetch_data.py --check 能读到版本,再核对附件大小和 dist/ 一致。
用户侧升级
三种入口装的是同一个东西,按习惯挑一个:
python3 tools/check_update.py           # 只查,不装(会同时报数据和程序版本)
python3 tools/check_update.py --update  # 查 + 装
./update.sh                             # 同上,自带环境探测
macOS 上也可以直接双击 更新数据.command,跑完窗口会停住让你看结果。
看到「程序 A → B」这类提示,先 git pull 再装数据。顺序反了会直接失败:
2.3.1 之前的 install_delta() 只认 .gz,而下载时优先挑体积更小的 .zst,
旧程序拿到 .zst 增量包会抛 UnicodeDecodeError: 'utf-8' codec can't decode。
这个缺陷 2.3.1 已修,用旧版本的人先拉一次代码就没事了。
网页顶部也会提示。服务启动时在后台查一次,不阻塞启动,断网也不影响用,结果缓存一小时。
查到新版就在检索框上方亮一条琥珀色提示条,写明「本地 → 线上」和增量包体积,
点「立即更新」才装;点「×」记在浏览器本地,同一版本不再弹。
发现有新版本:法规库 2026.11.11.1 → 2026.11.20.1,增量 0.6 MB;
              程序 2.3.0 → 2.4.0(git pull 后重启)
数据和程序是分开的,数据会自己装,程序不会。程序更新改的是 Python 源码,
只能 git pull 后重启服务——用户本地可能还有没提交的改动,自动拉取会把它们冲掉,
所以这里只提示,不动手。当前程序版本记在仓库根目录的 VERSION 文件里,服务、发版脚本和更新检查都读它。
不想开网页、也不想手动跑,启动前设个环境变量:
export LAW_AUTO_UPDATE=1 # 启动时查到有新版就直接装完,网页只显示结果
判断规则很直白:数据看 Release 里 manifest.json 的 corpus_version,程序看 tag app-v*。
两者之所以分开,是因为程序改个错别字不该逼着所有人重下一个六百多 MB 的数据包。
| 本地 vs 线上 | 行为 |
|---|---|
| 本地 = 线上 | 「已是最新」 |
本地 < 线上,且本地不早于增量包的 min_version |
下增量(几 MB) |
本地 < 线上,但本地比 min_version 还旧 |
下全量(1.1–1.3 GB) |
| 本地 > 线上 | 提示「本地比发布版新(开发态)」,不动 |
增量这条路任何一步不通,比如格式不认、解压失败、校验不过,都会自动回落全量,
不会把人卡在报错上。增量应用大约 100 秒,其中九十多秒花在重建一百万条的全文索引上,
而且只有真的写入了新法规才重建。
想自己控制时点,可以单独用这两个:
python3 tools/apply_delta.py --delta dist/delta-<版本>.json.gz
python3 tools/fetch_data.py --from-file 手动下载的包      # 离线安装
网络受限、只放行 api.github.com 而 github.com 被墙的情况不需要额外配置,
读取 manifest.json 和下载附件都会自动改走 API 资产接口重试一次。
目录结构
INSTALL.md                     装不上、打不开先看这份(含「发给 AI 的一段话」)
server/
  law_query_core.py            法条查询内核(纯 sqlite3,HTTP 与 MCP 共用同一套规则)
  law_search_service.py        HTTP 服务(检索 / 定位 / 核验 / 统计)
mcp/
  server.py                    MCP 服务器(stdio,四个只读工具,零第三方依赖)
  install.py                   各客户端安装器(探测 / 备份 / 合并写入 / 移除)
  README.md                    各家客户端的配置位置与坑
web/index.html                 本地查询界面(单文件,零外部依赖)
ingest/                        建库流水线
  schema.py                    表结构与迁移(幂等,老库自动补列)
  build_sqlite_from_markdown.py  Markdown → SQLite + FTS
  parse_markdown.py            解析条号、章节、元数据
  dedup_old_versions.py        历史版本去重
  ingest_to_vectordb.py        构建向量索引(可选)
tools/
  fetch_data.py                下载 / 校验 / 安装数据包(用户侧)
  check_update.py              查数据与程序版本(命令行与网页共用同一份判断)
  update.py                    增量更新主程序(出报告 / 确认写库)
  diff_articles.py             条文级比对 + HTML 报告
  make_delta.py                生成累积增量包(顺带更新变更账本)
  apply_delta.py               应用增量包(幂等,可重复跑)
  make_release.py              打包发版资产
  import_flk.py                把 flk 批量下载的 docx 整理成 inbox Markdown
  fix_pending_supersede.py     修复「待生效版本提前作废旧版」的存量数据
  strip_amendment_note.py      清掉修改决定正文里的解析残留(标注 / 标题残片)
  mark_repealed_by_decisions.py  按废止决定把被废止的法规标失效
state/change-ledger.json       变更账本:自首个 Release 起改过的法规清单
docs/UPDATE-PIPELINE.md        更新流水线的设计说明
docs/release-notes/            历次发版的 Release 正文存档
VERSION                        程序版本(唯一来源,server 与发版脚本都读它)
update.sh                      命令行更新;更新数据.command 双击更新
.github/ISSUE_TEMPLATE/        issue 表单:提交新法规 / 法条纠错
查条文和法规名归一这两条规则,只允许有一份实现,也就是 law_query_core.py。
网页端和 MCP 端各写一份迟早会走岔,表现是「网页查得到、agent 查不到」,
而这种错在 agent 场景下没人复核,代价比网页高得多。
配置
全部走环境变量,默认值见 server/law_search_service.py 顶部,示例见 .env.example。
| 变量 | 默认 | 说明 |
|---|---|---|
LAW_DATA_DIR |
./data |
数据目录,其余路径默认基于它 |
LAW_DB_PATH |
$LAW_DATA_DIR/law_data.db |
SQLite 库路径 |
LAW_CHROMA_PATH |
$LAW_DATA_DIR/legal_vector_db |
向量库路径 |
LAW_EMBEDDING_MODEL |
BAAI/bge-large-zh-v1.5 |
向量模型 |
LAW_COLLECTION_NAME |
chinese_laws |
向量集合名 |
LAW_REPO |
从 git remote 推断 | 查更新用的仓库 owner/name |
LAW_UPDATE_CHECK_TTL |
3600 |
版本检查缓存秒数;0 表示每次真查 |
LAW_UPDATE_CHECK_ON_START |
1 |
0 关闭启动时的后台检查 |
LAW_AUTO_UPDATE |
0 |
1 时查到新版直接装,不等用户点 |
GITHUB_TOKEN |
空 | 可选,未认证 API 限额 60 次/小时,配了 5000 |
老版本的数据包不需要手动迁移,服务启动时会自动补齐新增字段,这个动作可以反复执行。
常见问题
查不到想要的条文,通常是三种情况之一。
一是检索词太长。这是关键词匹配,不是问答,「公司不给上社保怎么办」这种整句查不出东西,
换成「社会保险」再搜。二是两字词召回不全,FTS 索引按三字窗口建,「工伤」「欠薪」这类两字词
用不上索引,会退化成全表匹配,大约一秒出结果但召回不全;查两字概念建议走 MCP,
让 agent 先把它扩成「拖欠劳动报酬」这类法言法语再查。三是法规本身不在库里,
本库只覆盖官方那几类(见前面「覆盖范围」),部门规章和地方政府规章不在其中。
更新中途报 UnicodeDecodeError: 'utf-8' codec can't decode,是程序版本旧了装不了.zst 增量包,git pull 一次再重跑就好。失败时数据没有被改动,库还是原来的,可以继续用。
条文和官网对不上,以国家法律法规数据库发布的正式文本为准。这个项目只是把公开数据落到本地,
不做任何改写。发现问题请用法条纠错
表单提,附上官方原文对照。
能不能直接对公网开放?请勿直接暴露。本项目不做认证,公网访问必须放在
带认证的反向代理或网关后面。
边界
这个项目提供条文文本与检索,不提供法律意见,也替代不了律师判断。引文核验只回答
「库里有没有这条、是否现行有效」,不管这条引用用得对不对;条文时效以库内记录为准,
数据版本日期见 manifest.json,涉及时效敏感的案件请自行复核。
修改决定的正文就是决定本身的条文,不含被修改那部法规的合并后全文。想看合并后的
完整条文,得去查母法,它的现行版已经按修改决定更新过了。
被废止的法规会跟着废止决定一起标失效:当前库里有 44 部是这么处理的 —— 条文标成repealed,核验时会直接回「该法规已废止」,并写出依据的决定名称和废止日期,不会
悄悄当现行法返回。这个结果会跟着增量包一起发:包里单列一份废止清单,下增量的用户
同样能拿到,不必为了这几部法重下全量。这个处理有范围:只认决定名称里能读出一部法规
的那类。写成「关于废止部分行政法规的决定」这种笼统表述,或者一条决定废止好几部法、
名字里又没有书名号可拆的,都定位不到具体法规,跳过不动。碰到这类决定,仍以官方公告为准。
作者与联系
壹律从简 · 作者:网络小菜鸟
- 站点:www.yilvai.com
- 微信:
pmfumin - 问题反馈:Issues
装不上、跑不通、发现某部法规缺失或版本不对,都可以直接找我,提 issue 时附上法规名称和条号会快很多。
许可
代码以 MIT 许可发布。法规文本源自国家法律法规数据库公开数据,按其公开使用规则使用。
Yorumlar (0)
Yorum birakmak icin giris yap.
Yorum birakSonuc bulunamadi