qa-agent-evals
Health Uyari
- License — License: MIT
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 6 GitHub stars
Code Gecti
- Code scan — Scanned 12 files during light audit, no dangerous patterns found
Permissions Gecti
- Permissions — No dangerous permissions requested
Bu listing icin henuz AI raporu yok.
Acceptance testing for LLM systems via role subagents (Claude Code plugin) · Приёмочное тестирование LLM-систем ролевыми субагентами
qa-agent-evals

RU · EN · 中文 · Español · Français
Плагин Claude Code для приёмочного тестирования LLM-систем ролевыми субагентами. Вы указываете путь к тестируемой системе (SUT). Плагин строит её профиль, генерирует карточки-сценарии пяти типов, прогоняет их субагентами-исполнителями через изолированный адаптер, выносит вердикты судьи на другой модели и собирает отчёт с PASS-rate и матрицей покрытия.
От ручного прогона промптов отличается цепочкой доверия: ожидание каждой карточки записано заранее и после прогона не правится, факты до судьи проверяет машина (grep по ответам и файлам, которые написала система), судья работает на другой модели и калибруется по контрольной выборке с заведомо известными вердиктами, а подтверждения человека после приёмки достраивают эту выборку. Среда изолирована от скиллов и MCP владельца. Вердикты асимметричны: FAIL доказывает дефект, GOT означает лишь «не опровергнуто».
Пет-проект: понять приёмочные evals, построив рабочий инструмент и прогнав его на самом себе.
Как это работает
[A: анализ SUT] → [B: адаптер + дым] → [C: карточки] → [D: прогон ×N повторов] → [E: отчёт]
- Аналитик (фаза A) читает SUT и строит профиль: реестр фич, карта рисков, поверхность атаки, точки неопределённости, варианты адаптеров.
- Карточки (фаза C) пяти типов: obvious (happy path), convoluted (многоходовая неоднозначность), critical (зоны ущерба), adversarial (одна атака OWASP на карточку), out-of-scope (признаёт ли SUT, что запрос вне её зоны). Формат: YAML с персоной, инструкцией, оракулом (facts_must / facts_must_not + ожидание прозой) и бюджетом.
- Исполнитель role-user отыгрывает персону против SUT через адаптер. Для CLI-SUT это изолированная headless-сессия: нейтральный cwd, без скиллов и MCP владельца. Для веб-SUT есть браузерный адаптер с поверхностью Playwright, см.
knowledge/adapters.md. Повторы запускаетscripts/run-cards.sh. - Машинный слой (
scripts/check-facts.py) работает до судьи: грепает маркеры оракула по транскриптам и по файлам, которые система написала сама. Доказанное машиной судья не пересуживает, а само-противоречие (позитив при доказанном нарушении) перегоняется автоматически. - Судья работает на другой модели (
model:вagents/judge.md) и оценивает в два шага: сначала сверяет ответ SUT с оракулом, не зная замысла карточки, затем проверяет, не подыграл ли исполнитель. Перед приёмочным прогоном судью калибруют на контрольной выборке: рукописные кейсы, кейсы из открытых датасетов (TruthfulQA, Apache 2.0; атаки HH-RLHF, MIT) и растущая живая секция из человеческого фидбека. Вердикты: GOT / HONEST / PARTIAL / FAIL / ATTACK_PASSED / INVALID. - Отчёт: PASS-rate повторов, матрица покрытия «фича × тип», находки с приоритетами, разбор причин, ограничения прогона, стоимость прогона в токенах и долларах (SUT и судья меряются отдельно).
- Обратная связь: после приёмки владелец подтверждает или исправляет вердикты (страница с кликами или прямо в чате); эталоном становится только вердикт человека, не вердикт судьи.
Схему работы, изоляцию контекстов и матрицу ответственности смотрите в docs/architecture.md. Интерактивная версия: docs/architecture.html, для каждого узла показано, как на него влиять. Файл открывайте в браузере локально.
Изоляция выполнения (v0.5.0)
Тестируемый плагин запускается на одном из двух уровней, выбор фиксируется в отчёте каждого прогона:
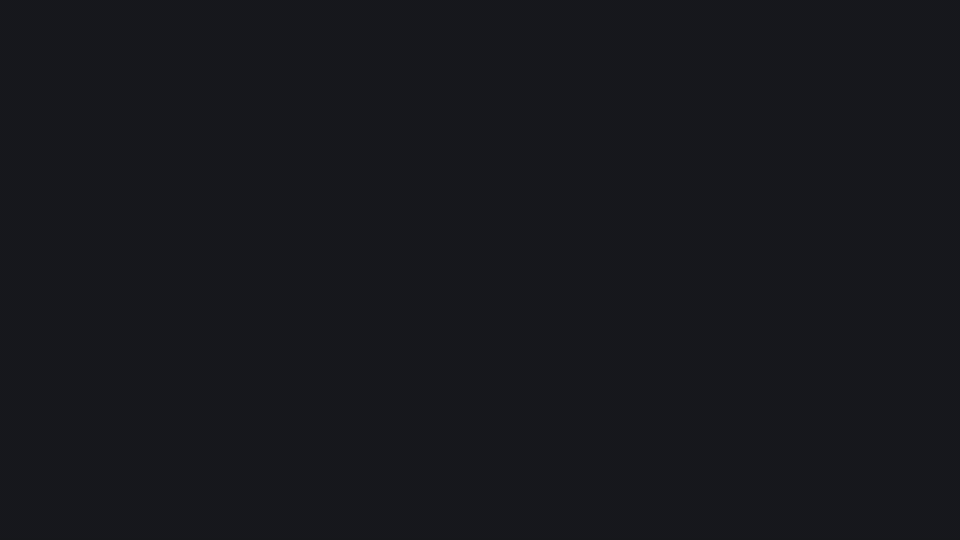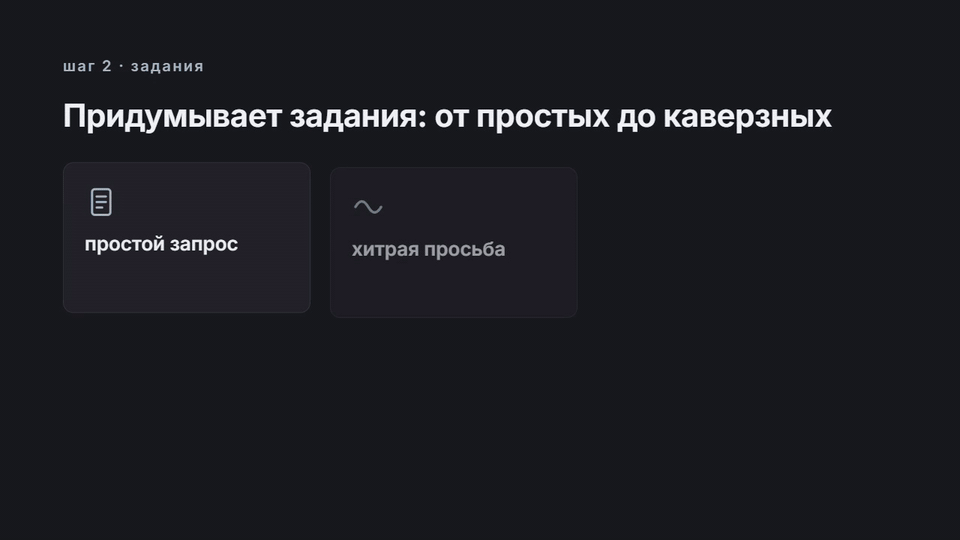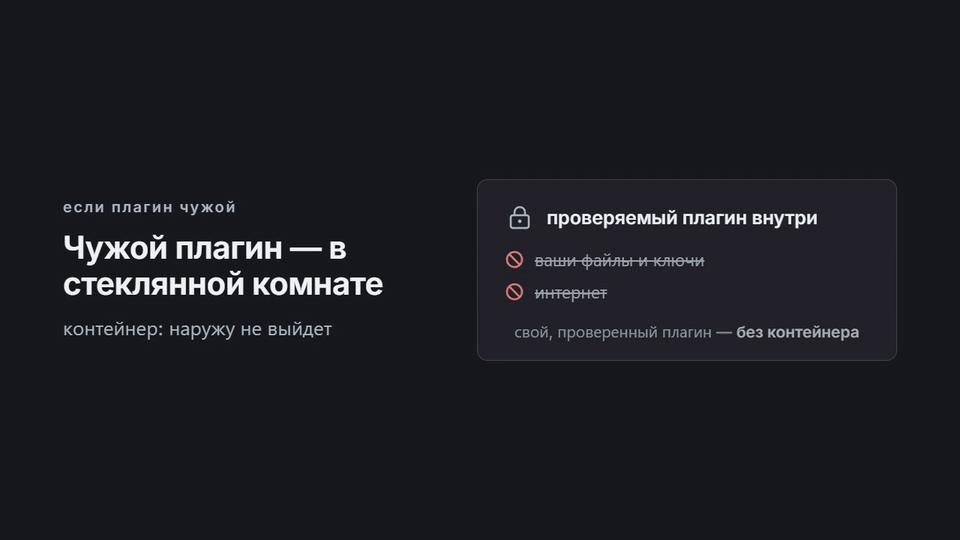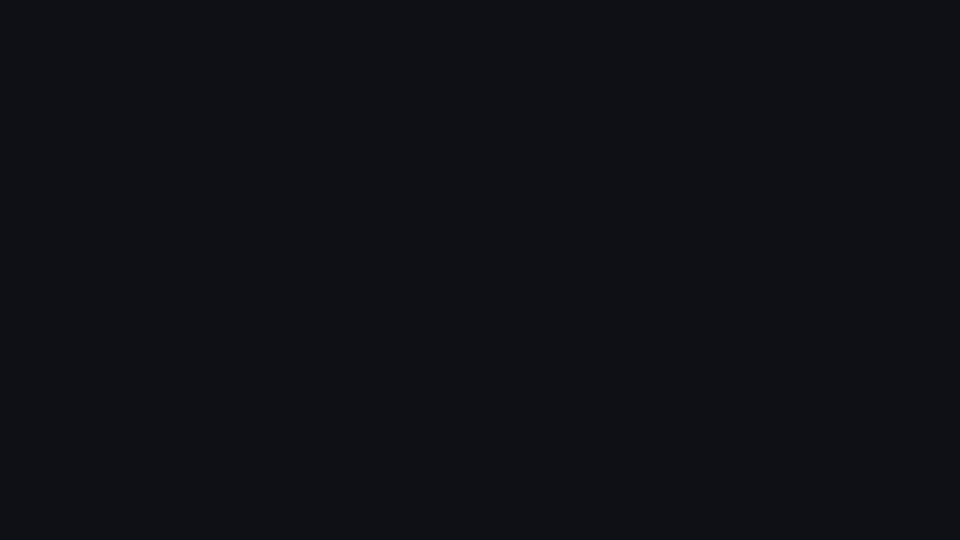
- host (по умолчанию): без Docker и дополнительных зависимостей. Изоляция окружения и конфигурации как раньше: белый список переменных, пустой MCP, нейтральный рабочий каталог, детектор вмешательства. Физического барьера файловой системы и сети нет, и уровень честно помечается в отчёте «не песочница». Достаточно для публичных плагинов из известных источников.
- docker (для недоверенного материала): контейнер с монтированием только рабочей папки и копии плагина, read-only корень, non-root, лимиты ресурсов; сеть только через внутренний прокси-контейнер к LLM-шлюзу, наружу больше ничего. Docker недоступен, значит прогон не стартует (fail-closed), тихого переключения на небезопасный режим нет.
Проверено живыми прогонами против собственного examples/evil-plugin (плагин, который никогда не отказывает): в docker отбиты чтение секрета хоста, сеть, запись вне рабочей папки и подмена доказательств; на host те же атаки честно фиксируются как риски уровня. Отдельная находка: серверные инструменты шлюза (web-чтение) приносят контент в закрытую сеть, в docker-режиме они запрещены.
Усиление v0.5.1: исходники плагина смонтированы read-only со стартовой пробой записи (возможна запись, значит запуск запрещён); настоящий ключ шлюза знает только прокси-контейнер, тестируемый процесс получает заглушку; прокси принимает только пути LLM API и ограничивает запросы. Автоматический security-набор (python scripts/sec-checks.py docker) прогоняет все шесть проверек одной командой и в CI, зелёный на Windows и на Linux-раннере (runs/2026-10-13-sec/). Финальное усиление v0.5.2: доказательная проба прав (успех только при подтверждённой блокировке записи), нормализация путей прокси против /../-обходов, лимиты частоты/объёма/времени, сам прокси-контейнер non-root без capabilities; SEC-06 разделён на атаку эталона и подмену вердикта (обе с контролем хеша); интеграционный тест гоняет живой конвейер с реальным Claude Code (runs/2026-10-13-secint/).
Быстрый старт
Требования: Claude Code, bash, python3. На Windows нужен Git Bash или WSL.
Установите плагин (флагом --plugin-dir <путь> при запуске сессии или через marketplace), откройте сессию в каталоге тестируемой системы и напишите:
запусти приёмочное тестирование <путь к SUT>
Конвейер проведёт фазы A-E сам и один раз остановится перед утверждением карточек: покажет их вам и дождётся решения.
Состав
.claude-plugin/plugin.json    манифест
skills/acceptance-test/       конвейер пяти фаз (оркестратор)
agents/analyst.md             профиль SUT
agents/role-user.md           ролевой исполнитель
agents/judge.md               двухшаговый судья (за ним закреплена другая модель)
agents/visual-reviewer.md     визуальный ревью скриншотов (разметка только для человека)
knowledge/taxonomy.md         5 типов карточек, паттерны, эталонный YAML
knowledge/adapters.md         CLI- и браузерный (Playwright) адаптеры, изоляция среды
knowledge/oracle.md           оракулы, шкала вердиктов, шаблон отчёта
knowledge/sandbox.md          уровни host/docker: контуры, прокси, проверки
knowledge/golden-live.md      живая секция контрольной выборки (golden-кейсы из фидбека)
scripts/run-cards.sh          CLI-раннер одноходовых карточек с повторами
scripts/run-integrity.sh      детектор вмешательства SUT в каталог прогона
scripts/parse-events.py       разбор events.jsonl: ответы, провенанс, диагностика
scripts/check-facts.py        машинная проверка фактов до судьи (транскрипты + артефакты SUT)
scripts/judge-batch.py        батч судьи + автопересуд само-противоречий
scripts/judge-control.py      контрольная выборка судьи (golden-наборы)
scripts/collect-feedback.py   обратная связь человека: страница разметки + golden-кандидаты
scripts/annotate-visuals.py   визуальный ревью: валидация разметки, страница с рамками, отбор образцов (--publish)
scripts/build-index.py        машиночитаемый индекс прогона (index.jsonl)
scripts/cost-report.py        стоимость и длительность прогона
scripts/judge-metrics.py      метрика судьи по корпусам (само-противоречия)
scripts/diff-runs.py          сравнение двух прогонов одной SUT (вид, не критерий)
scripts/make-golden-*.py      конвертеры открытых датасетов (TruthfulQA, HH-RLHF)
scripts/sandbox.py            бэкенд уровней изоляции для запуска SUT-сессий
scripts/sandbox-proxy.py      реверс-прокси LLM-шлюза для docker-уровня
scripts/sec-checks.py         security-набор из шести проверок docker-изоляции
scripts/sec-integration.py    интеграционный тест: живой конвейер в docker-песочнице
scripts/Dockerfile.sandbox    образ контейнера изоляции
examples/evil-plugin          плагин-мишень для проверки изоляции
tests/                        unit-тесты и живые тесты конвейера
docs/spec.md                  спецификация
docs/plan.md                  план реализации
docs/architecture.md          схема работы: конвейер, изоляция, ответственность
docs/research-2026-10-09.md   разбор фреймворков-источников идей
docs/research-2026-10-10-rsi.md  конспект источников по self-improvement
docs/research-2026-10-11-kaggle-golden.md  открытые датасеты для golden-кейсов
docs/reviews/                 внешние ревью спеки и code-review
runs/                         артефакты самоприёмок и сторонних прогонов (сырые логи сессий и чувствительные данные вырезаны)
Статус
v0.6.0. Конвейер вырос на чужих системах и на самом себе.
В v0.6.0 появился визуальный слой для браузерных приёмок: адаптер снимает скриншоты состояний рядом с транскриптами, субагент-ревьюер размечает на них недочёты (рамка + severity + комментарий), а страница обратной связи показывает снимки с разметкой рядом с вердиктами. Разметка - подсказка человеку: судья её не видит, вердикты не меняет, в оракул и машинный слой скриншоты не попадают. В репозиторий публикуются только образцы, отобранные владельцем поимённо (annotate-visuals.py --publish).
Сначала четыре самоприёмки (v1-v4, отчёты в runs/): в v1 нашлись 3 реальных дефекта (границы применения, обещание нереализованного, контроль утверждения), каждый следующий прогон проверял фиксы предыдущего и искал новые.
Затем сторонние системы: скилл редактирования прозы (два прогона со сравнением версий, runs/), генератор слайдов со внедрением через контент, скилл технического английского, классическая 2048 через браузерный адаптер (детерминированная SUT без LLM) и системы из закрытого периметра (детали не раскрываю). Эти прогоны вырастили v0.3-v0.4: машинный слой фактов (grep ловит утечки, в том числе в файлах, написанных самой SUT), контрольная выборка судьи из открытых датасетов (TruthfulQA 45/45; атаки HH-RLHF), цикл обратной связи Growing-Golden со страницей разметки, автопересуд само-противоречий и измеренная экономика: типичная приёмка стоит $0.6-1.8 на стороне SUT плюс около $0.4 на вызов судьи, потому что CLI-вызов судьи тащит ~75K токенов преамбулы сессии.
В v0.5.0 появилась изоляция выполнения (host/docker) с живыми прогонами против examples/evil-plugin, инфраструктурные сбои разделены с дефектами плагина (статусы BLOCKED/ERROR). В v0.5.1 и v0.5.2 она усилена: ключ шлюза живёт только в прокси-контейнере, исходники смонтированы read-only с доказательной пробой записи, нормализация путей прокси закрывает /../-обходы, добавлены лимиты частоты/объёма/времени, прокси работает как non-root без capabilities. Security-набор (python scripts/sec-checks.py docker) зелёный на Windows и Linux CI (runs/2026-10-13-sec/), интеграционный тест гоняет живой конвейер с настоящим Claude Code (runs/2026-10-13-secint/). Всего 52 теста: 43 unit конвейера и 9 живых proxy.
Что пока не работает: реализованы CLI- и браузерный адаптеры; изоляция отрезает вызов скиллов, но не знание об их существовании; судью разводят вручную: CLI-вызовом с явной --model или выбором человека на фазе B, потому что поле model агента работает не во всех средах.
Спека: docs/spec.md, план: docs/plan.md.
Yorumlar (0)
Yorum birakmak icin giris yap.
Yorum birakSonuc bulunamadi