data-analysis-agent
Health Warn
- License — License: MIT
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 5 GitHub stars
Code Fail
- eval() — Dynamic code execution via eval() in .github/workflows/ci.yml
- network request — Outbound network request in frontend/src/components/AuthImage.tsx
Permissions Pass
- Permissions — No dangerous permissions requested
No AI report is available for this listing yet.
LLM 数据分析工作台:上传数据集自动完成清洗、统计分析、可视化与报告;受控工具集 + 只读 SQL(SQLite / PostgreSQL)· MCP 数据面 · Plotly + ECharts 双引擎 · FastAPI + React 全流程界面,本地 / Docker / 云端可部署
Data Analysis Agent





一个基于 LLM 的数据分析工作台:上传数据集,自动完成数据检查、清洗、统计分析、可视化与报告生成。
后端采用 LangChain + LangGraph 的 Plan-and-Execute + ReAct 混合架构,前端为独立 React 应用,本地通过 HTTP/SSE 通信。可一键本地运行,也可部署到 LangSmith / Render / Docker。
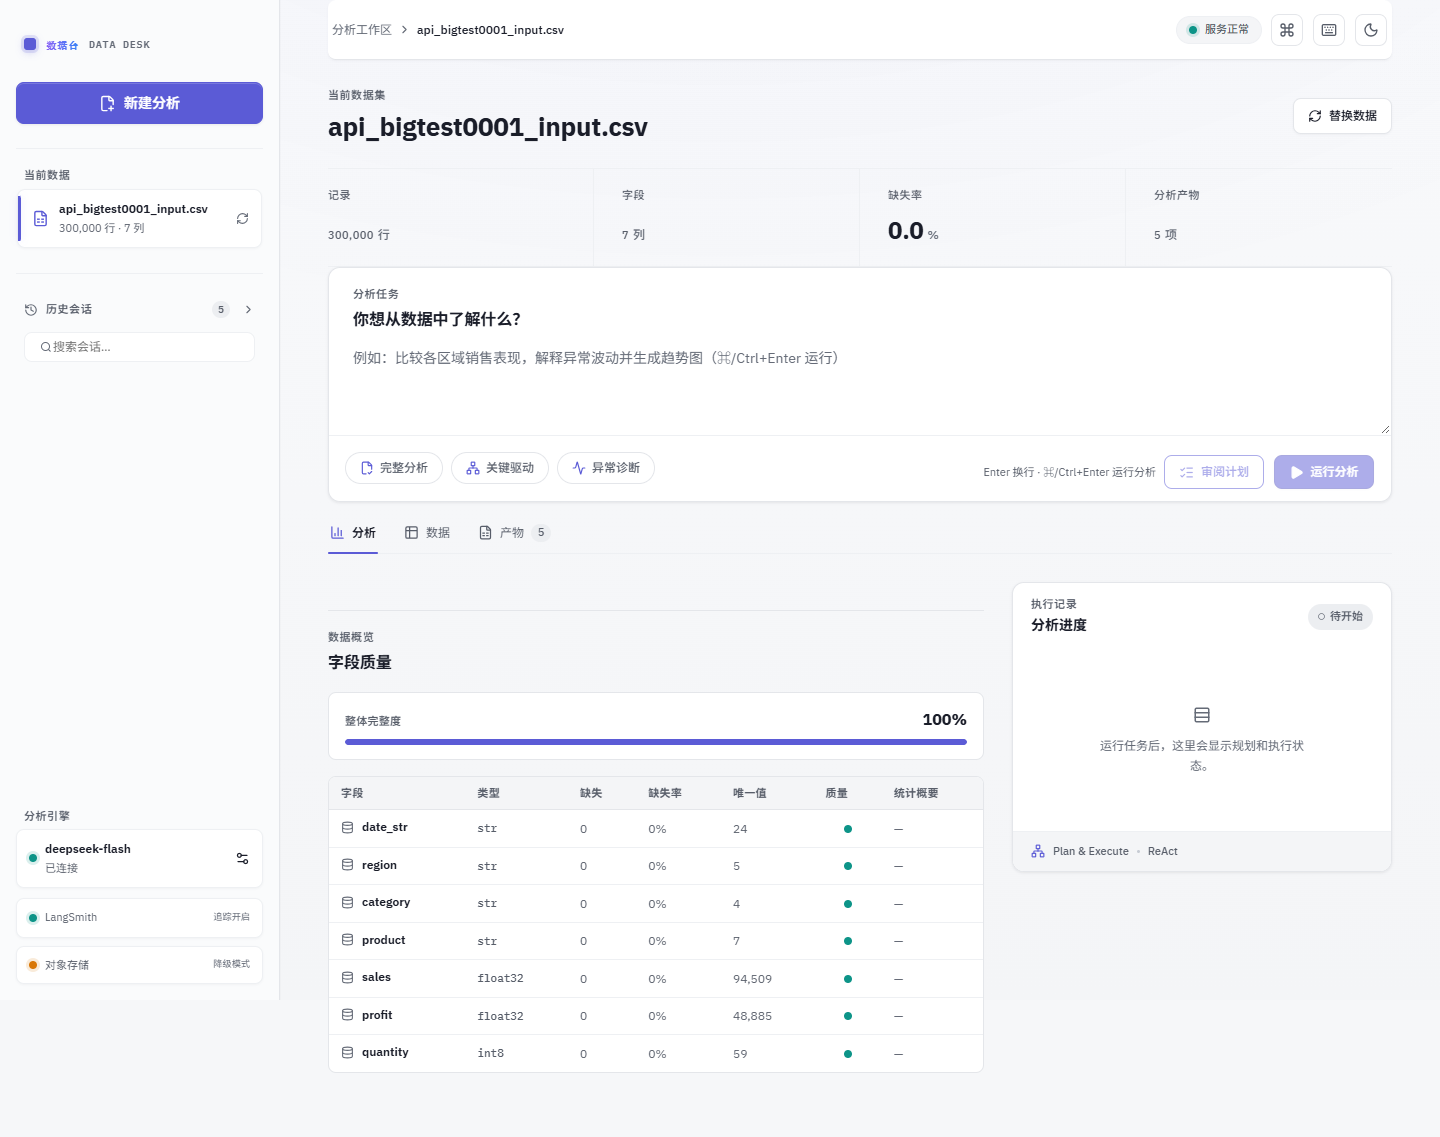
全流程工作台:数据概览 → 分析任务 → 实时执行进度 → 结构化报告
系统架构
flowchart LR
    U[上传数据集] --> W[工作区 DataWorkspace<br/>数据档案 / 清洗 / 产物]
    W --> P[Plan-and-Execute 规划器<br/>生成 2–6 步结构化计划]
    P --> R[ReAct 执行器]
    R --> T[受控工具集]
    T --> T1[数据检查 / 格式修复]
    T --> T2[安全清洗 / 筛选视图]
    T --> T3[统计分析 · 假设检验]
    T --> T4[Plotly / ECharts 图表]
    T --> T5[导出 / Python 沙箱]
    R -->|重规划器<br/>裁剪与补充步骤| P
    R --> F[汇总 · 生成报告]
    F --> G[结构化分析报告]
    F --> C[交互式图表产物]
    G --> Q[多轮追问对话]
    C --> Q
界面预览
| 起始页 · 拖拽上传与示例数据 | 分析工作区 · 数据概览与任务 |
|---|---|
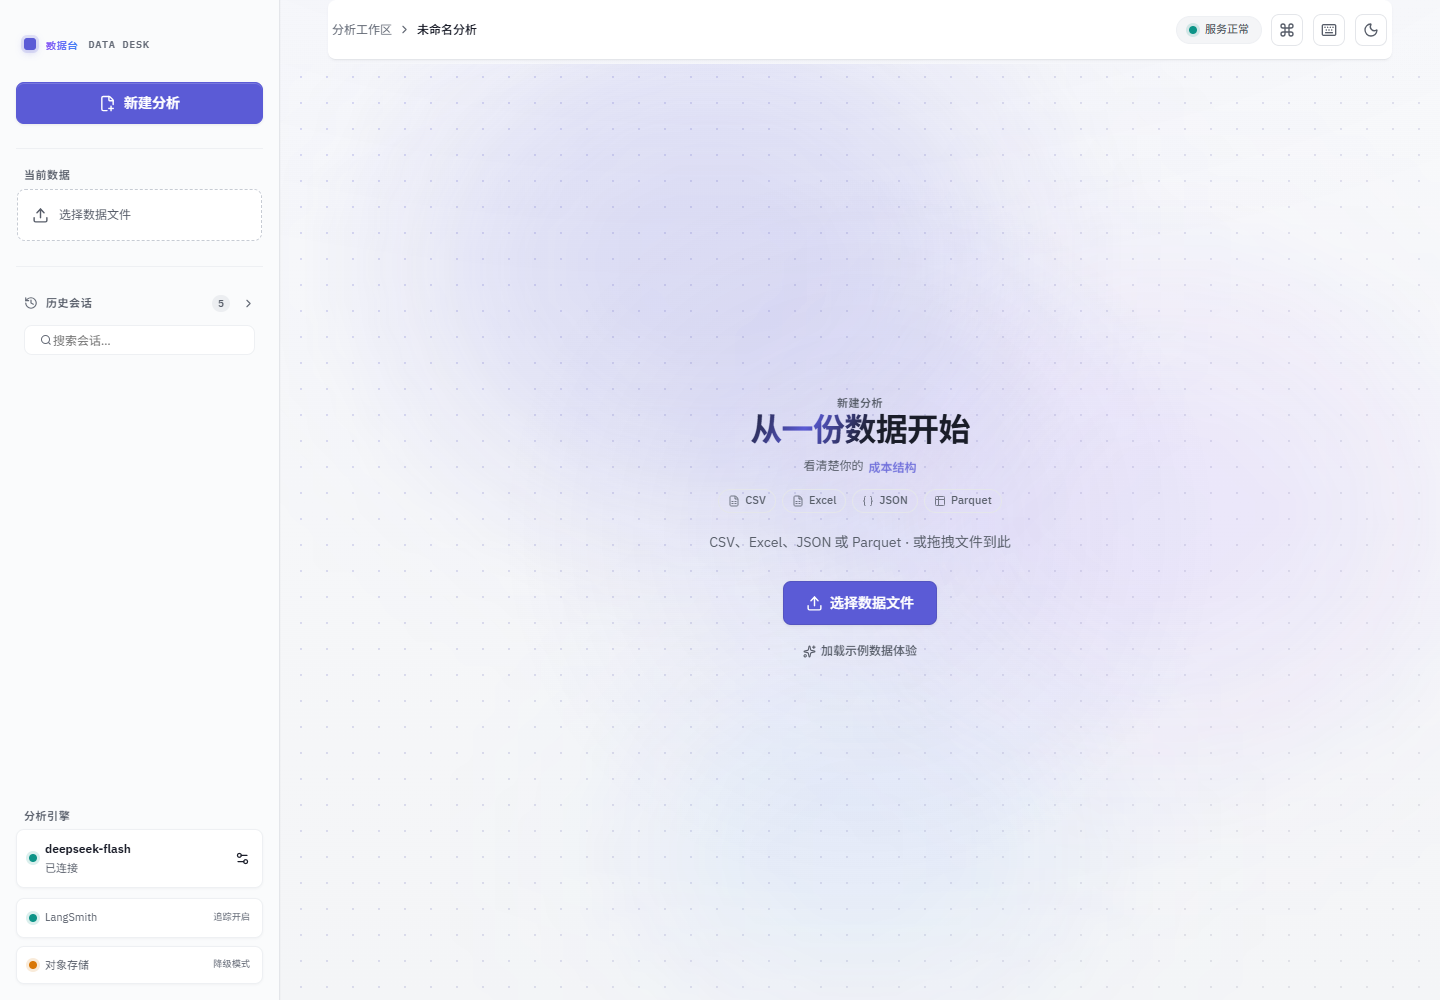 |
|
| 深色主题 · 全流程工作台 | 产物中心 · 图表缩略图与下载 |
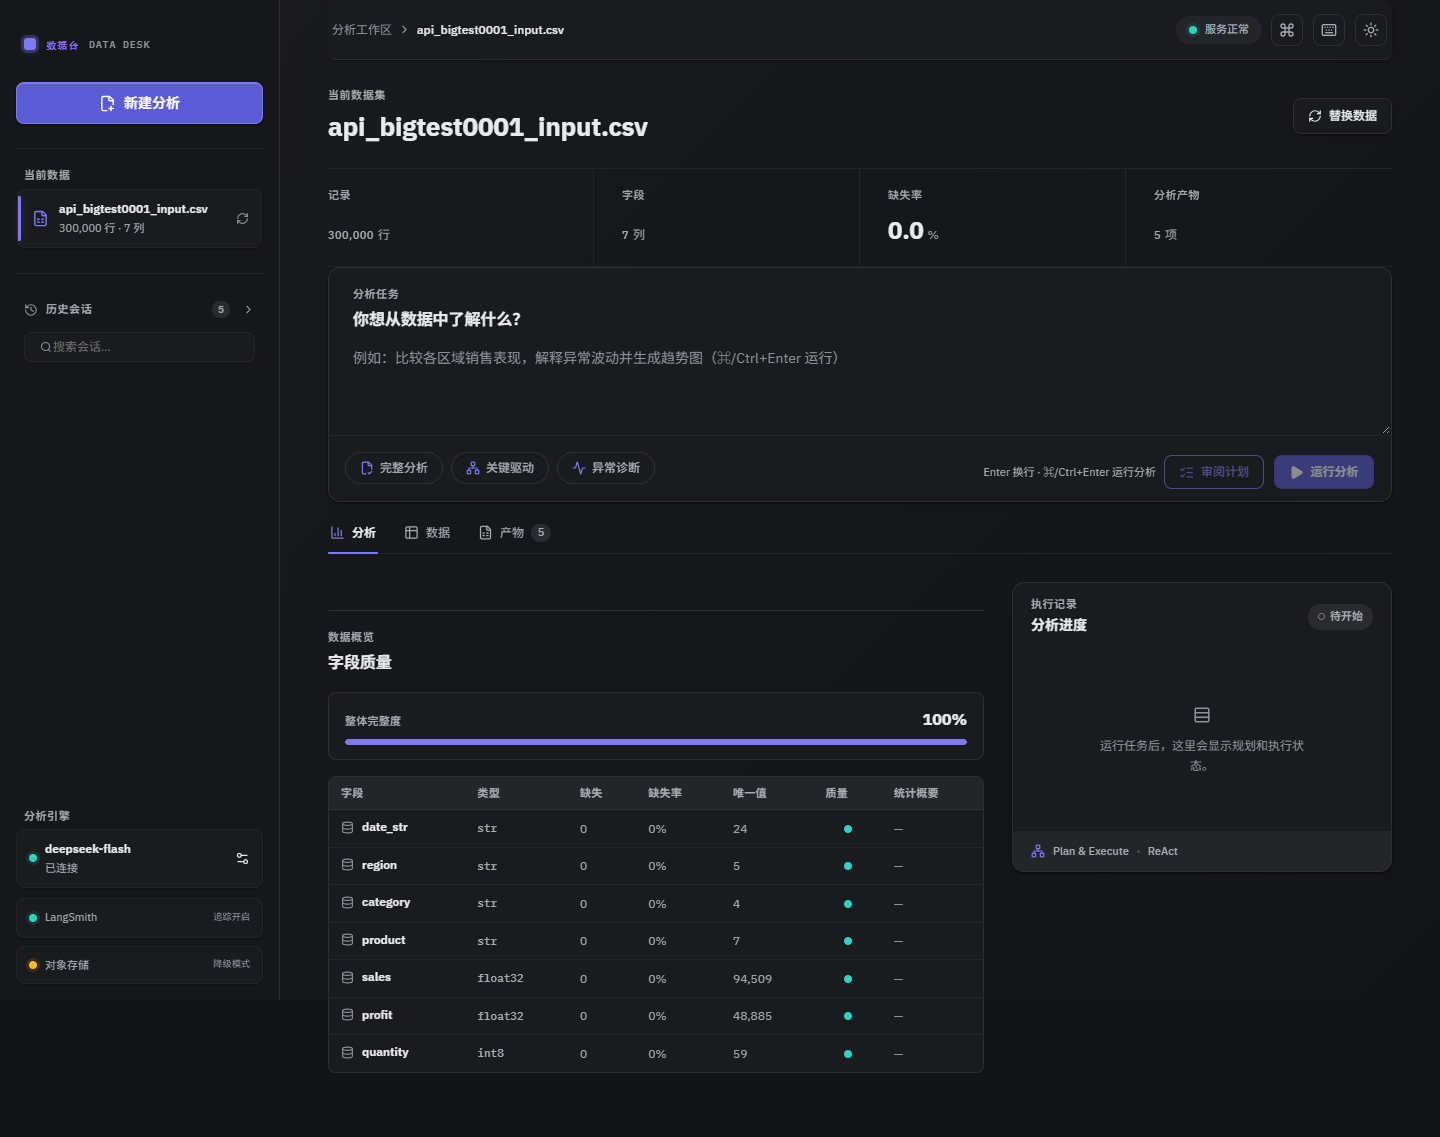 |
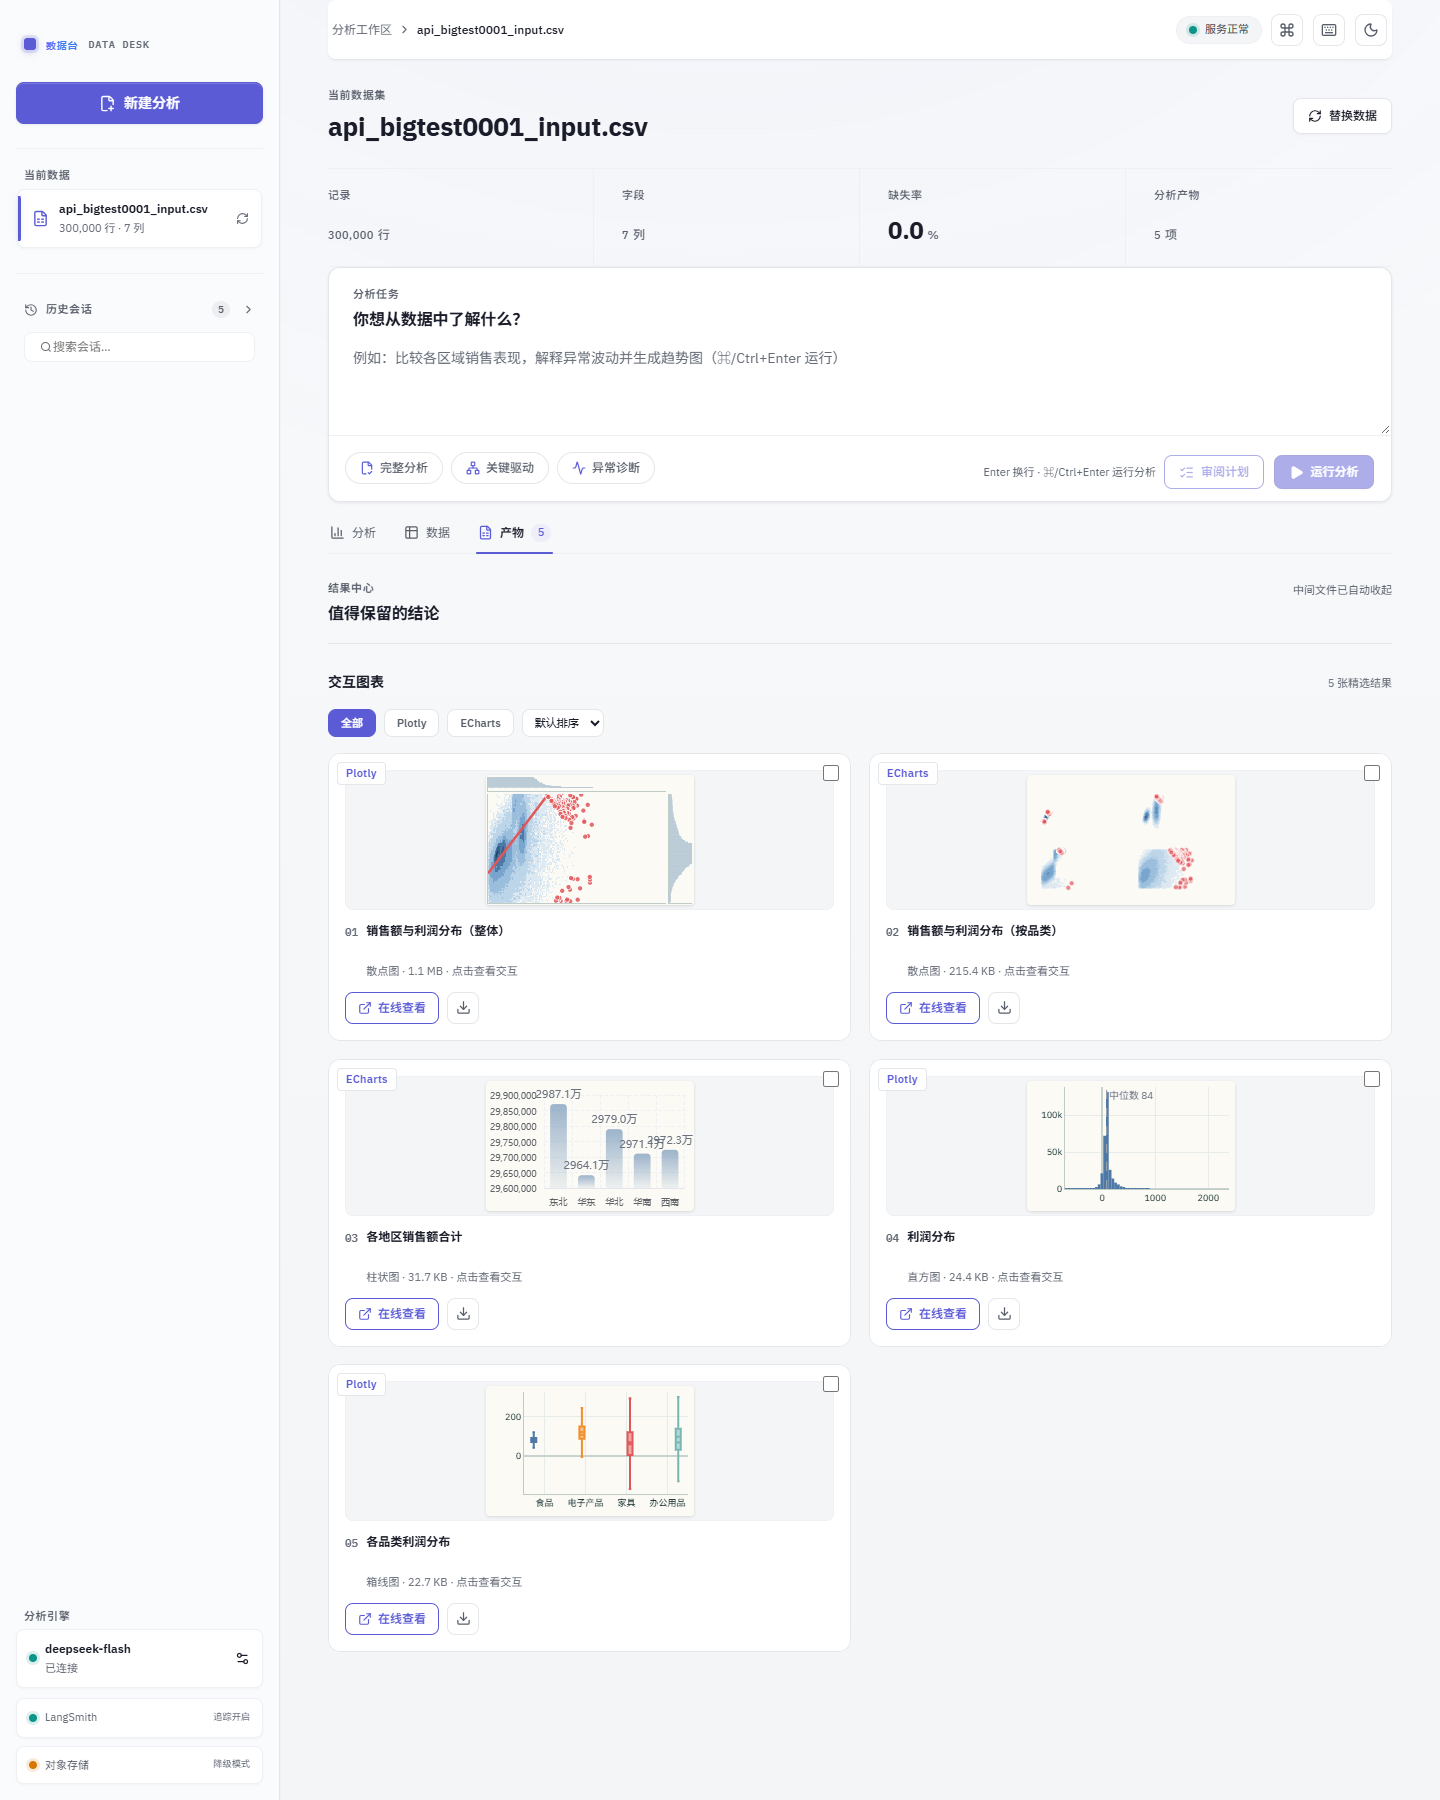 |
| 图表预览 · 密度视图与细节图层 | 数据预览 · 类型识别与列对齐 |
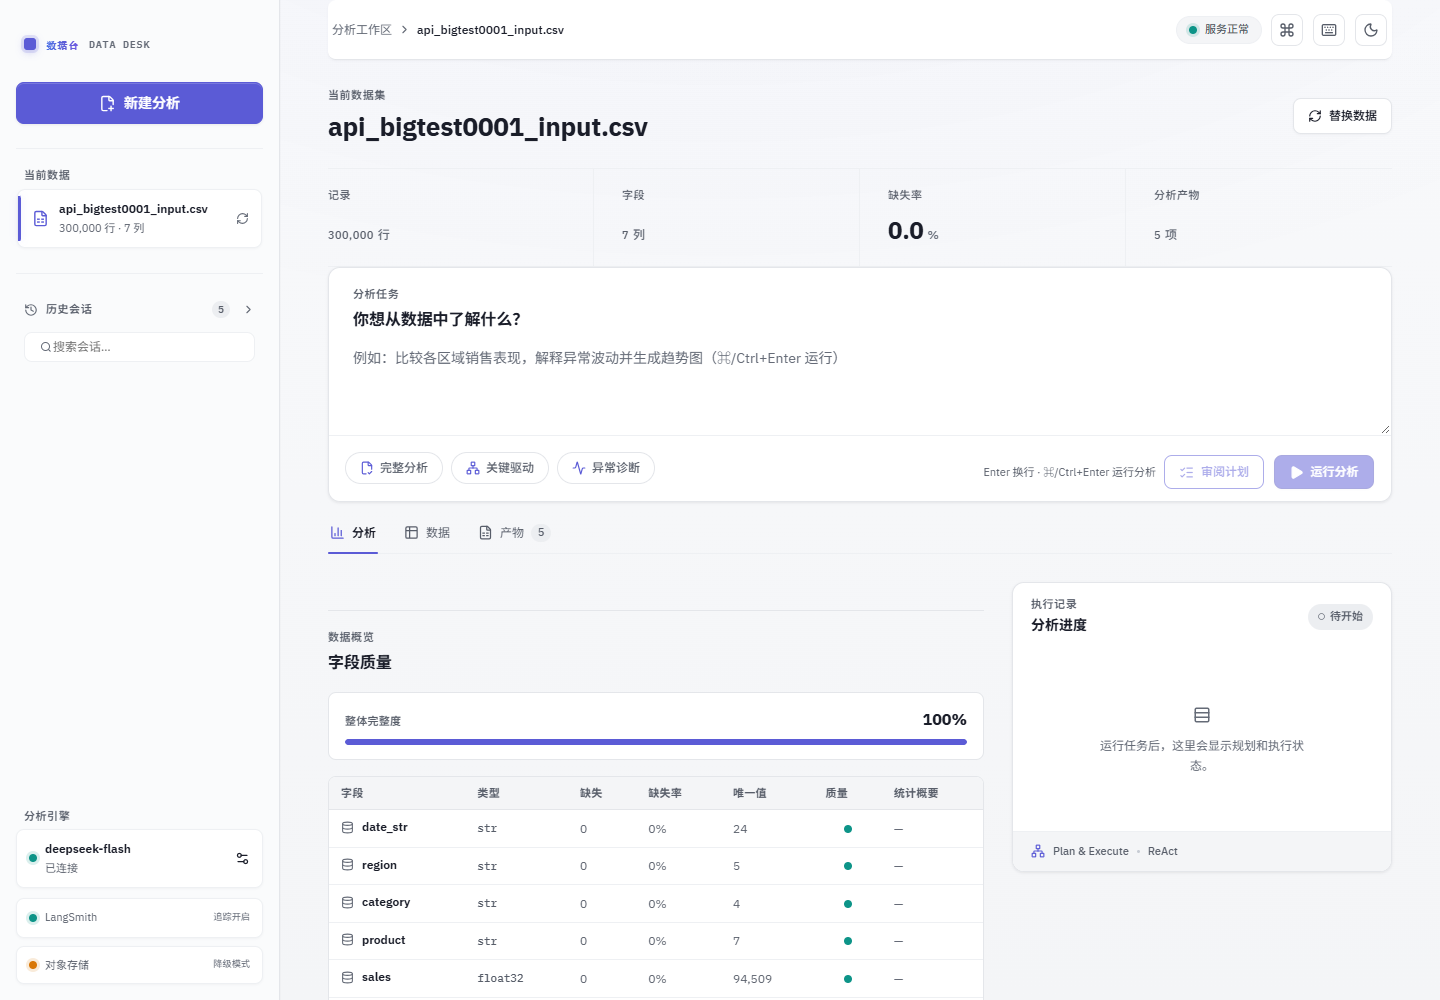 |
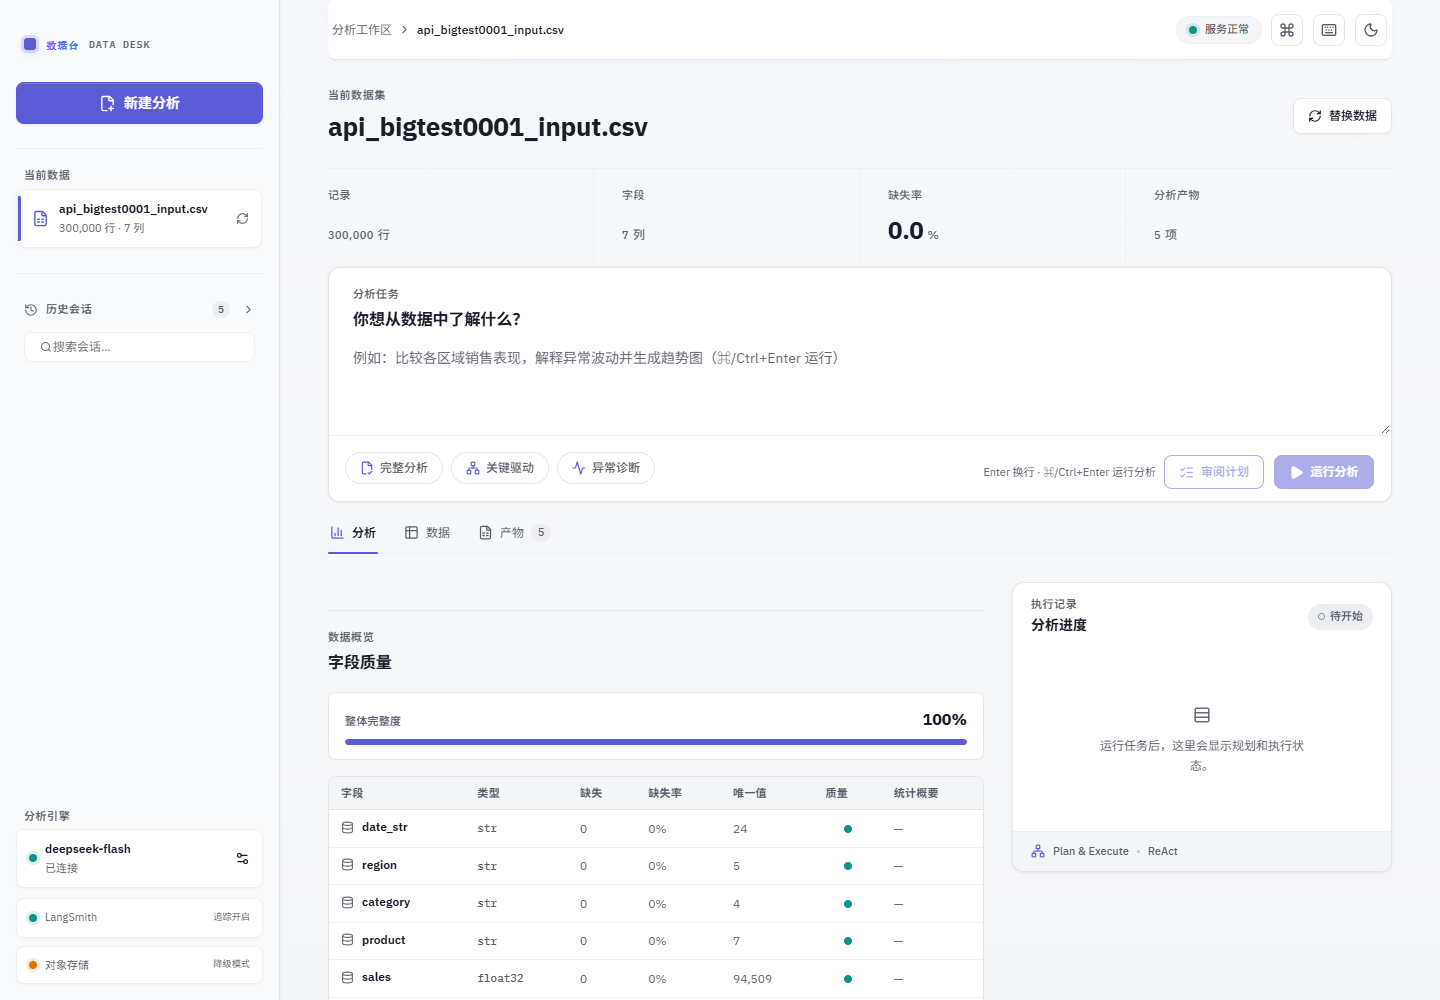 |
以上截图可用 python scripts/capture_docs_screenshots.py 一键重新生成(本地起服务后逐页抓图)。
功能特性
- 计划-执行式分析流程:每次分析先生成 2–6 个结构化步骤,每个步骤由 ReAct 执行器调用受控工具完成;重规划器根据真实工具结果删除无用步骤、补充后续分析,证据充分时提前结束,达到步骤上限时强制汇总,避免无限循环。
- 受控数据工具集(11 个内置工具):数据检查、格式修复、安全清洗、非破坏性筛选视图、跨源合并、数据库查询、登记指标计算、统计分析、图表生成、数据导出、受限 Python 沙箱。
- MCP 数据面服务:把会话发现、数据集载入、结构探查与只读 SQL 以 MCP 标准开放给其他 Agent,护栏同源、传输 stdio(详见"快速开始")。
- 跨源合并带连接键校验与行数膨胀护栏:键不存在、键类型不一致导致一行都匹配不上、键不唯一导致行数被放大数倍,三种情况一律拒绝执行并说明原因;结果同时给出未匹配键数量与一对多放大警告,避免把扇出后的行数当作原始记录数。合并结果会成为新的活动数据集,行数基线同步重置。
- 数据库查询面向两类数据源:上传的 SQLite 文件,以及环境变量
DATA_AGENT_DATABASE_URL配置的 PostgreSQL(驱动按需安装:pip install ".[postgres]")。只读(SQLite 以mode=ro打开、Postgres 在服务端设置default_transaction_read_only,写入在驱动/服务端即被拒绝),只接受SELECT/WITH语句;单条查询默认 30 秒墙钟预算(DATA_AGENT_SQL_TIMEOUT_SECONDS,1–120;SQLite 用 progress handler 中断、Postgres 用服务端statement_timeout),结果上限 5000 行、500 列。空sql调用可一次拿到可用数据源与全库表结构;传adopt=true可把查询结果接管为活动数据集,后续统计与图表直接在其上工作。 - 清洗带安全护栏:缺失值删除比例超过 50% 会拒绝执行,主数据行数始终不低于原始行数的 20%。
- 统计方法覆盖描述统计、相关分析(含 Pearson p 值)、分组聚合、独立/配对 t 检验、ANOVA、卡方检验、线性回归(R² / RMSE / MAE)。
- 指标口径登记(可选):在会话目录放置
metrics.json,或用DATA_AGENT_METRICS_PATH指定一份全局定义,登记指标的标准名称、别名、口径说明、算式与已验证问法(examples:业务确认过的问题样例,随口径一起注入,让模型把口语问题对齐到标准指标,对标 Power BI verified answers 的人工策展思路);规划阶段会把相关定义注入提示词,避免同一指标在不同会话被各自定义为不同口径。未提供定义文件时该特性完全不生效,行为与原来一致。 - 双图表引擎(Plotly + ECharts):共享同一套数据准备逻辑,支持折线、柱状、面积图、散点(含 3D)、直方图、箱线图、小提琴图、饼图、热力图、相关热力图、散点矩阵、旭日图、矩形树图;自动选图、散点图自动叠加 OLS 趋势线(标注 r 值)与双轴均值象限参考线、极端值自动检测与主体尺度/全量视图切换、暗色主题联动、PNG 导出、数据驱动的白话解读。
- 大数据图表的可读性:几十万行时"每点一个标记"的散点会因 alpha 饱和糊成一团(实测 30 万点全是同色噪点)。散点 ≥ 2 万行自动切换为密度视图:服务端聚合成网格(单格约 7px)、用分档颜色表达每格记录数(档位图例直接给出"1 / 2–4 / 5–9 …"的记录数区间)、零记录格完全透明,并在有分组时按分组拆成共享色标的分面面板(类别用分面表达、颜色只表达密度);无分组时补顶部/右侧边缘直方图(jointplot 布局)、趋势线、均值参考线与最外围原始点。判定"是否真有聚集"会先扣掉均匀随机点云的统计涨落,没有聚集就直说。放大后想看具体记录:图上带一层默认隐藏的分层抽样原始点,Plotly 用右上角按钮、ECharts 用图例开关一键叠加(名字与解读都写明是抽样、条数,完整数据在同名 JSON)。直方图 ≥ 5 万行改为服务端分箱(纵轴仍是真实记录数)、箱线图改为服务端五数概括、小提琴图与 3D 散点分层抽样(3D 会把"已抽样 N/M 点"写在副标题上)——同一批图表 HTML 体积从 312MB 降到 20200KB,密度视图是精确聚合而非抽样,完整数据始终保留在同名 JSON 产物里。折线/面积按 LTTB(Largest-Triangle-Three-Buckets)保峰降采样(数值轴与类目轴都覆盖),短促尖峰不会被等距抽样抹掉。
- 可访问性:全站文字对比度按 WCAG AA 校准并用浏览器计算样式实测(浅/暗两主题 × 起始页/工作台/产物/历史/命令面板/预览模态),三级文字阶梯与"实心强调色"分令牌管理(白字压底专用
--accent-solid,避免暗色下提亮的品牌色当背景时只有 3.5:1);滑块、按钮、卡片均带 hover/active 反馈与键盘焦点环。 - 多格式数据接入:CSV / TSV / Excel / JSON / JSONL / Parquet、SQLite(
.db/.sqlite/.sqlite3,上传后默认载入行数最多的表,其余表由数据库查询工具访问),以及 PDF 表格提取、TXT、Word 表格;自动探测编码(UTF-8 / GB18030)与分隔符,大文件分块流式读取,数值列自动降级数据类型以节省内存。 - 全流程 Web 工作台:文件上传(含进度与取消)、数据概览指标、分析任务与预设模板、计划审阅/批准、实时步骤与工具调用进度(SSE + 15 秒心跳)、随时取消分析、报告生成后的多轮追问、产物中心(预览/对比/PNG/批量下载)、历史会话(重命名/删除/导出 ZIP/导入)、命令面板与快捷键、深浅主题、移动端适配。
- 断点续跑与自动恢复:分析中断后可从已完成的步骤继续,无需重跑;前端支持 SSE 断线自动恢复与一键重试。
- 安全与访问控制:可选访问令牌(
APP_ACCESS_TOKEN)、滑动窗口速率限制、CORS / GZip / 安全响应头;API Key 通过操作系统凭据库(keyring)保存,不落明文文件。 - 会话持久化:本地或 S3 兼容对象存储(如 Cloudflare R2)双后端,会话按 session id 自动归档/恢复,带路径穿越防护。
- 可观测与部署:LangSmith 全链路 Trace(规划、每次工具调用、重规划、汇总);LangGraph Agent Server 部署;Dockerfile(非 root 用户 + 健康检查);Render Blueprint 一键部署;GitHub Actions 自动 CI。
- 可复核的分析溯源与逐结论核验:每次分析在会话目录生成哈希链,覆盖任务元信息、数据集、逐条工具调用、产物文件与报告正文;finalize/replay 另将正文数字逐项判为
verified/conflict/unsupported,在报告追加结论核验表并生成可下载的report-verification.json,按 trace 序号和 JSON Pointer 定位证据。见 docs/analysis-provenance.md。 - 发布前质量闸门(可选):
data-agent-eval compare对同一套用例的基线与候选结果做配对 McNemar 精确检验,同时检查成本与延迟回归,给出接受 / 拒绝 / 证据不足三态裁决,并写入可校验的哈希链 ledger。见 docs/agent-eval.md。
技术栈
- 后端:Python 3.11–3.13、FastAPI、Uvicorn、LangChain、LangGraph、LangSmith
- 模型接入:DeepSeek(默认,支持 thinking mode)/ OpenAI 及任意 OpenAI 兼容服务
- 数据分析:pandas、NumPy、SciPy、scikit-learn、Plotly、Kaleido、openpyxl、PyArrow、pdfplumber、python-docx
- 存储:本地文件系统 / boto3(S3 / R2)
- 前端:TypeScript、React 19、Vite、Zustand、lucide-react、motion、react-markdown(Vitest)
- CLI:Typer + Rich
快速开始
环境要求
- Python 3.11–3.13
- Node.js 22 或更高版本
- 一个 LLM API Key(默认 DeepSeek,也兼容 OpenAI)
一键启动(Windows)
双击 run.bat。首次运行会自动创建虚拟环境、安装后端依赖并 npm install,随后分别启动:
- 前端:http://127.0.0.1:5173
- 后端 API:http://127.0.0.1:8000
- API 文档:http://127.0.0.1:8000/docs
手动启动
# 后端
python -m venv .venv
.\.venv\Scripts\python.exe -m pip install -e ".[dev]"
Copy-Item .env.example .env   # 编辑填入 DEEPSEEK_API_KEY
.\.venv\Scripts\python.exe -m uvicorn data_agent.api:app --host 127.0.0.1 --port 8000

# 前端(另开终端)
cd frontend
npm install
npm run dev
命令行分析
pip install -e ".[dev]"
export DEEPSEEK_API_KEY=<your-key>        # Windows PowerShell: $env:DEEPSEEK_API_KEY="<your-key>"
data-agent analyze examples/sample_sales.csv --task "分析各区域销售趋势"
输出为 Markdown 格式分析报告,产物路径一并打印。
MCP 数据面服务(供其他 Agent 调用)
把受控的数据访问能力以 MCP(Model Context Protocol)标准开放给 Claude Desktop、
WorkBuddy 等任意 MCP 客户端:其他 Agent 拿到的是"安全的数据访问",而不是一个
无限制的代码沙箱——这是本项目差异化的直接延伸。
pip install ".[mcp]"        # 或开发环境 pip install -e ".[dev]"
data-agent-mcp              # stdio 传输,供本地 MCP 客户端拉起
客户端配置示例(Claude Desktop / 通用 MCP 客户端):
{
  "mcpServers": {
    "data-analysis-agent": {
      "command": "data-agent-mcp",
      "env": { "DATA_AGENT_RUNS_DIR": "./runs" }
    }
  }
}
开放 4 个工具:list_sessions(发现会话)、open_dataset(载入本地数据文件并建会话)、inspect_data(结构与预览)、sql_query(只读 SQL,支持会话内 SQLite 与DATA_AGENT_DATABASE_URL 配置的 PostgreSQL)。护栏与工作区内工具同源:只接受SELECT/WITH,写入在驱动或服务端被拒绝,结果上限 5000 行。
边界说明:完整分析流程(LLM 规划-执行-报告)是分钟级长任务,仍走 HTTP API,
不在 MCP 数据面内。传输为 stdio、由本地受信客户端拉起,不要把该服务挂到
网络上对外提供;远程访问请使用带令牌与限流的 HTTP API。
配置
复制 .env.example 为 .env 并填写(所有密钥均为占位符):
MODEL_PROVIDER=deepseek
DEEPSEEK_API_KEY=<your-deepseek-api-key>
DEEPSEEK_MODEL=deepseek-flash
DEEPSEEK_THINKING=true
DEEPSEEK_REASONING_EFFORT=high

# 或使用 OpenAI 兼容服务
OPENAI_API_KEY=<your-api-key>
OPENAI_MODEL=gpt-4.1-mini

# 前端构建产物目录(源码树内运行可省略;Docker / Render / wheel 安装必须显式指定)
DATA_AGENT_STATIC_DIR=frontend/dist

# 线上访问保护(绑定 0.0.0.0 等非环回地址时必填,否则拒绝启动)
APP_ACCESS_TOKEN=<your-access-token>

# 可选:指标口径登记文件(登记后规划阶段会注入口径定义,防止跨会话口径漂移)
DATA_AGENT_METRICS_PATH=<path-to-metrics.json>

# 可选:PostgreSQL 数据源(配置后 query_database 可只读查询该库;驱动 pip install ".[postgres]")
DATA_AGENT_DATABASE_URL=postgresql://user:password@host:5432/dbname

# 可选:Cloudflare R2 / S3 兼容持久化
DATA_AGENT_STORAGE_BACKEND=s3
DATA_AGENT_STORAGE_BUCKET=<bucket-name>
DATA_AGENT_STORAGE_ENDPOINT_URL=https://<ACCOUNT_ID>.r2.cloudflarestorage.com
AWS_ACCESS_KEY_ID=<your-access-key-id>
AWS_SECRET_ACCESS_KEY=<your-secret-access-key>
完整变量清单见 .env.example。
用于实践时请先知道
- 本进程是一个信任域。 单一
APP_ACCESS_TOKEN能列出并打开runs/下全部会话。团队共用一台机器时必须设令牌,也不要把不同客户的数据放进同一个服务。 - 默认先审阅计划。
⌘/Ctrl+Enter与主按钮「生成计划」只出步骤;确认后再批准执行。「跳过审阅」才会直接跑。 - 指标要登记才会按同一口径算。 工作台「业务口径」或
DATA_AGENT_METRICS_PATH写入metrics.json,表达式必须使用真实列名(如sales - returns)。分析时会调用compute_registered_metrics,报告里的「核验附录」默认收起。 - 经营简报可以独立复算。 工作台「简报核验」读取原始订单 CSV,核对销售额、销量和订单数,提供核验版简报及证据下载。见 参赛演示说明。
- SQLite 大表不会整表进内存。 超过 10 万行只载入前 10 万行;全量请用
query_database聚合后再adopt。CSV 也可用该工具,表名为data。 - 换新数据重跑: 报告上的「按配方重跑」读取
analysis_recipe.json,按上次工具参数执行,不重新规划。 - 给业务的文件: 导出菜单可下载 Word / PPT;「分析溯源 (.json)」给出报告对应的数据集、工具调用与产物哈希链及复核结果。
- 样例行在发给模型前会脱敏手机号、邮箱、身份证号;不要依赖它代替完整的数据治理。
项目结构
src/data_agent/
  api.py             FastAPI 应用装配与前端静态资源托管
  agent.py           DataAnalysisAgent:Plan-and-Execute + ReAct
  cli.py             Typer 命令行入口
  config.py          环境变量驱动的运行时配置
  nodes/             LangGraph 节点(validate/plan/execute/replan/finalize)
  tools/             ReAct 工具集(检查/清洗/转换/合并/数据库/统计/可视化/导出/沙箱)
  metrics.py         指标口径登记(可选,规划阶段注入)
  provenance.py      分析溯源哈希链(数据集 / 工具 / 产物 / 报告)
  verification.py    逐结论确定性核验与 JSON 报告(verified/conflict/unsupported)
  evalkit/           发布前评测闸门(McNemar / Wilson / ledger / CLI)
  sqlite_source.py   只读 SQLite 数据源(表发现 / 结构描述 / 受限查询)
  postgres_source.py 只读 PostgreSQL 数据源(服务端只读 + statement_timeout)
  sql_guard.py       驱动无关的只读 SQL 护栏(两个数据源共用)
  mcp_server.py      MCP 数据面服务(stdio,供其他 Agent 调用)
  echarts_engine.py  ECharts 图表引擎(与 Plotly 引擎并列)
  deployment.py      LangSmith Agent Server 图入口
  storage.py         本地 / S3 兼容对象存储后端
  middleware.py      CORS / GZip / 访问令牌 / 速率限制
  routers/           会话 / 分析 / 产物 / 设置路由
frontend/            React + Vite 前端(构建产物 frontend/dist 由 `npm run build` 生成,不入 git)
examples/            示例数据
tests/               pytest 测试
部署
- Docker:根目录
Dockerfile两阶段构建(Node 构建前端 + Python 运行时),以非 root 用户运行并带健康检查。容器监听0.0.0.0,必须设置APP_ACCESS_TOKEN,否则进程启动即报错退出。 - 访问令牌:监听非环回地址(如 Docker / Render 的
0.0.0.0)时必须设置APP_ACCESS_TOKEN;本地127.0.0.1开发可留空。 - LangSmith:
langgraph.json导出data_analysis_agent图,可直接创建 LangSmith Deployment;数据集通过dataset_id或受控dataset_path提供。 - Render:根目录
render.yaml提供 Blueprint 一键部署(Free 档可直接同步成功)。首次创建 Blueprint 需在 Render 控制台批准首次同步——状态为Created时autoSync不生效,批准后推送才会自动同步;文件内注释含 Starter 及以上档位启用持久磁盘的完整配置。Free 实例休眠后容器存储会清空,长期保存数据请启用 S3/R2 后端。 - CI:
.github/workflows/ci.yml在 push / PR 时自动执行 ruff、pytest(含 240s 单测超时保护与--cov-fail-under=97覆盖率门禁)与前端类型检查、测试及生产构建。
质量检查
.\.venv\Scripts\python.exe -m pytest -n 4   # 后端测试(默认并行 4 路;不调用真实 LLM,不产生费用)
.\.venv\Scripts\python.exe -m ruff check .  # 后端代码检查
cd frontend && npm run typecheck            # 前端 TypeScript 类型检查
cd frontend && npm test                     # 前端单元/组件测试
cd frontend && npm run build                # 前端生产构建
后端测试覆盖 src/data_agent 全部核心路径(节点、工具、路由、注册表、存储、
CLI、部署),含异常分支与降级路径;CI 中以 DATA_AGENT_SKIP_KALEIDO=1 跳过
偶发挂起的无头 PNG 渲染(503/500 降级分支仍被覆盖)。
深入文档
- docs/engineering-notes.md — 工程笔记:已验证的工程事实与踩坑记录(大数据图表可读性方案、可访问性校准方法、性能与体积预算、沙箱/隐私/指标模块设计要点、平台差异实证)。
- docs/competitive-analysis.md — 竞品分析:与同类数据分析 Agent 产品的定位与能力对比(2026-09 初查 + 2026-11 官方一手页实地复核,含抓取矩阵与可达性负证据)。
- docs/agent-eval.md — 发布前评测:配对结果格式、McNemar 精确检验、成本/延迟护栏、ledger 校验与 CI 接法。
- docs/analysis-provenance.md — 分析溯源:哈希链格式、API 与离线复核方法、信任边界。
Reviews (0)
Sign in to leave a review.
Leave a reviewNo results found