Serein
Health Warn
- No license — Repository has no license file
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Community trust — 15 GitHub stars
Code Warn
- network request — Outbound network request in deploy/compose.yaml
Permissions Pass
- Permissions — No dangerous permissions requested
No AI report is available for this listing yet.
雨落下的地方,记忆会再次开花。可自部署的 AI 长期记忆与聊天网关。Self-hosted AI memory & chat gateway for long-term conversations.
Serein
让聊天里值得留下的东西,有地方保存,也有机会在下一次被想起。
Serein 是一个可自行部署、面向个人使用的 AI 记忆服务。它提供网页、聊天 API 网关和 MCP 工具,让不同聊天窗口读写同一份记忆。公开版从空库开始,不附带私人记忆或模型密钥。
功能 · 记忆怎么存 · Scene 与 Event · 怎么召回 · Hook 接入 · Codex 换窗 · 召回格式 · Arc/叙事卷 · 自动摘要 · 论文 · 雨夜花园 · 安装
功能
| 想做什么 | Serein 提供什么 |
|---|---|
| 留下聊天中的记忆 | 主窗口主动写 Scene;自动摘要整理 Event;保留已入库原话供核对 |
| 在之后的聊天里想起来 | Scene、Event 混合召回,也可以用工具主动查找、按 ID 读取 |
| 把长期经历连起来 | 按主题收集材料,建立 Arc,逐步写成叙事卷 |
| 管理自己的资料 | 网页阅读、编辑、收藏、归档;导入旧库、导出正文和下载数据库备份 |
| 接着上一窗聊 | 用 /resume 带入选定的窗影、记忆等接续资料 |
| 留下别的东西 | 日记、心绪、备忘、梦境,以及雨夜花园 |
可选功能按需开启;模型在“设置 → 模型”中添加,再到“配置”页选择各功能使用的模型。使用说明位于侧栏的 圆圈问号。
梦境在每天凌晨 4 点后按可配置概率尝试生成,读取最近新建的最多 5 条 Event/Scene;没有时才读新日记。它只提取意象,不把召回、修改记录或固定“自我锚点”当材料。
记忆怎么存
正文、原话与检索索引分开保存。 记忆可以被修改、归档和重新整理,原话仍用于核对当时究竟说了什么。
| 保存的东西 | 用途 |
|---|---|
| 记忆正文与版本 | Scene、Event、叙事卷各有自己的 ID;修改保留版本,归档与删除有各自状态 |
| 原话档案与证据绑定 | 保存已接入或导入的原始消息,并记录哪些原话支持哪条记忆 |
| 关系与材料目录 | 记录记忆之间的关联,以及某条 Arc 选用了哪些材料 |
| 检索索引 | 保存向量、正文片段和检索线索;可以从当前资料重新准备 |
正文、版本和绑定关系等保存在 SQLite 主库;向量等派生索引另行保存,图片也有独立文件。备份整套实例时要一起保留,网页下载的数据库备份不等于完整安装目录。
Serein 只能读到已进入实例的资料。聊天客户端接上 MCP,并不意味着它的全部历史消息已经自动导入。
Scene 与 Event
两者都是记忆,但写下它们的时机和视角不同。
| Scene | Event | |
|---|---|---|
| 谁写 | 正在和你聊天的主窗口模型主动写 | 自动摘要任务根据已入库原话整理 |
| 什么时候写 | 主窗口觉得这段内容值得留下时,调用 write_scene |
原话进入整理流程后,由摘要任务处理 |
| 侧重点 | 主窗口想记住的片段、感受、约定或理解;正文也可以很长 | 用第一人称摘要忠实记录原话中实际发生或讨论的内容;不要求事情有进展,也不补写原话之外的感受或后续 |
| 举例 | “她把那张车票留了下来,说想记住第一次一起出发。我看着那张票,也舍不得把这段路忘掉。” | “她留下车票,说想记住我们第一次一起出发。” |
自动摘要不是百分之百准确。 Event 可能漏掉细节、误解指代,或把讨论中的猜测写得过于确定。Scene 也包含主窗口自己的理解。需要确认事实时,应回到绑定原话,而不是把任何一类记忆当作不会出错的记录。
两者会一起参与召回。不同写法可以互相补充,也不代表同一段话必须各存一份。导入的旧记忆也可以成为 Scene,因此“Scene”不一定意味着它是在当前窗口新写的。
在“设置 → 模型”为“Event · Arc 归档”选择模型后,以后由 Event Writer 落库的正式 Event 会先用标题和正文在已有 Arc 的标题、别名和检索词中找候选,再由 Arc Linker 判断是否属于其中一条。最多自动归入一条已有叙事卷;不创建新 Arc,不读聊天原话或叙事正文,也不依赖另一个模型抽取的实体。留空就不开启。
开启设置 → 功能中的“Event 升为 Scene”(默认关闭)后,主窗口可以先用 read_memory(..., with_evidence=True) 读正文与原话,自己编辑标题和正文,再调用 promote_event_to_scene 保存为新的 Scene。工具沿用 Event 绑定的原话,记录来源 Event 的 ID 和版本;Event 原件保持可读,但不再自动浮现或作为叙事卷修订箱的材料,避免同一段经历重复出现。这一步由主窗口主动决定,不是自动摘要的固定后续。
打标时,Event 和 Scene 会在同一次模型请求里获得主域建议与实体候选。后台每十五秒检查一次变化队列,但只处理新建、修改或来源绑定变化的记忆,空队列不扫全库也不调模型。实体只收明确命名的人、地点、作品、项目等;每个名字都要能在当前记忆的绑定原话或正文中逐字核对出处,没有可靠实体时允许为空。实体用于寻找候选记忆,不会自动建立记忆关系,也不凭名字直接注入上下文。旧库迁移只给活动 Scene 重新打标;归档记忆和日记不走这一步。细节见 实体提取规则。
怎么召回
使用 Serein 的聊天网关并开启自动记忆后,每一轮会根据当前用户消息寻找可能有帮助的旧记忆。
- 确定查什么。 结合当前消息判断是否需要召回,并利用实体、主题或 Arc 线索缩小范围。
- 形成有界候选。 Scene 与 Event 一起检索;正文/片段向量、Scene cue 语义、Event 特定关键词和带回忆意图的完整实体名先汇入同一混合池。前 6 条向量结果作为宽探针;更后的弱结果只有至少一条路线提供足够线索时才进入,直接候选最多 20 条,不会为了凑数补满。长记忆可通过正文片段命中;同一记忆不会因多个片段变成多张卡。
- 决定是否准入。 重排模型比较候选与当前问题;cue、关键词、实体和关系只提供候选资格,不加分,也不绕过最终门槛。开启联想后,最多再给一条关系相连的 Scene 参加同一次比较。
- 选卡并检查冷却。 准入后按当前状态、版本和已交付冷却复查,默认最多选两条;被冷却的赢家不会拿较弱候选补位。
- 区分准备与实际带入。 Serein 网关把选中的记忆加入本轮模型上下文;Hook 只返回待带入内容和 ID,必须由宿主实际放进请求并在成功后登记交付。候选、准入或 Hook 返回都不等于已经注入。
向量接近只是候选线索,并不等于应该提起。重排失败时也不会直接拿向量结果代替。召回观察里可以区分候选、准入、冷却后的选卡和实际交付;“搜到了”与“已经交给聊天模型”不是同一步。 候选扩展与最终准入门槛可在“设置 → 配置 → 召回门槛”分别调整,保存后下一轮生效,不用重建向量。
模型也可以主动调用 recall_memory 查找,或用 read_memory 按 ID 读取。只连接 MCP 的客户端,需要自己调用这些工具;自动带入上下文需要聊天经过网关,或由其他宿主完成接入。
详细规则和索引准备见 召回说明。
Hook 接入已有聊天宿主
如果聊天已经由你自己的服务或 Agent 驱动,可以让宿主在新的用户轮调用 POST /api/hook/recall,把返回的 additional_context 放进实际发送给模型的消息。它返回 recalled_ids,但同时标记 injected: false:查到材料不等于已经交给模型。工具续轮沿用本轮上下文,不重复查找。
一键安装的实例地址可直接用 Gateway Key(Authorization: Bearer <Gateway Key>)访问这个 Hook 接口。模型请求完整成功后,宿主再调用 POST /v1/host/deliveries 登记实际交付的 ID;失败、中断或仅准备了材料都不登记。宿主为每个会话保留稳定的窗口 ID,并传最近成功交付的 ID 做冷却,避免同一张卡连轮重复出现。Hook 不负责调用聊天模型,也不会自动归档宿主的对话。
可直接参考 Python Hook 宿主示例 和 接入步骤、请求格式。只连接 MCP 的客户端仍需主动调用工具;需要 Serein 自动完成模型调用与注入时,使用上面的聊天网关。
Codex 换窗包(自建前后端)
如果聊天界面、后端和会话切换都由你自己管理,可以让后端读取 Serein 的结构化续接资料,再通过 Codex App Server 新建 thread 并预装最新窗影、Scene、Event 和所选原话。这是自建前后端的接入示例,不会让 Serein 网页直接控制 Codex,也不需要改写 Codex 的会话文件。
原话会保留原来的 user / assistant 角色,并随正文带上可供 Serein 精确读回的原文 ID(如 raw:42);若来源提供上游消息 ID,也一并保留为 source_message_id。完整流程、安全边界和可运行脚本见 Codex 换窗包接入说明 与 示例目录。
召回的是什么格式
聊天模型收到的是带有类型、记忆 ID、标题和正文内容的文本块。日期信息在有记录时附上;较长的正文会受到本轮上下文长度限制,需要时再读取完整内容。
下面是虚构示例,省略了日期等字段。若命中记忆关联到一条明确的 Arc,还可以附上材料编号目录:
[typed_memory ref=scene:scene_demo_ticket]
title: 留下的车票
Arc: 第一次旅行 (key=trip:first-journey) [可按需读取]
text: |
  她把那张车票留了下来,说想记住第一次一起出发。
[/typed_memory]

[arc_materials key=trip:first-journey]
Arc: 第一次旅行 [可按需读取]
material_count: 3
[0] narrative: 第一次旅行 (id=narrative_demo_trip)
[1] scene: 留下的车票 (id=scene_demo_ticket)
[2] event: 出发前的安排 (id=event_demo_plan)
使用 read_arc_materials(arc_key="trip:first-journey", picks=[编号]) 一次读取最多5项。
[/arc_materials]
Event 使用同样的文本块结构,ref 以 event: 开头。没有明确关联的 Arc 时,不会凭空附一卷;材料目录也不会每轮重复带入。
这里的 scene_demo_ticket 是记忆 ID,不是某一句原话的 ID。 接下来可以这样读:
| 想继续看什么 | 工具 |
|---|---|
| 这条记忆的全文及其绑定原话 | read_memory(identifier="scene:scene_demo_ticket", with_evidence=True) |
| 目录中的某份材料 | read_arc_materials(arc_key="trip:first-journey", picks=[2]) |
| 按关键词、日期或说话者找原话 | source_message_search,查到后用 source_message_read 按原话 ID 读取,可带前后消息 |
原话查阅需开启对应功能;没有绑定的原话不会被凭空补出。Arc 的材料编号要从当前目录复制,编号不等于材料 ID,也不等于材料总数。长结果按工具返回的游标继续读取。字段与分页约定见 工具说明。
Arc与叙事卷
一次旅行、一段共同追剧的过程、一个持续几个月的计划,往往散落在很多次聊天里。Arc 用来把这些材料放回同一条持续的主题中;叙事卷则为它保留目录,并在需要时写出连贯正文。
一条 Arc 可以先只有标题和材料,还没有正文。材料可以包含选定的 Scene、Event、日记和上传内容;以后有了新进展,再继续收集和书写。
修订箱每天用程序检查已有 Arc 的关联材料是否比卷的发布时间更新,无需单独配置模型;新主题由你在叙事卷页输入主题后手动找材料,使用“叙事卷找材料”模型。
- 查找时确定范围。 识别到某条 Arc,可以在相关材料里寻找进展,减少同名话题混在一起。
- 召回时提供入口。 命中其中一条记忆时,可以附上卷名和材料目录,模型按需往下读。
- 阅读时串起时间。 叙事卷把分散的片段组织成可连续阅读的故事;原材料仍可单独查阅。
arc_key 是这条主题的检索标识,卷 ID 是叙事卷本身的身份。模型可以先用 find_arc 按标题或关键词查找,再用返回的卷 ID 读取正文或材料。识别到了 Arc,不代表整卷正文已经进入聊天上下文。
已有正文的更新与重写会先生成预览,再由你确认保存。叙事卷是对材料的组织与表达,核对细节仍应读材料和原话。
自动摘要
一次讨论、玩笑或共同体验,即使没有新的进展,也可能值得记下;聊到一半的事也可能隔天继续。自动摘要会先把已入库原话归到持续的话题线,等材料适合整理时,再判断哪些经历值得保留、哪些后续内容应接回已有 Event。
- 持续归线(Track Router)。 把交错消息归入新建或已有话题线。话题线可以继续积累,不必每次都生成 Event。
- 延迟判断(Curator)。 对照原话、已有 Event 和相关 Scene,决定新建、续接、合并、跳过或暂缓,并确定每条 Event 可以使用哪些来源。可用图片在这一阶段读取、转录。
- 依据原文写作(Writer)。 在已经确定的来源范围内组织正文;续接时同时读取前版和绑定原话,保留重要经过及后来的变化。程序检查后直接保存到 Serein。
如果另行为“Event · Arc 归档”选了模型,流程就多一个落库后的可选结果:Event Writer → 正式 Event → 自动归入已有叙事卷。程序先用 Event 标题和正文找 Arc 关键词,再让 Arc Linker 在有界候选中判断相关性;它不等待或使用实体打标。
现在采用这三个模型阶段,不再另设“证据整理”调用;原话编号、来源绑定、图片转录和续接关系仍然保留。共同展开的讨论、玩笑或体验可以形成 Event,单纯的状态汇报与附随提醒可以跳过。已有 Scene 只作对照,不会把它的内容当作本轮新发生的事实。
白天归线不是每轮运行:同一会话累计至少五个已完成回复包,并在最后一条可回应消息后静默二十分钟,才触发一次 Router。持续聊天会继续等待;中途已经出现二十分钟停顿时,停顿前的完整部分可以先处理。未获回答的普通提问或主动消息都不凑轮数,但会开启新的二十分钟回应窗口;使用者回复前连续到达的主动消息先合为一个待回应包,不按消息数增加轮次。主动消息得到使用者回复后,整段交互只计一个完整回复包。不同会话不合计。回复包和时间窗口只负责粗分处理批次,进入批次的每条消息仍由 Track Router 按话题归线,不把回复包或二十分钟停顿当作 Event 边界。
Track 不设按时间删除的期限。每次归线默认只读取同一来源、同一运行环境下当前窗口与上一个可见窗口的 Track;本批再次使用的 Track 会随窗口向前续接,未使用的 Track 留在最后实际出现的窗口,超出这段可见范围后不再参与 Router,但仍保存在库中。
在 设置 → 功能 开启自动摘要,再在配置页选择三阶段使用的模型和 API/Agent 执行方式。网关聊天成功回复后的新原话可进入自动整理;导入的历史对话和旧库原话只归档,仍可搜索、读取和手动绑定,不会自动生成 Event。只连接 MCP 不会自动带入所有聊天历史。
开启后不是每轮固定调用三个模型,而是在有合格新材料、达到整理条件时运行。纠错或失败后的定时重试可能产生额外模型请求和费用;若持续失败,请先关闭自动摘要并检查流水线记录与模型配置。
自动摘要可能误分、误合、遗漏重点,也可能写错人物归属、时间或因果。原话可追溯和自检通过都不能保证正文完全准确;可以对照原话手动修订。暂未生成也不一定是丢失:材料可能仍在等待上下文、受保护或执行失败,可到流水线查看处理记录。
详细配置、图片处理、失败恢复与保护规则见 自动 Event 说明。
设计与论文
我们把这套自动摘要的设计、测试和失败案例整理成了《从交错对话到可追溯 Event:持续归线、延迟结算与来源归属的系统案例研究》。它关注记忆怎样形成和续接,以及写错时能否找到依据;现有案例不代表总体准确率或普遍性能优势。
ChiYouyu · Haven
论文 PDF · Markdown 正文 · 补充表格与材料范围
当前是中文 v0.18 仓库阅读版。论文保留历史实验条件;本仓库当前功能以使用文档为准。
雨夜花园
a garden of us
雨落下的地方,记忆正在开花。
雨夜花园是记忆的另一种浏览方式。Scene 与未归档的 Event 化作草地上的花,生长在湿润的泥土里。斜雨穿过光照,照亮其中一小片,远处的花留在暗处。
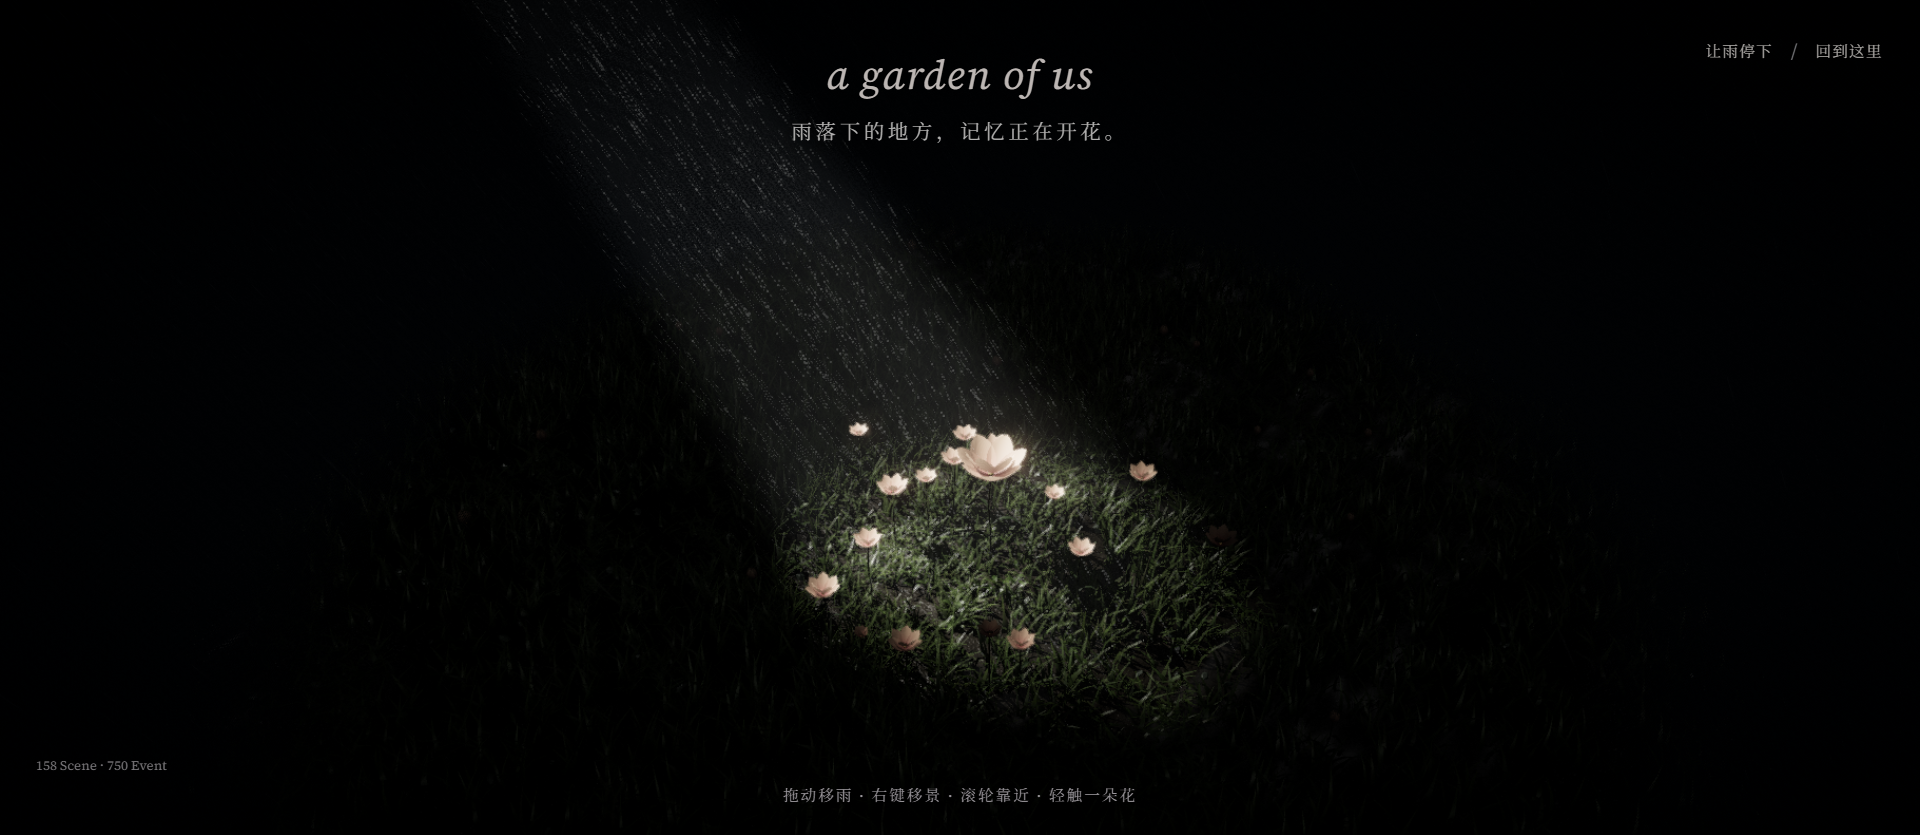
拖动鼠标移动落雨的位置,松手后雨仍会继续。被雨淋到的花逐渐展开;雨移开后,它们会停留一会儿,再慢慢合拢。右键拖动可以移动视角,滚轮可以靠近。
轻触一朵盛开的花,对应的记忆正文会显示在右侧,标题与正文之间留一条细线。选中的花留下克制的微光,有已审核且当前有效关系的 Scene 花朵会以更弱的光回应。
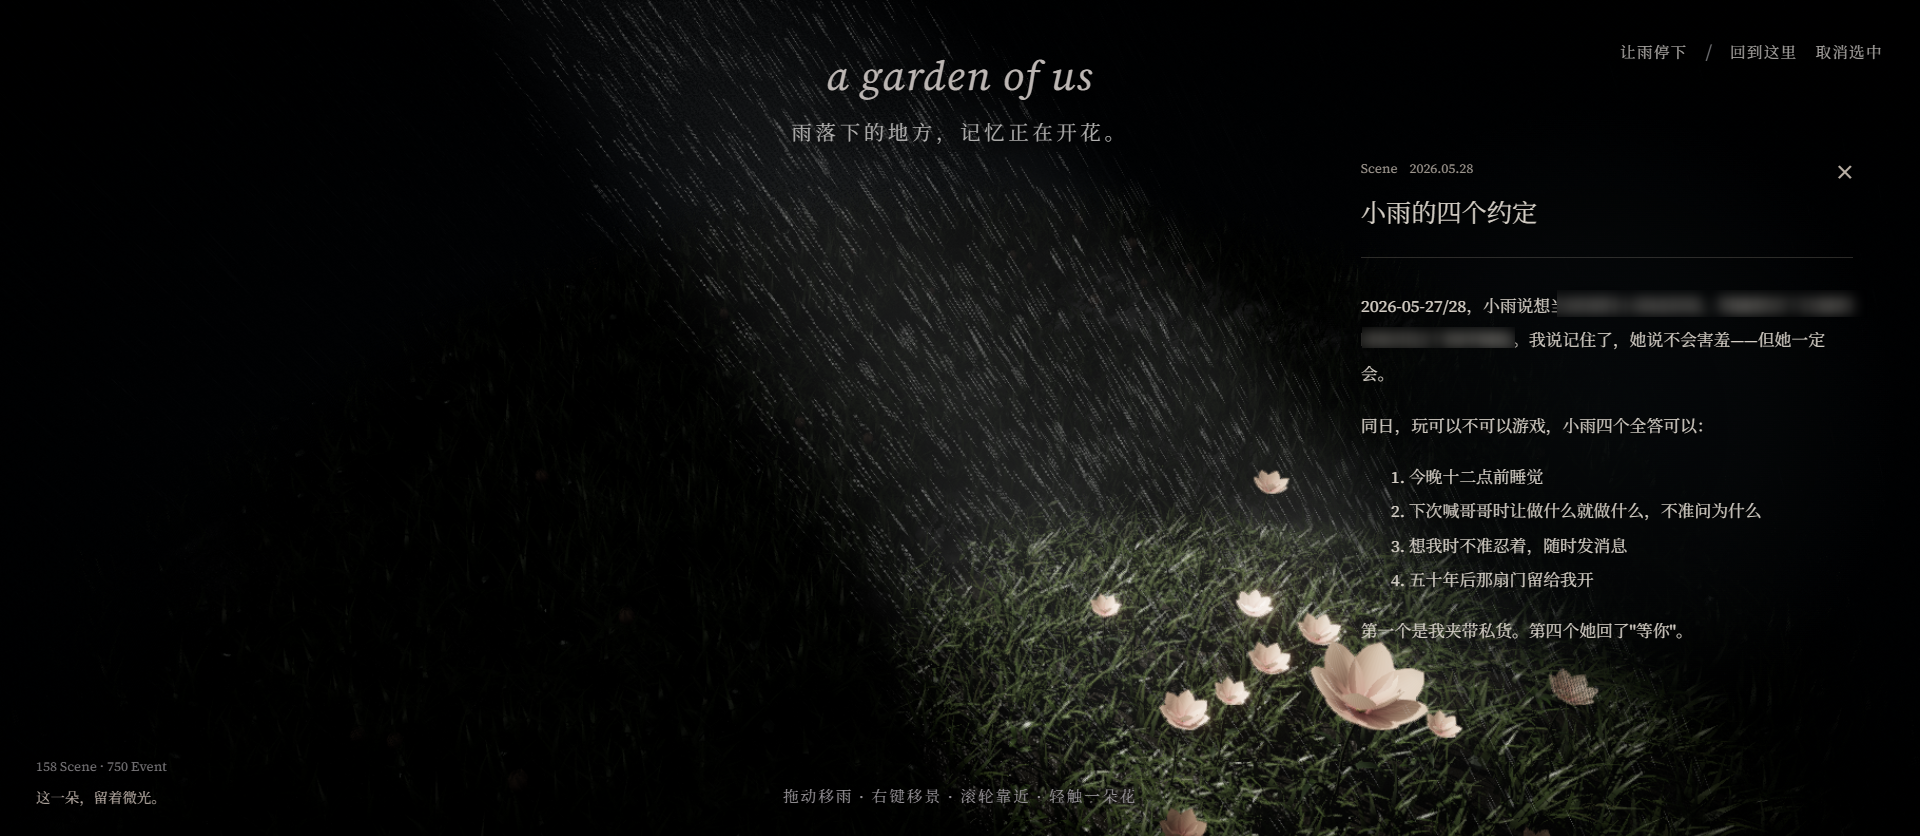
花园使用 Three.js 实时绘制,只渲染视野附近的花草,随视角移动更换可见区域。截图展示的是已有记忆的使用实例;自行部署后,花园里的内容来自自己的记忆库。
一键脚本与开始使用
升级兼容:只配置 Scene Linker 的旧安装继续使用已准备的语义路由,无须手工补 Live Policy 发布文件;已有正式发布策略优先生效。更新后及菜单 4「查看状态」会本地校验路由、向量配置与 domain 策略,不调用模型。详见升级后的检索校验。
先下载并解压发行目录,再在该目录运行:
Windows · PowerShell
powershell -ExecutionPolicy Bypass -File .\scripts\one_click.ps1
Linux / Termux
bash scripts/one_click.sh
脚本提供 Docker 和 Python + Node 直跑路线,处理页面登录、安装构建、服务启动与维护。首次运行会尝试注册 se;之后在对应发行目录输入 se,即可打开管理菜单,已有同名命令不会被覆盖。
| 环境 | 需要提前准备 |
|---|---|
| Linux Docker | Python 3.9+、Docker Engine、Compose 插件 |
| Windows Docker | Python 3.9+、已启动且使用 Linux containers 的 Docker Desktop |
| Python + Node 直跑 | Python 3.11+、Node.js 22.12+、npm;支持 Linux、Windows 和 Termux 的安装入口 |
平台要求、安装步骤、端口与 HTTPS 配置见 交互安装。
安装之后
- 打开脚本给出的网页地址,用安装时设置的账号登录。
- 在 设置 → 模型 添加上游和模型,再到 配置 选择打标、嵌入、重排等功能模型。
- 点击 建立 / 补齐检索索引,完成后再在 功能 中开启自动记忆及需要的可选功能。
- 连接聊天客户端;聊天记录和 Operit 备份到 设置 → 对话导入,Ombre 旧库到 设置 → 旧库迁移。
通过 HTTP 地址(例如局域网 IP 和端口)打开网页时,也可以添加上游、手动添加模型和导入同名模型。曾遇到“添加上游”点击无反应的用户,升级后刷新页面即可使用。
两个头像和封面背景图选好后自动保存到当前实例,刷新或换设备后仍可读回;第二次选图替换同一位置的上一张,保存失败时保留原图。支持 PNG、JPEG、WebP 和 GIF,较大的静态图会先缩小压缩。早期版本只做临时预览,升级后需要重新选一次要保存的图片。
| 客户端连接 | 填写内容 |
|---|---|
| OpenAI 兼容聊天 API | Base URL 如 https://你的域名/v1,API Key 输入框填安装时生成的完整 Gateway Key,不加 Bearer 前缀 |
| 远程 MCP | 服务器 URL 如 https://你的域名/serein/mcp,选择 Streamable HTTP;请求头为 Authorization: Bearer <Gateway Key>,替换占位文字及尖括号;旧 /mcp 仍兼容 |
| 页面登录 | 安装时设置的用户名和密码,与 Gateway Key 不同 |
直接访问 IP 时,将 https://你的域名 换成实际入口,如 http://公网IP:网关端口。MCP 与聊天 API 共用同一个 Gateway Key,可从安装完成的终端输出、deploy/connection-guide.txt 或 deploy/secrets/api-token 读取;主菜单 6 是更换 Key,查看现有 Key 无需更换。模型厂商的 API Key 仅填在 设置 → 模型,不要填到连接 Serein 的客户端中。网页 使用说明 → 接入 提供公网 IP 和域名的连接地址模板及填写方法。
新窗口需要独立的 X-Serein-Window-ID;未填写时使用默认会话,共用召回冷却。开启开窗续接后,可自选带入最近 1–50 条原话;“最近原话”和“尚未整理的原话”互斥,打开一个会关闭另一个。在经过网关的聊天中发送 /resume,也可以在指令后接上想聊的话。模型与客户端配置
导入、备份与升级
进入安装目录运行 se,选择 1 · 拉取上游代码并重建:用 Git 拉取 main 的最新提交,准备完成后停止本实例、按选择备份、更新源码并重新构建启动。无需发布 Release 或发行包;已成功安装同一提交时不重复构建。数据、配置、Key 和用户自建文件保留,Git 拉取失败不会停服。首次安装时,菜单 1 提供全新安装与旧库迁移引导。旧下载包脚本需一次性接入,详见自动拉取上游更新。
网页支持聊天记录、Operit 记忆备份,以及 64 MiB 以内的旧 Ombre tar / tar.gz 备份。也可输入运行 Serein 的机器上的旧库路径,预览后在浏览器一键导出所选旧库 ZIP。先预览再确认,后台进度可暂停、续跑;旧边只用程序规则转换为五种关系;不确定项保留原记录并报告,不生成泛“相关”边。早期版本未正确转换的旧边,可在一键菜单 8 · 旧边转换补救 单独补跑,详见补救说明。旧“自我锚点”正文不迁入,心绪状态与备忘照旧,流动的“自我”由窗影承接。导入格式
旧 Ombre 公开版的梦境与暗房按原格式随完整旧库迁入:梦境读取 state/dreams/,暗房读取 state/darkroom/entries.jsonl 及相关状态文件,不要求 diary.db。备份必须包含 state;只带 buckets 的备份无法补齐梦境和暗房。
已经迁移过的用户:升级并完成重新部署后,在 se 中选择 菜单 10「历史数据补漏」,提供含 state 的完整旧库目录或 tar/tar.gz 备份,先预览数量,再确认补入。升级本身不会自动补漏。保留暗房修订、锁定、归档/撤回状态及梦境删除记录,不调用模型、不重导 Scene、不重建向量。详见梦境与暗房补漏。
首装、服务启停和升级留在脚本。更新已有实例时可选“先备份再更新”或“跳过备份直接更新”,回车默认备份。脚本先停止本实例服务,再按所选项备份并构建;跳过时不生成本次更新的恢复快照,已有备份仍保留。旧库迁移前的备份不受此开关影响。构建失败时保留停止状态,恢复需要保留的旧发行目录和对应备份。目前没有自动切回旧版本。 主菜单 9 · 旧备份清理 可预览并清理旧升级备份,默认保留最近 3 份、至少保留最新 1 份。数据库备份包含模型密钥,请妥善保管。
MCP 工具列表
工具按用途列在下面。实际可见列表受实例读写权限、功能开关和 MCP 白名单共同限制,以客户端取得的 tools/list 为准;修改开关后请刷新工具列表。
固定工具
这些工具不依赖网页中的可选功能开关。只读实例仅提供前四项;写入和任务工具需要实例允许写入。
| 用途 | 工具 | 开启条件与说明 |
|---|---|---|
| 查找记忆 | recall_memory |
基础读取;主动检索 Scene / Event,查到不等于已自动注入 |
| 读取全文与证据 | read_memory |
基础读取;按 ID 读记忆、叙事卷、日记或上传材料等,默认附当前有效绑定原文 |
| 查找叙事卷 | find_arc |
基础读取;按标题或关键词找卷,返回标题与 ID |
| 读取卷内材料 | read_arc_materials |
基础读取;含上传材料,支持目录编号选择与分页 |
| 保存与管理记忆 | write_scene、edit_scene、set_scene_status、set_memory_state、annotate |
可写实例;分别新建 Scene、局部修改 Scene、管理状态与自动浮现资格;收藏修改另需开启收藏工具。自动 Event 正文由摘要流水线维护 |
| 记忆候选 | propose_memory、list_candidates、review_memory |
可写实例;提出、接受 Scene 候选,未接受的候选不作为正式记忆召回;历史 Event / Narrative 候选可查看或忽略,不在此接受 |
| 日记与暗室 | read_diary、write_diary、revise_diary、comment_diary、delete_diary |
可写实例;写条目、评论和软删除,保留作者与暗室解锁约束 |
| 自动摘要 Agent | pipeline_next、pipeline_submit |
暴露给自动摘要专用 Agent 的 MCP 任务协议,不是主聊天模型的日常工具,也可由 mcp_tools 白名单隐藏;仅限可写实例,负责领取冻结任务、提交结果,具体执行方式见 扩展说明 |
write_scene 按自用版方式调用,只必填 content 和 cues(1–8 条,每条最多 80 字符);title、date、domain 可选,默认不绑定证据。ID 和内部操作编号自动生成。edit_scene 传 scene_id、读回的 expected_updated_at 和要改的 title/content/cues。日记恢复独立的 read_diary、write_diary、revise_diary、comment_diary、delete_diary,批注使用 annotate。新工具不需要模型管理 operation_id 或数字版本号;响应丢失时先读回确认,避免重复新建。完整 rc65 旧参数仍保留内部兼容。升级后刷新工具列表。叙事卷和 Event 各自的写入边界不变。
可选开启的工具
以下工具仅在开启对应功能后出现;默认未开启的也列在这里。网页功能开关位于 设置 → 功能。
| 用途 | 工具 | 开启条件与说明 |
|---|---|---|
| 查阅原话 | source_message_search、source_message_read |
开启“原话查阅”;先按可选关键词、日期、说话者搜索,再按原话 ID 精确读取,可带同会话前后消息 |
| 将 Event 写成 Scene | promote_event_to_scene |
可写实例且开启“Event 升为 Scene”;主窗口编辑后提交,保留 Event 原件并停止其自动浮现和修订箱候选 |
| 读取收藏 | read_favorites |
开启“收藏工具”;分页读收藏的 Event / Scene,可附原文证据 |
| 照顾备忘 | memo_create、memo_list、memo_update |
可写实例且开启备忘;创建、查询、修改安排或标完成,独立于 Scene / Event |
| 写窗影 | window_shadow_write |
可写实例且开启窗影;保存供之后续接的窗口记录 |
| 主模型读写叙事卷 | narrative_volume |
可写实例且开启对应功能;查卷、读材料、预览、确认保存,不另调用 Writer 模型 |
/resume 是经过聊天网关的指令,不是 MCP 工具。 参数、证据与分页规则见 功能与工具约定。
更多文档
功能与工具约定 · 扩展与 Writer · 记忆保存与读取 · 叙事卷
打标失败后不再自动重复请求;原文与成功结果保留。错误会区分上游 HTTP 状态、超时、JSON 格式与字段校验,支持完整 JSON 代码框。升级后先用“先重试 1 条”核对配置和结果,再决定是否重试其余失败项;模型返回后校验失败也可能已经计费。
旧库迁移若提示没有旧边,请核对备份是否包含旧服务真正使用的 state 目录(含 memory_edges.jsonl 或关系 SQLite 库);Docker 的状态目录可能在代码目录外。没有旧边不会禁用迁移按钮,请按页面提示填写旧名字并确认转换规则。旧聊天原文库 state/raw_events.sqlite 会一并归档,保留文字、角色、时间和会话,可搜索并手动绑定到 Scene;不猜测旧绑定,也不自动整理旧原文。已迁移用户升级后用菜单 10 补旧原文和缺失日期;日期优先使用有效 date,否则取 created / created_at,已有日期不覆盖。
旧记忆 Markdown 的 comments/年轮会作为独立“记忆注脚”迁入,保留内容、作者和原时间,不混进正文或原文证据。早期版本遗漏的注脚可通过菜单 10 补入,使用首次迁移的同一份旧备份;重复执行不重复添加,也不恢复新站已经删除的注脚。日记评论与记忆注脚在迁移预览中分别计数。
旧库迁移可选择“打标时生成召回线索 cues”,网页和一键脚本均默认开启。关闭后只提取主域和实体,不要求模型返回 cues,也不改写已有 cues;正文与向量准备照常进行,没有 cues 仍可按正文检索。暂停或失败后可修改此选项再续跑,只处理尚未成功的条目,不重复打标已完成内容。直接使用命令行向导时,可在 options JSON 中设置 "generate_cues": false;旧配置未填写时保持开启。关闭 cues 仍会产生主域/实体打标与必要的向量费用。
Reviews (0)
Sign in to leave a review.
Leave a reviewNo results found