llm_course
Health Gecti
- License — License: MIT
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Community trust — 34 GitHub stars
Code Uyari
- fs module — File system access in .trae/skills/course-beautify/references/shot.js
- network request — Outbound network request in proxy/embed-tool/remote-worker.js
- network request — Outbound network request in proxy/embed-tool/worker.js
Permissions Gecti
- Permissions — No dangerous permissions requested
Bu listing icin henuz AI raporu yok.
写给算法工程师的大模型课程:34 课,每课从一个问题出发,用具体数字把机制从头算一遍
第一性原理大模型课程
读完一个机制,你能不能在白板上用几个数字,从头把它算一遍?
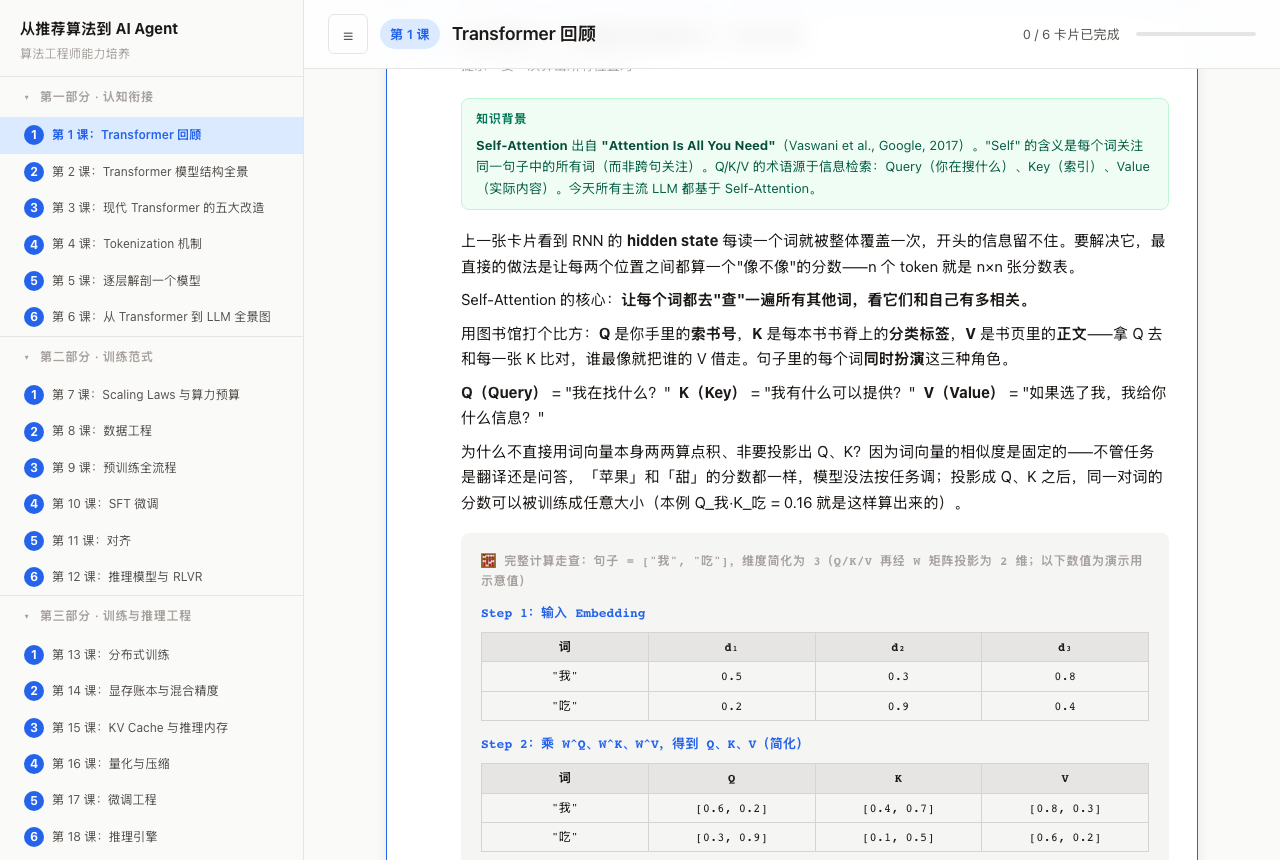
这套写给传统算法工程师的大模型课程,从 Transformer 一路讲到 Agent:34 课、204 张卡片,每张从一个问题出发,用具体数字把机制算清楚。
既是我自己的学习笔记,也想分享给同样要补大模型知识的人,欢迎提意见。
English: A 34-lesson Chinese LLM course for algorithm engineers (recsys → Transformer → training/inference engineering → Agents). Every mechanism is worked through by hand with concrete numbers. Single HTML page, no login.
在线阅读:https://zhuangzhaoyeye.github.io/llm-course/(每课一个独立网址、免登录、手机可看)
如果这套课对你有帮助,欢迎点右上角 Star,也欢迎 提 Issue 纠错或反馈。
想在新课上线时收到通知:
- 点仓库右上角 Watch → Custom,勾选 Releases 和 Discussions,只收新版本和讨论,不会被每次提交打扰。
- 不想用 GitHub 账号:把 提交订阅源 加到任意 RSS 阅读器。
- 想提问、交流学习心得、分享你的推导:来 Discussions 讨论区。纠错请用 Issue,方便追踪。
为什么做
我是做推荐算法的,转向大模型时发现:痛点不是资料太少,而是读过 ≠ 会用。所以做了这套课,有两个目的:
- 自用 + 分享:把"算法工程师学大模型"这条路径整理成能顺着读的课程,不用再各自找论文、问 AI、核对数字。
- 长期探究:能不能让 AI 一键生成质量过关的课程?课程既是产品,也是这个问题的实验场,下文会如实说明做到了哪一步、哪里还不行。
理念:从"记住结论"到"自己推出来"
传统教程的症结是"知识树"。 先分类,再逐类填充,你记住的是层级关系("Self-Attention 是 Transformer 的组件,Q/K/V 是三个矩阵")。但分类是专家回顾时的视角,不是学习时该走的路。你还没遇到"RNN 处理长句会丢信息",就被告知"Self-Attention 解决了长距离依赖",这对你只是一条信息,不是一个领悟。
这套课用"因果链"替代它:先让问题出现,再让解法被逼出来。
| 传统教法 | 本课程 | |
|---|---|---|
| 开场 | "今天学 Self-Attention,它是 RNN 的优化" | "梯度每步乘 0.9,传 50 步后只剩 0.005,怎么让每个词直接看到所有词?" |
| 路径 | 分类 → 定义 → 公式 → 结论 | 问题 → 撞墙 → 尝试 → 再撞墙 → 逼出解法 |
| 你得到 | 记住层级关系 | 理解"为什么会需要它" |
第一性原理,是写这套课的约束:
- 不从"业界怎么做"讲起,从"为什么必须这样"讲起,每个设计都还原到它要解决的原始矛盾。
- 禁止把结论当公理,每个结论必须给出不这样做的后果。
- 推理链的起点是任务约束,不是"旧方案不行"。每课 6 步,步与步之间是"导致 / 要求 / 在什么条件下会破"的关系,不允许"正交插入"。
用因果链替代知识树之后,下面三条标准会反复出现(不是拍脑袋定的):
| 标准 | 解决的问题 | 本课程怎么做 |
|---|---|---|
| 问题驱动 | 不知道为什么要学 | 每张卡片以一个问题开头,让你先想 30 秒。例如第 21 课:「每一步都有 95% 是对的,为什么一个 10 步的任务经常做不完?」 |
| 计算走查 | 懂了概念,算不来 | 用最小的真实例子算到底。例如第 21 课:0.95¹⁰ ≈ 0.599,二十步只剩 0.358;第 17 课:4096×4096 的更新有 16,777,216 个数,LoRA(r=8)只学 65,536 个,压缩 256 倍;第 15 课:70B 模型每个 token 的 KV Cache 是 0.3125 MiB,8K 上下文就是 2.5 GiB |
| 冲突可见 | 记住解法,不知道代价 | 不只讲怎么做,还算不这么做的后果。例如第 17 课:可训练参数压到千分之几,65B 还是训不动,因为 130 GB 的冻结权重还在显存里 |
最近更新(2026-11-05)
- 每课一个独立网址。 34 课各有独立页面和标题(如
/lesson-7.html),正文直接写在 HTML 里,不执行 JS 也能被搜索引擎读到,可以直接把某一课的链接发给别人。 - 站内搜索支持"换个说法也能找到"。 在侧边栏输入一句话,比如"为什么不能一直用 LoRA""模型怎么知道词的顺序",会同时按关键词和语义找卡片;支持中英互通(
低秩适配↔LoRA)和错拼(tokenzier)。语义部分用 Cloudflare Workers AI 的 bge-m3 向量,关键词部分是 BM25。这句话会发到本站服务器算向量,不保存;可在页面里一键关闭。- 如实的数字:我手写了 85 条查询自测(其中 20 条是调参时没看过的留出集)。前 3 条命中率,留出集上纯关键词 50% → 混合 90%。样本小、标准答案是我自己标的,只能说明方向,不是严格基准。
- "继续上次阅读"。 回到网站时,侧边栏会出现上次读到的那张卡片,一键回去。位置只存在你的浏览器本地。
- 匿名使用统计,可关闭。 记录哪些课、哪些卡片被读了(只记次数和时长,不记你的提问和搜索词,不用 Cookie),用来决定下一步改什么。页面里有完整说明和关闭按钮。目前统计库还没开通,线上暂不会收到数据。
- 讨论区与订阅。 想提问或交流可以去 Discussions;想在新课上线时收到通知,见上文 Watch → Custom 的说明。
亮点
- 重来一遍,自己也能推导。 数字放在表格里,每步一个独立标题,从上一步自然导出,没有来路不明的魔法常数。
- 每张卡片走同一条认知链: 激活(先想 30 秒)→ 锚定(论文、年份、当时的痛点)→ 推导 → 升华(有 X 得 A,没有 X 得 B)→ 追问(每卡 5 条以上带数字的预设追问,也可以问卡内的 AI 助教)。
- 术语是主体,类比只是脚手架。 新术语首次出现紧跟白话定义;类比之后必须回到专业名词,否则你读不了论文和代码。
- 每张卡片自带 AI 助教。 学完卡片还有疑问,直接问,不用开新窗口、不用填 key,详见下一节。
- 如实公开质量。 生成管线有自动拦截,也公开拦不住的部分:独立盲审查出 186 条缺陷,详见下文。
AI 助教
课程里每张卡片底部都有一个只负责这张卡片的 AI 助教(点「💡 对这张卡片有疑问?点我开始对话」),每条预设追问下还有「💡 咨询 AI」,可以围绕这一条继续追问。
它和通用聊天机器人的区别:
- 知道你刚读了什么。 助教的上下文是这张卡片的完整正文(问题、背景、计算走查),不是整门课,也不是空白。它被要求不复述你已经读过的内容,而是往前推一步。
- 优先用具体数字回答。 问题适合计算时,就代入一个小例子把每一步算出来,和课程的"计算走查"风格一致。
- 会纠正误解。 发现你的理解偏了,会温和但明确地指出,并给出正确版本。
- 不联网,基于卡片内容回答。 需要查证的事实(论文归属、版本号、最新进展),它会直说"无法联网核实",只给有把握的部分。联网搜索我试过并验证可用,但在我的测试里单次耗时从约 1.8 秒变成约 4.5 秒,单次费用约为不联网的 40 倍(各只测了 1 次),所以目前关闭。
- 只教当前这张卡片。 超出本卡范围的内容,会先说明"这超出了本张卡片的范围",再给最小必要的解释,不硬答成确定结论。
- 公式能直接渲染。 回答里的公式用 KaTeX 显示,表格、小标题也会正常排版。
- 对话可控。 支持复制整段对话、清空、中途停止、重新生成;Enter 发送,Shift+Enter 换行。
不用填 key,但有额度限制:
| 限制 | 数值 |
|---|---|
| 全站每天(所有人加起来) | 100 次 |
| 每人每天 | 20 次 |
| 每人每分钟 | 5 次 |
| 重置时间 | 每天北京时间早上 8 点 |
| 模型 | DeepSeek Flash,已关闭思考模式,不联网 |
额度用完后助教会提示"稍后再试",其余课程内容不受影响。额度小是因为调用费用由作者承担,数字是我按成本设的初始值,之后可能调整。
国内访问: 助教请求发往 tutor.taleverse.cn(Cloudflare Workers,绑定自有域名)。起初用的 *.workers.dev 在我测试时被国内几家公共 DNS 解析到互不相同的地址,部分用户打不开,所以换成了自有域名。换域名后,我从自己的机器测到国内的阿里、腾讯 DNS 都返回 Cloudflare 的地址、HTTPS 0.44 秒通;但我无法从其他人的网络测试,运营商是否限速或阻断到 Cloudflare 海外节点的连接我不知道。遇到打不开,页面会在 30 秒后明确提示,课程正文不受影响,也欢迎开 Issue 告诉我你的网络环境。
课程内容
| 部分 | 课号 | 主题 |
|---|---|---|
| 一 · 认知衔接 | 1–6 | Transformer 回顾、模型结构全景、现代 Transformer 的五大改造、Tokenization、逐层解剖一个模型、从 Transformer 到 LLM 全景图 |
| 二 · 训练范式 | 7–12 | Scaling Laws 与算力预算、数据工程、预训练全流程、SFT、对齐、推理模型与 RLVR |
| 三 · 训练与推理工程 | 13–19 | 分布式训练、显存账本与混合精度、KV Cache 与推理内存、量化与压缩、微调工程、推理引擎、大模型评测 |
| 四 · Agent 工程 | 20–28 | 提示工程、从 Prompt 到 Agent、工具调用、MCP 协议、记忆与 RAG、规划与反思、多智能体与协议、Agent 训练、Agent 评测与生产化 |
| 五 · 自主研究 | 29–34 | 自主研究全景与自主度分级、文献锚定与选题、假设规划与搜索、长时程执行与状态、验证复现与评审、报告成本与责任 |
每课 6 张卡片,每张卡片带 5 条以上的预设追问,答案同样带表格和数字。
课程是怎么生成的(技术架构)
一、产物与源码
课程有两种产物:单文件版是一个自包含的 HTML(KaTeX 已内联,无 CDN,可离线打开,只有关键词搜索);多页站点版是 34 个独立页面,用于在线发布,多了全文与语义搜索。两者来自同一份源码。
src/lessons/manifest.json     课程映射表,唯一事实源(id = 课号)
src/lessons/lesson-<id>.html  每课正文(纯 HTML 片段,不手写转义)
src/shell.html                页面骨架 + 样式 + 全部 JS + AI 助教 + 部分课的追问数据
src/assets/                   KaTeX 的 CSS / JS(构建时内联)
scripts/build.py              组装:按 manifest 把每课正文 JSON 转义后填进 shell,内联 KaTeX
scripts/build_site.py         生成多页站点 site/:每课独立页面 + 共享 CSS/JS + 搜索索引 + sitemap
scripts/embed_docs.py         给搜索索引生成语义向量(调 Workers AI),结果存 src/search/
src/search/                   文档语义向量(238 KB),内容变了需重新生成,否则站点构建检查会失败
dist_course.html              单文件构建产物,禁止手改
设计取舍:不用前端框架、不引入构建链,改完即可看;单文件意味着拿到一个文件就能学。build.py --check 会校验产物与源码是否一致,并保证产物里没有外部资源引用。
二、生成流水线
每次新增或改动内容,走同一条流水线:
联网检索 → 设计推理链 → 写卡片(五阶段) → 逐条核验 → 机械门禁 → 独立盲审 → 差集/漏检率 → 构建发布
| 环节 | 做什么 |
|---|---|
| 联网检索 | 每轮先搜再答。涉及"某篇论文做了什么",先查一手来源再动笔,禁止凭模型记忆 |
| 设计推理链 | 先在纸面按因果链排 6 个问题,再写卡片 |
| 逐条核验 | 范围 = 每个主问题 + 每条追问,不抽样。每条断言先归类,再交给对应裁判(见下表),记入 9 列台账 |
| 机械门禁 | 脚本只管"有唯一答案"的事:结构、覆盖度、台账是否过期、渲染 |
| 独立盲审 | 另起一个信息隔离的审阅者(不许读我方台账),分"事实与算术""语义与逻辑"两路 |
| 差集 | 盲审独有的缺陷 = 我方漏检,必须补进台账;漏检率必须是显式数字 |
断言按类型路由,不是"全部丢给 python":
| 类型 | 裁判 | 举证要求 |
|---|---|---|
| 算术 | python3 独立复算 |
给出可复算的算式 |
| 事实 | 联网 + 一手来源 | 给链接,或写明"未找到" |
| 推导 | 反例 + 边界检验 | 写出边界条件或反例 |
| 经验数字 | 无裁判,只能标注 | 无一手来源只能标"估算",不得判通过 |
| 语义 | 只有人 | 写明所依据的规则条款 |
三、门禁
| 脚本 | 判什么 |
|---|---|
tools/content_verify.js |
每卡 7 大组件、div 配平、数字门禁、追问条数、桥接句、类比配额、标题四处一致 |
tools/verify.js(Playwright) |
布局重叠、溢出、对比度、768px 响应式、切课、控制台报错 |
tools/review_check.js |
台账覆盖度、断言覆盖(漏列一条断言就 FAIL)、类型路由、盲审是否做过 |
tools/provenance_check.js |
台账时效性:内容改过而台账未重核验 → FAIL |
tools/coverage_check.js |
覆盖地图归档与领域锚点是否落地 |
tools/crossscope_check.js |
跨课数值口径一致(同一量在不同课只能取同一值) |
tools/gate.js |
开工闸门:以上任一未清,只允许清账,不允许写新内容 |
交付标准:0 FAIL 且 0 WARN。每修完一个问题,追问一句"下次怎么自动拦住它?",能写成脚本的当场写进去。
四、AI 助教
- 每张卡片内嵌一个对话面板,系统提示注入本卡完整内容(问题 + 正文 + 计算块),不是整课。
- 约束三条:优先用具体数字例子、纠正可能的误解、不确定的诚实说明不编造。
- 前端不直连 DeepSeek,而是请求一个 Cloudflare Worker 代理(源码在
proxy/)。DeepSeek key 只存在 Worker 的 secret 里,前端和仓库里都没有。 代理负责:校验请求来源、固定模型和输出长度、关闭思考、按服务端设定开启联网搜索(单次最多搜 2 次)、限流(全站 100 次/天,每人 20 次/天、5 次/分钟)。 - 代理有 32 条单元测试(
cd proxy && node --test limiter.test.mjs worker.test.mjs),覆盖限流、来源校验、key 不外泄、请求清洗。测试用的是内存模拟的 Durable Object,没有在真实 Cloudflare 环境里覆盖全部情况。
目前做到了哪一步,哪里还不行
这还不是"AI 一键生成好课程"。 如实记录几个数字:
- 机械门禁全绿的时候,我对第 1–28 课做过一轮独立盲审(8 路并行、两视角、逐条联网),仍然查出 186 条缺陷(P0 10 条、P1 36 条)。
- 其中算术 0 处误算——门禁和复算确实守住了算术与结构。
- 缺陷集中在门禁原本不管的四类:推理链正交插入、提示泄题 / 主问题预设结论、跨课口径冲突、正文里没有一手来源的读数。
- 第 1 课反复做独立盲审,我方自查的漏检率第一轮是 29%(盲审 31 条里我漏了 9 条),第二轮是 33%(6 条里漏 2 条)。盲审换一个角度,仍然能查出自查看不见的问题。
- 盲审本身也会漏,且与生成方常是同族模型,能发现"认真点就能看见的错",发现不了"我们都不知道的错"。
所以现在的结论是:脚本能守住有唯一答案的事(算术、结构、覆盖度),语义和品味判断仍然需要人。"一键生成"离可用还有距离,这正是我想继续探究的部分。
想听你的意见
- 你读完一张卡片后,能不能真的在白板上推出来?卡在了哪一步?
- 哪些地方的"类比"帮到了你,哪些反而干扰了你?
- 你发现的错误:数字、论文归属、版本、口径不一致。
- 推理链的顺序是否自然?有没有"这一步为什么接这一步"想不通的地方?
- 对"让 AI 生成高质量课程"这件事,你觉得缺的是什么:更强的模型、更好的评审、还是人在回路里?
提意见的方式:到本仓库开 Issue。 麻烦写清位置,例如"第 4 课第 2 张卡片,追问 3",并附上你认为不对的原文和理由,我会逐条核实。不需要会写代码。
本地构建
python3 scripts/build.py          # 生成 dist_course.html(只需 Python 3,无第三方依赖)
python3 scripts/build.py --check  # 校验产物与源码一致
python3 scripts/build_site.py     # 生成多页站点 site/(本地预览:cd site && python3 -m http.server)
python3 scripts/build_site.py --check   # 校验 site/ 与源码一致,语义向量陈旧会失败
node tools/content_verify.js --src   # 内容层门禁(零依赖)
npm install && npx playwright install chromium && node tools/verify.js   # 渲染层
关于校验脚本的可运行范围:review_check.js、provenance_check.js、coverage_check.js 依赖作者本地的逐条核验台账与覆盖地图,这些未随仓库公开,克隆后无法运行,仅供参考其校验思路。build.py、content_verify.js、verify.js 在干净克隆里实测可直接运行。
目录
| 路径 | 内容 |
|---|---|
src/ |
课程源码:lessons/(34 课正文 + manifest)、shell.html、assets/ |
scripts/ |
构建脚本(单文件版、多页站点版、语义向量生成) |
tools/ |
校验脚本 |
proxy/ |
Cloudflare Worker:AI 助教代理、语义搜索 /s、匿名统计 /e(含单元测试) |
.trae/rules/ |
课程设计方法论与内容规则(上面"理念"一节的完整版) |
.trae/skills/ |
生成、质检、盲审、构建的操作流程(给 AI 助手读的 SKILL) |
许可
MIT License。可自由使用、修改、转载,保留版权声明即可。
Yorumlar (0)
Yorum birakmak icin giris yap.
Yorum birakSonuc bulunamadi